2.1 并行编程模型与语言
2.1 并行编程模型与语言
本节摘要:并行编程模型定义了多个计算单元怎么协同。HPC 里有三大主流:MPI(消息传递接口)用于分布式内存的节点间通信,是超算的事实标准;OpenMP 用于共享内存的节点内线程级并行,编程简单;CUDA 用于 GPU 异构计算,榨取海量线程的数据并行能力。本节讲清三者的机理、典型用法、适用场景,以及它们在现代 HPC 里的分工搭配。
先说结论
阅读完本节,你应当能够:
- 区分 MPI、OpenMP、CUDA 三大模型的定位
- 说清消息传递、共享内存线程、GPU 线程的编程范式差异
- 为不同硬件和任务选对编程模型
- 解释为什么现代 HPC 程序常是三者的混合
一、问题与直觉
写过串行程序的人第一次面对并行,最强烈的感受是"怎么开始"。串行程序是一条指令接一条指令往下走,思路清晰;并行程序突然要多出"谁先谁后、数据怎么分、要不要等"这些问题,没有合适的抽象会很痛苦。
并行编程模型就是为你提供这些抽象的。它把底层的硬件细节(多核、网络、GPU 线程)藏起来,给你一套统一的"怎么表达并行"的接口。选对模型,并行程序写得像串行一样自然;选错模型,会跟硬件较劲到怀疑人生。
三大模型 MPI、OpenMP、CUDA 各自来自不同的硬件时代、解决不同的问题,它们的分工至今没被任何一个统一框架替代。理解它们各自的"性格",是写好 HPC 程序的前提。
二、核心原理
2.1 MPI:分布式内存的消息传递
MPI(Message Passing Interface)是分布式内存系统的编程标准。在分布式内存里,每个进程有私有内存,进程间靠显式发送和接收消息来交换数据。MPI 提供了一套丰富的消息传递原语:点对点的发送接收、集合通信(广播、归约、收集、散播)、同步屏障等。
MPI 的核心抽象是"进程加消息"。程序员显式控制数据在进程间的流动,这给了极大的灵活性,也带来了编程复杂度——你得想清楚谁发给谁、发什么、什么时候发、怎么避免死锁。
MPI 是超算的事实标准,因为它天然适合分布式内存的大规模集群。几乎所有跑在超算上的科学计算代码,底层都用 MPI 做节点间通信。它的代价是编程心智负担重——一个典型的 MPI 程序要管理进程拓扑、通信模式、数据分布,调试也比串行难得多。
MPI 的 API 设计有一个核心区分值得记住:阻塞通信和非阻塞通信。阻塞调用(MPI_Send、MPI_Recv)在数据安全送达或缓冲之前不返回,写起来直观但容易死锁——两个进程互相等对方先收,谁也不动。非阻塞调用(MPI_Isend、MPI_Irecv)立即返回一个请求句柄,让发送方可以继续算别的,稍后再用 MPI_Wait 确认完成。这个区分不是 API 风格问题,而是性能关键:非阻塞通信让计算和通信重叠,是把延迟"藏"起来的主要手段。一个写得好的 MPI 程序,会用非阻塞通信在等待数据的同时推进本地计算,把通信开销几乎完全吸收掉。
集合通信(collective)是 MPI 的另一组核心原语,值得单独提。MPI_Bcast 把一份数据广播给所有进程,MPI_Reduce 把各进程的局部结果归约成全局结果,MPI_Allreduce 让所有进程都拿到归约结果。这些原语内部由 MPI 实现做了高度优化(比如树形或环形算法),自己手写循环发点对点消息几乎肯定更慢。一个常见的性能反模式:明明可以用 MPI_Allreduce,却写成一堆 MPI_Send/MPI_Recv,结果通信步数从对数级变成线性级,大规模下慢几十倍。
2.2 OpenMP:共享内存的线程级并行
OpenMP 是共享内存系统的编程标准。它通过编译制导指令(pragma)让程序员在串行代码里标注"这段循环可以并行",编译器自动把它展开成多线程执行。
OpenMP 的核心抽象是"fork-join":程序默认单线程执行,遇到并行区域时派生出多个线程并行工作,并行区域结束后再汇合回单线程。程序员不用手动管理线程创建和销毁,只需要标注哪里能并行、数据怎么共享或私有。
| 维度 | MPI | OpenMP |
|---|---|---|
| 内存模型 | 分布式,私有 | 共享,统一 |
| 通信方式 | 显式消息 | 隐式读写共享变量 |
| 编程复杂度 | 高 | 低(制导指令) |
| 扩展性 | 好(上万进程) | 差(几十线程) |
| 典型硬件 | 集群、超算 | 多核 CPU、单节点 |
OpenMP 的优势是编程简单——在已有串行代码上加几行制导指令就能拿到多核加速,这对遗留科学代码的并行化特别友好。代价是扩展性受限于共享内存的规模,一般在单节点内(几十核)有效。
OpenMP 写起来简单,但要拿到性能有几个坑。第一个是 private 和 shared 的区分。默认情况下循环外的变量在并行区是共享的,如果多个线程同时写它就会数据竞争,结果不确定。把循环变量和临时中间量标成 private 是新手最容易漏的一步。第二个坑是 false sharing(伪共享):两个线程各自写不同的变量,但这两个变量恰好在同一个缓存行上,硬件为了保证一致性会让缓存行在两个核之间反复失效,性能掉得很惨却看不出来。解决办法是给频繁写的变量做缓存行对齐填充。
第三个坑是 NUMA 亲和性。OpenMP 默认不保证线程绑在固定的核上,操作系统可能把线程在核间迁移,导致它访问的总是"远端"内存。规模一上来,这种迁移就让性能莫名下降。生产代码里通常显式设置 OMP_PROC_BIND 和 OMP_PLACES,把线程钉在固定核上,并让首次触碰数据的线程和后续访问它的线程是同一个——这叫"首次触碰"策略,让数据物理上落在访问它的那个 NUMA 节点。这几行环境变量配置,性能差距能到两三倍。
2.3 CUDA:GPU 异构计算
CUDA 是 GPU 异构计算的编程模型(类似的还有跨平台的 OpenCL、SYCL)。它把 GPU 看作一个能执行海量轻量线程的协处理器,程序员写"核函数"(kernel)描述单个线程的行为,然后启动成千上万个线程实例并行执行。
CUDA 的核心抽象是"网格加块加线程"的层次结构:一个核函数启动一个网格,网格分成多个块,每个块含多个线程。这种层次映射到 GPU 的硬件层次(流多处理器加 CUDA 核心),让程序员能控制数据局部性和同步粒度。
GPU 编程的关键挑战是让算法适应它的执行模型:数据要能展开成海量并行、内存访问要合并(coalesced)以利用高带宽、要尽量减少分支(分支会导致线程束分化,部分线程空转)。一个为 GPU 优化的算法和为 CPU 写的版本可能差别很大。
合并内存访问这条规则值得展开。GPU 上一个线程束(warp,通常 32 个线程)是同步执行的,如果它们访问的内存地址是连续的、对齐的,硬件能用一次事务把整束的数据取回来,带宽跑满;如果地址散乱,硬件得发起多次事务,带宽利用率可能掉到十几分之一。同样一段计算,把数据按"结构数组"布局改成"数组结构"(让同类字段连续存放),性能能差好几倍——这种改动在 CPU 上几乎看不出影响,在 GPU 上是决定性的。这也是为什么 GPU 代码不能直接搬 CPU 算法,得围绕访存模式重新组织数据。
线程束分化是另一个隐形成本。一个 warp 里的 32 个线程如果走了不同的 if/else 分支,硬件只能让一部分线程执行、另一部分空转,等这个分支走完再反过来。极端情况下,分化让 GPU 的有效并行度掉到三十二分之一,性能比 CPU 还差。GPU 编程的一条经验是:尽量让一个 warp 内的线程走相同分支,把数据按某种特征排序让相似的元素聚在一起,或者干脆把分支密集的逻辑挪回 CPU。
Grid 和 block 的尺寸选择也直接影响性能。Block 太小,单个流多处理器上的 warp 数不够,没法用线程切换来掩盖访存延迟;Block 太大,寄存器不够分,反而触发寄存器溢出到本地内存,性能断崖式下降。经验上,block 大小通常取 128 或 256,再根据 kernel 的寄存器占用做微调。这些参数没有放之四海皆准的值,要靠 occupancy 计算器和 profiler 反复试。
2.4 三者的分工搭配
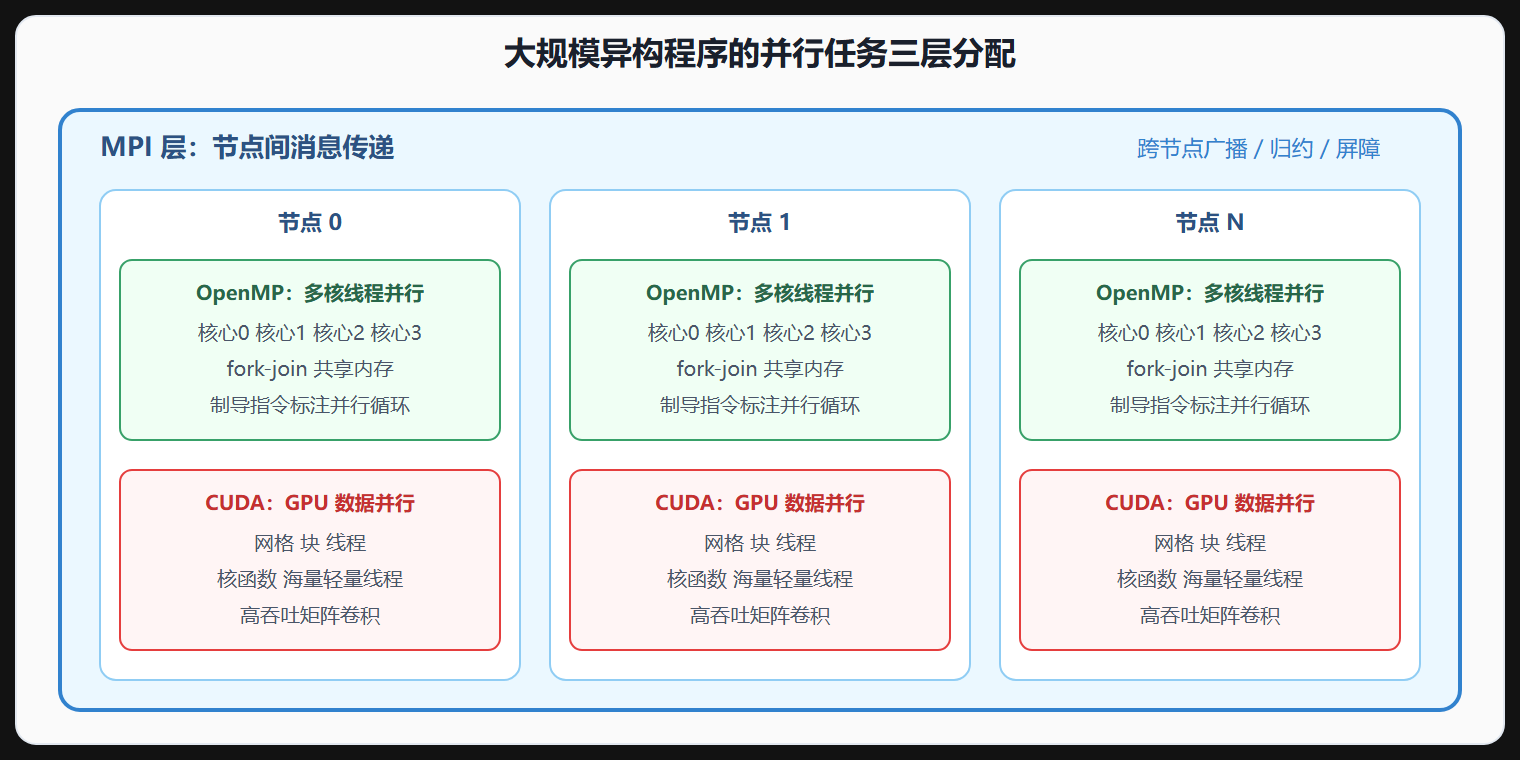
现代 HPC 程序常是三者的混合:MPI 负责节点间通信,OpenMP 负责节点内多核并行,CUDA 负责 GPU 加速。这种"MPI 加 OpenMP 加 CUDA"的三层结构,对应了"分布式加共享加异构"的三层硬件。
| 层 | 硬件 | 编程模型 | 职责 |
|---|---|---|---|
| 节点间 | 集群网络 | MPI | 跨节点通信 |
| 节点内 | 多核 CPU | OpenMP | 多核线程并行 |
| 加速器 | GPU | CUDA | 数据并行加速 |
图 MPI 加 OpenMP 加 CUDA 的三层分工架构
三、工程实践要点
3.1 选模型的简单准则
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| 单节点多核、遗留代码 | OpenMP | 加制导指令即可,改造成本低 |
| 多节点集群、超算 | MPI | 分布式内存的事实标准 |
| 数据并行、计算密集 | CUDA | GPU 海量线程高吞吐 |
| 大规模异构超算 | MPI 加 OpenMP 加 CUDA | 三层分工 |
💡 关键直觉:选编程模型的心法是"匹配硬件层次"。你的瓶颈在节点间通信就上 MPI,在节点内多核就上 OpenMP,在数据并行计算就上 CUDA。很多新手在单节点多核上硬用 MPI,结果消息传递的开销比计算还大——这种场景 OpenMP 更合适,因为共享内存免去了显式通信。
3.2 学习曲线和投入产出
三个模型的学习曲线差异很大。OpenMP 最平缓——几行制导指令就能上手,适合快速给串行代码加速。MPI 中等——要理解进程、通信、同步这些概念,但接口相对规范。CUDA 最陡——除了编程模型,还要理解 GPU 硬件架构、内存层次、执行模型才能写出高效代码。
投入产出也要看场景。如果只是给一个遗留 Fortran 代码做多核加速,OpenMP 几天就能见效;如果要写一个跑在超算上的大规模仿真,MPI 是必须投入的;如果要榨 GPU 的性能做深度学习,CUDA(或更高层的框架)绕不开。
3.3 调试和可移植性
⚠️ 常见坑:低估并行程序的调试难度。串行程序的 bug 是确定性的,同样的输入总复现;并行程序的 bug 常是竞争条件(race condition)或死锁,依赖时序,难复现。MPI 程序的死锁、OpenMP 的数据竞争、CUDA 的内存越界,每一类都要专门的调试工具和技巧。别指望用串行的调试思路搞定并行 bug,要有专门的并行调试器(如 gdb 的 MPI 扩展、CUDA 调试器)和耐心。
可移植性是另一个考量。OpenMP 和 MPI 是跨平台标准,同一份代码在不同厂商的硬件上基本能跑(性能可能不同)。CUDA 是厂商特定的(只支持特定 GPU),要跨平台得用 OpenCL 或 SYCL。如果你的代码要在多种硬件上长期维护,优先选跨平台标准。
重点提炼
- MPI 用于分布式内存节点间通信,是超算事实标准,编程复杂但扩展性好。
- OpenMP 用于共享内存多核并行,制导指令简单,适合遗留代码加速,扩展性受限于单节点。
- CUDA 用于 GPU 异构计算,海量轻量线程高吞吐,但要为 GPU 重写算法。
- 现代 HPC 常是三者混合:MPI 节点间、OpenMP 节点内、CUDA 加速器。
- 选模型匹配硬件层次:别在单节点多核上硬用 MPI,调试难度别低估。
下一节讲怎么把串行算法拆成可并行的形式——分治、 reductions、数据分布这些核心技巧。