3.1 性能分析、调试与调优
3.1 性能分析、调试与调优
本节摘要:一个能跑的并行程序,真实效率可能只有硬件峰值的百分之几,剩下的全耗在看不见的地方。本节讲清怎么用性能分析工具(profiler)定位三类瓶颈——计算瓶颈(算力没吃满)、内存瓶颈(带宽或缓存没用好)、通信瓶颈(同步和传输拖后腿),以及针对每类的优化手段(向量化、缓存优化、通信隐藏),最后说清强扩展性曲线怎么读、怎么用它判断瓶颈类型。
上手前先明确
阅读完本节,你应当能够:
- 用 profiler 定位并行程序的瓶颈类型
- 区分计算、内存、通信三类瓶颈的优化方向
- 读强扩展性曲线判断瓶颈在哪
- 避免过早优化和盲目优化
一、问题与直觉
很多人写完并行程序,测一下发现"咦,用了八个核怎么只快了两倍",然后就懵了。问题不在程序写错,而在于并行程序的性能损耗往往藏在看不见的地方:CPU 在等内存送数据、节点在等网络传消息、有些核在等其他核算完。这些"等待"不会报错,只会让效率悄悄下降。
要找出这些隐藏的损耗,光靠读代码和猜是不行的,得上性能分析工具(profiler)。profiler 能告诉你程序的时间花在哪了:是花在计算上、花在内存访问上、还是花在通信上。拿到这个分布,你才知道该往哪个方向优化。盲目优化常导致花了大力气却没效果——因为优化的不是瓶颈。
不同类型的 profiler 看的是不同层面的东西。采样型 profiler(如 Intel VTune、ARM Forge、NVIDIA Nsight Systems)周期性打断程序、记录调用栈,开销小、能看到真实运行情况,适合找宏观热点。插桩型 profiler(如 TAU、Score-P)在每个函数入口出口插桩,数据精细但开销大,适合精细分析。MPI 专用的 profiler(如 Vampir、Paraver)能可视化每个进程的通信时序,找死锁和通信瓶颈。GPU 的 profiler(Nsight Compute)能下钻到单个 kernel 的访存模式、占用率。选对工具,省下大量盲调的时间。一个常见错误是用错了 profiler 层面——比如用采样 profiler 去找通信死锁,或者用 Nsight Systems 去分析单个 kernel 的寄存器占用——这就像用望远镜看细菌,工具选错再努力也白搭。
并行程序的调优,本质就是"定位瓶颈、消除瓶颈"的循环。这一节讲清三类瓶颈的特征和对应手段,让你拿到 profiler 报告后知道下一步做什么。
二、核心原理
2.1 三类瓶颈
并行程序的性能损耗主要来自三类瓶颈:
| 瓶颈类型 | 表现 | 原因 |
|---|---|---|
| 计算瓶颈 | CPU 利用率低、向量化不足 | 算法没充分利用算力 |
| 内存瓶颈 | 带宽吃满、缓存命中低 | 数据访问模式差 |
| 通信瓶颈 | 大量时间在同步和传输 | 消息太多或太大 |
2.2 计算瓶颈
计算瓶颈是指 CPU 的算力没被充分吃满。常见原因:循环里没向量化(明明可以用 SIMD 指令一次算多个数据,却一个个串行算)、分支太多导致流水线停顿、指令级并行度低。优化方向是让编译器能向量化(简化循环体、消除分支依赖)、手动写 intrinsics 或用 GPU。
计算瓶颈相对好诊断——profiler 会显示 CPU 利用率低或浮点吞吐率远低于峰值。但要注意,有时候 CPU 利用率高不等于计算效率高:CPU 可能在"忙等"内存(内存瓶颈伪装成 CPU 忙)。
2.3 内存瓶颈
内存瓶颈是现代 HPC 程序最常见也最隐蔽的瓶颈。CPU 的算力增长远快于内存带宽,导致很多程序其实是"内存受限"的——CPU 在等数据。常见原因:缓存命中率低(数据访问模式不规则,每次都要从主存取)、带宽吃满(数据量太大,搬不过来)。
优化内存瓶颈的核心是提高数据局部性:让数据在被缓存时被反复使用(时间局部性),让相邻数据被一起访问(空间局部性)。具体手段包括循环变换(如循环交织、分块)让访问顺序适配缓存行、数据布局调整(如结构数组改成数组结构)、分块(tiling)让工作集装进缓存。
量化"内存墙"有一个简单办法:算"算术强度"(arithmetic intensity),也就是每字节数据做多少次浮点运算。一个矩阵乘法每读一字节约做两次浮点运算,算术强度是 2;一个向量加法每字节约做 0.25 次运算,算术强度是 0.25。把算术强度和硬件的"屋顶线"(roofline,即峰值算力除以峰值带宽)对比:算术强度高于屋顶线拐点的,是计算受限,优化方向是榨算力;低于拐点的,是内存受限,优化方向是提高算术强度。这个"屋顶线模型"用一张图就能定位程序瓶颈,是判断计算瓶颈还是内存瓶颈的最快工具。
分块(tiling)是内存受限程序最常用的优化手段。原理是把一个大循环切成小块,让每块的工作集刚好装进某级缓存,反复在缓存里算完再换下一块。一个 naive 的三重循环矩阵乘法,最内层要反复从主存取数;切成块大小为 B 的子矩阵后,每个子块只在缓存里取一次,能被 B 次计算复用。块大小 B 的选择很讲究:太小复用率低,太大装不进缓存触发驱逐。经验上 B 取缓存能容纳的矩阵边长,比如 64 或 128,具体要结合缓存大小和矩阵元素大小算。这个参数几乎没有"通用最优值",要靠 profiler 在不同 B 值上扫一遍找拐点。
数据布局调整也是常被低估的优化。把"结构数组"(每个对象是一个 struct,连续存放)改成"数组结构"(每种字段一个数组,连续存放),能让同类字段的访问在内存里连续,提高缓存行利用率和向量化效率。这种改动在 CPU 上有收益,在 GPU 上几乎是必需的(前面讲过合并访存)。但它会让代码可读性下降、面向对象的设计被打乱,是典型的"性能换可维护性"的取舍。
| 手段 | 作用 | 适用 |
|---|---|---|
| 循环分块 | 让工作集装进缓存 | 矩阵运算 |
| 数据布局调整 | 提高访问连续性 | 结构体数组 |
| 数据预取 | 提前取数据 | 可预测访问模式 |
2.4 通信瓶颈
通信瓶颈在分布式程序里很突出。表现是大量时间花在同步屏障、消息传输上,而不是计算。常见原因:消息太频繁(每次发一小段,启动延迟累积)、消息太大(带宽吃满)、同步太多(所有节点得等最慢的)。
优化方向是第 2 章讲的通信开销模型推导出来的:聚合小消息减少启动延迟、块传输提高带宽利用、用异步通信重叠计算和通信、减少全局同步改用局部同步。
诊断通信瓶颈有个实用技巧:看 profiler 时间线里"空闲段"的分布。如果一个进程在多个时间点出现整段空闲、前后都伴随通信事件,那它就是在等数据或等同步。把这些空闲段累计起来占总时间的比例,就是通信瓶颈的"上限"——再怎么优化计算也突破不了这个上限,必须从通信入手。MPI 专用的 profiler(如 Paraver)能把每个进程的时间线画成色带,一眼看出谁在算、谁在等,比看平均数字直观得多。
通信瓶颈还有一个隐性来源:负载不均伪装成通信问题。如果某个进程算得慢,其他进程在同步点等它,profiler 显示的是"通信等待",但根因是负载不均。这时单纯优化通信(聚合消息、改异步)没用,得先解决那个慢进程的计算量。这就是为什么调优要先定位根因,而不是看到"通信多"就盲目减通信。这种根因排查没有捷径,靠的是经验加工具配合。
2.5 读强扩展性曲线
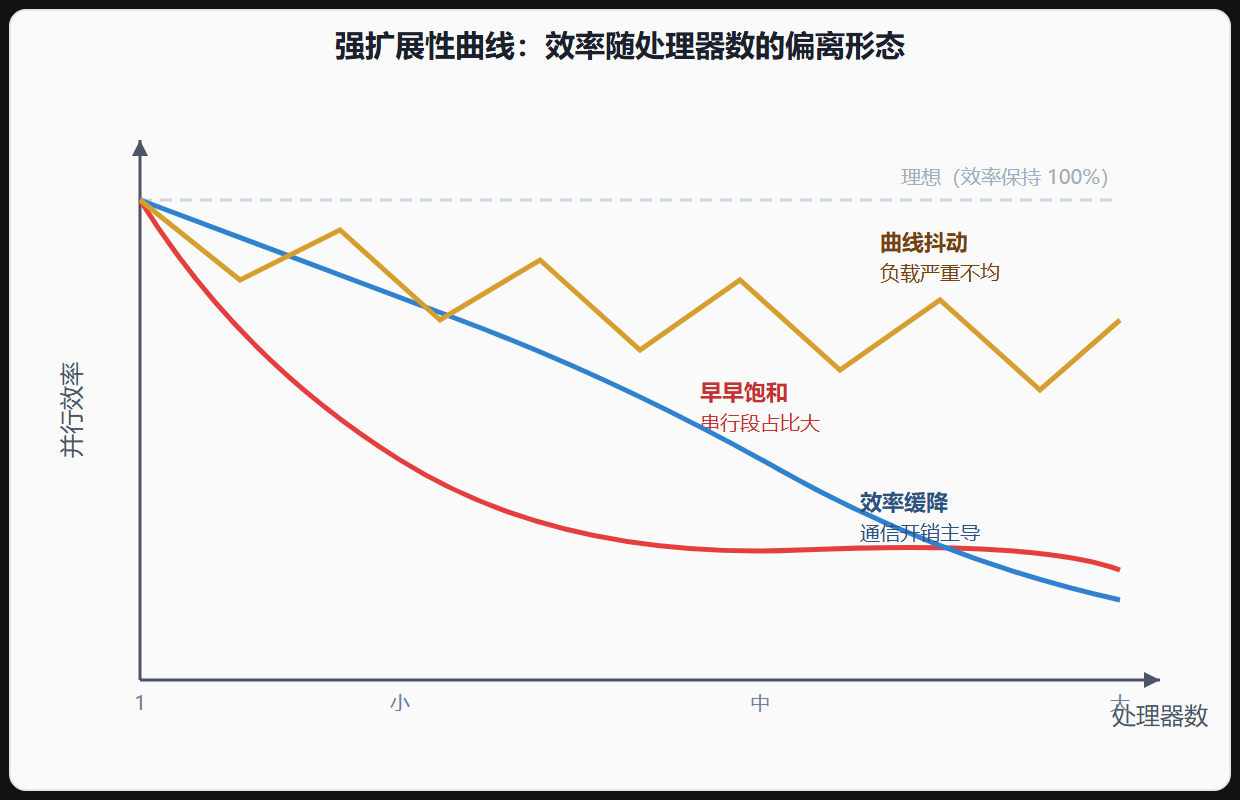
强扩展性曲线(处理器数对时间或效率的图)是诊断瓶颈类型的利器。理想曲线是时间随处理器数线性下降、效率保持不变。实际曲线会偏离理想,偏离的方式暗示瓶颈:
早早饱和(加几个核就不提速了)说明串行段占比大(阿姆达尔瓶颈);效率随规模稳定下降说明通信开销主导;曲线不规律抖动说明负载不均。读懂数据,才知道往哪个方向调。
图 强扩展性曲线的三种偏离形态
三、工程实践要点
3.1 调优的循环
并行调优不是一次性的,是个循环:测(用 profiler 跑)、定位(找最大瓶颈)、优化(针对性改)、再测(看效果)。每一轮集中火力打最大的瓶颈,直到性能达标或投入产出不再划算。
💡 关键直觉:调优的本质是"抓主要矛盾"。一个并行程序的性能损耗,往往百分之八十集中在百分之二十的代码里。profiler 帮你找到那百分之二十,集中优化它们收益最大。把时间平均撒在所有代码上,是低效的调优方式。
3.2 优化手段的优先级
不同瓶颈的优化难度和收益不同,优先级一般是:算法层大于系统层大于微调。先看算法本身能不能减少计算量或通信量(比如用更优的数学方法、改变数据分布),这层收益最大;再看系统层(向量化、缓存优化、通信隐藏),收益中等;最后才是微调(指令调度、寄存器分配),收益递减。别在微调上花大力气,除非前两层已经做到位。
3.3 可复现性和噪音
⚠️ 常见坑:调优时只测一两次就下结论。并行程序的性能受系统噪音影响很大——其他用户的作业、操作系统的调度、网络波动都会让每次运行时间波动。单次测量的结果可能完全是噪音。规范的调优要多次测量取统计值(中位数或最小值),并在相近条件下对比,否则你可能在"优化噪音"而不是真实性能。
温故知新
- 三类瓶颈:计算(算力没吃满)、内存(带宽缓存差)、通信(同步传输拖后腿),内存瓶颈最常见最隐蔽。
- 用 profiler 定位最大瓶颈再优化,别盲目平均用力,抓主要矛盾。
- 优化优先级:算法层大于系统层大于微调,先改算法再调系统最后微调。
- 内存瓶颈靠提高局部性:循环分块、数据布局、预取。
- 强扩展性曲线是诊断利器:早早饱和是串行段、效率下降是通信、抖动是负载不均;多次测量防噪音。
下一节看让程序跑起来的基础设施——HPC 软件栈和集群管理。