3.2 HPC软件栈与集群管理
3.2 HPC软件栈与集群管理
本节摘要:并行程序要跑在集群上,离不开一整套软件基础设施。本节讲清 HPC 软件栈的核心组件:作业调度系统(SLURM 等,管理谁什么时候用多少资源)、并行文件系统(Lustre、GPFS,支撑海量数据的并发读写)、容器化部署(Singularity 等,解决环境可复现)、环境管理(模块系统,管理多版本编译器和库)。读完你会理解一个 HPC 集群是怎么把用户的并行作业调度起来并保证可复现运行的。
本节导读
阅读完本节,你应当能够:
- 说清作业调度系统在 HPC 集群里的角色和工作流程
- 解释并行文件系统为什么是 HPC 的必需品
- 理解容器化对 HPC 环境可复现的意义
- 用模块系统管理多版本的编译器和库
一、问题与直觉
假设你写好了一个并行程序,想在一个有一千个节点的集群上跑。你直接登录某个节点、启动程序——结果发现:别人也在用这个节点、你的程序需要的库版本不对、要读的数据文件分散在好几个节点上、跑完的结果没法高效写回存储。这一连串问题,光靠你自己解决不了。
这就是 HPC 软件栈要管的事。一个生产级 HPC 集群不是把一堆服务器连起来就完事,它需要一套软件基础设施来管理资源、调度作业、提供存储、保证环境一致。这些基础设施对用户是半透明的——你提交作业、等结果,中间的调度和存储细节被软件栈处理了。但理解它们怎么工作,能让你更高效地用集群,也能在出问题时知道往哪查。
这一节讲清四个核心组件:作业调度、并行文件系统、容器化、环境管理。它们是 HPC 运维的基石。
二、核心原理
2.1 作业调度系统
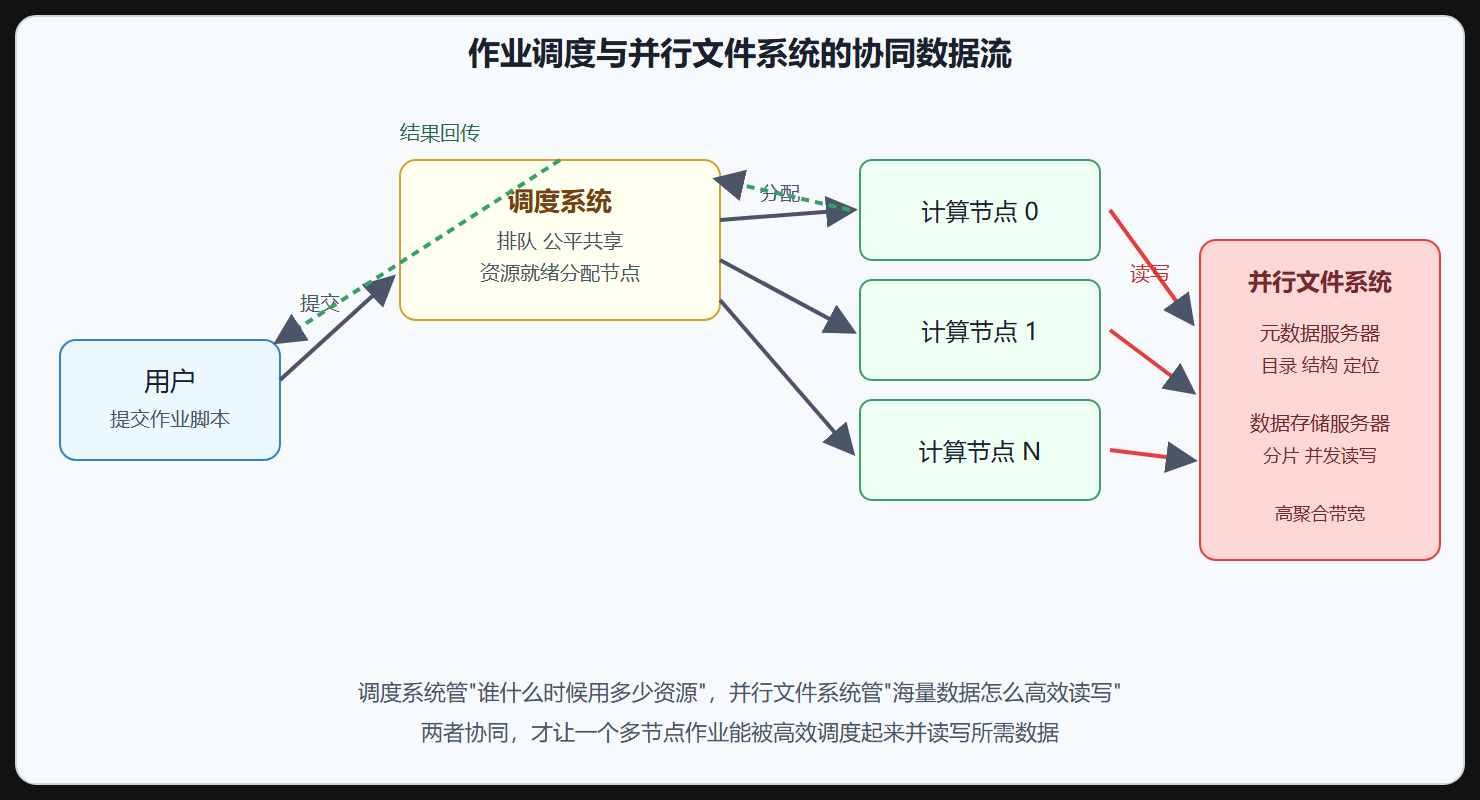
HPC 集群是共享资源——几十上百个用户同时提交作业,但节点有限,得排队。作业调度系统(最常见的是 SLURM)负责管理这个排队和分配。
调度系统的核心工作是:接收用户提交的作业请求(要多少节点、多少时间、什么类型的资源),按某种策略(公平共享、优先级、回填)排队,资源就绪时分配节点启动作业,作业结束回收资源。它还处理作业依赖、阵列作业、交互式作业等复杂场景。
对用户来说,理解调度系统的关键是用好它的资源请求——请求太多资源会排很久的队(因为要等那么多节点都空闲),请求太少又不够用。合理估算自己作业的资源需求,是高效用集群的第一步。
调度策略里有一个值得专门说的概念:回填(backfilling)。调度器按优先级排队时,如果队首的大作业一时拿不到那么多节点,调度器不会让所有节点空等,而是从队列后面找一些"小而短"的作业塞进空闲时段,前提是这些小作业能在队首大作业凑齐资源前结束、不影响它启动。这个机制能显著提高集群利用率,但对用户提出了要求:提交作业时必须如实填估计时间,填得太长调度器不敢回填你,填得太短超时被杀。老练的用户会把估计时间填得略大于真实运行时间(比如多留 10% 到 20%),既不被杀又尽量让调度器愿意回填。
另一个常被忽视的维度是分区和 QoS(服务质量)。很多集群按节点类型分了分区(CPU 分区、GPU 分区、大内存分区),也按用户身份设了不同的 QoS(付费用户优先级高、教学用户优先级低)。提交作业时选错分区或 QoS,要么排不进去要么浪费配额。新手常犯的错是默认用一个分区跑所有作业,结果 GPU 作业排不进 GPU 分区、内存不够被杀。熟悉集群的分区策略和自己的 QoS 配额,是用好集群的基本功。
图 作业从提交到完成的数据流拓扑
2.2 并行文件系统
HPC 作业要读写海量数据(气候模拟的中间结果、基因测序的原始数据、训练大模型的检查点),单个节点的本地存储根本装不下,也撑不住多节点并发读写的带宽需求。并行文件系统(如 Lustre、GPFS、BeeGFS)就是为此设计的。
并行文件系统把数据分散存储在多个存储节点上,允许多个计算节点并发读写不同部分,从而提供远超单机的聚合带宽。它的核心设计是"数据分散加元数据集中"——文件的实际数据块分布在多个存储服务器(OSS)上,而文件的元数据(目录结构、文件大小、数据块位置)由独立的元数据服务器(MDS)管理。
| 特性 | 普通文件系统 | 并行文件系统 |
|---|---|---|
| 聚合带宽 | 受单机限制 | 多节点并发,高带宽 |
| 扩展性 | 差 | 加存储节点就加容量和带宽 |
| 典型用途 | 单机存储 | HPC 集群共享存储 |
用并行文件系统的关键技巧是"大块读写"——小文件多、频繁小写入会让元数据服务器成为瓶颈。HPC 作业通常把中间结果攒成大块再写,或者用专门的并行 IO 库(如 MPI-IO、HDF5)来优化读写模式。
并行文件系统里有一个性能陷阱:元数据服务器(MDS)是单点瓶颈。创建文件、列目录、查询文件属性这些"元数据操作"都要走 MDS,它的处理能力是有限的。一个作业如果生成上百万个小文件,MDS 会先于存储带宽被打爆——表现为文件创建慢得离谱,但实际数据量并不大。这就是为什么 HPC 作业要尽量少创建文件、多写大数据块。一个典型反例是机器学习训练把每个样本存成一个小图片文件,上千万张图直接喂给并行文件系统,会拖慢整个集群。正确做法是把样本打包成大文件(如 TFRecord、HDF5),顺序读出来在内存里解析。
存储层级在 HPC 里也很重要。一台典型集群有三层存储:高速的本地 NVMe(节点内,秒级访问)、中速的并行文件系统(集群共享,分钟级持久)、慢速的归档存储(磁带库,小时级但极便宜)。合理的作业会把频繁读写的数据放本地 NVMe,把最终结果写并行文件系统,把长期不用的数据归档。把所有数据都堆在并行文件系统上,既慢又贵。
MPI-IO 是个值得专门提的工具。它是 MPI 标准的一部分,让多个进程协同读写同一个文件——每个进程只写自己负责的那一部分,由 MPI-IO 实现合并成高效的大块 IO。自己写循环让每个进程独立打开文件、定位、写,会触发大量元数据操作和小写入;用 MPI-IO 一行调用就搞定,性能能差好几倍。HDF5、Pnetcdf 这些更上层的库都基于 MPI-IO,写并行 IO 时优先选它们,而不是从裸文件接口开始造轮子。
2.3 容器化部署
HPC 程序的依赖复杂——特定版本的编译器、数学库、CUDA 运行时、MPI 实现。不同作业可能需要不同版本,直接装在节点上会冲突。容器化(HPC 领域常用 Singularity 或 Apptainer,而非 Docker)解决了这个问题:把程序和它的全部依赖打包成一个镜像,在任何节点上以一致的环境运行。
容器化对 HPC 的核心价值是"可复现"——今天跑的结果,半年后用同一个镜像还能复现。这对科学计算的可信度至关重要。HPC 容器和无状态的 Docker 容器不同:Singularity 设计上更适配 HPC(支持 MPI、尊重节点上的用户权限、不运行常驻守护进程),所以在超算上更受青睐。
2.4 环境管理:模块系统
不是所有场景都需要容器。轻量级的环境管理用模块系统(Lmod 或 Environment Modules):它允许同一个节点上安装多个版本的编译器、库、工具,用户用一条命令加载需要的版本。
模块系统的核心是"环境变量切换"——加载一个模块就是设置相关的路径和环境变量,卸载就是还原。这比容器轻,适合简单的环境切换,但不如容器那么彻底(系统库还是共享的)。实际 HPC 使用中,模块和容器常搭配:模块管理日常的开发工具,容器管理复杂的应用部署。
三、工程实践要点
3.1 合理请求资源
💡 关键直觉:用集群最大的技巧是"精准请求资源"。请求太多节点会排很久的队(等那么多节点都空闲),请求太少跑不动或超时被杀。先用小规模测试估算单节点的内存和算力需求,再按规模放大请求,留出安全余量。调度系统的计费通常按"节点数乘时间"算,浪费资源等于浪费机时配额。
3.2 IO 优化
HPC 作业的性能瓶颈常出在 IO 上——特别是检查点读写、中间结果落盘。并行文件系统虽然提供了高聚合带宽,但用不好仍会慢。几个实用技巧:用大块读写而非小文件频繁写;用并行 IO 库(MPI-IO、HDF5)让多节点协同读写;把临时中间数据放节点的本地存储(如内存盘),只把最终结果写并行文件系统。
3.3 可复现性是科学义务
⚠️ 常见坑:不固化运行环境就发表论文或交付结果。半年后别人想复现你的实验,发现装不上当时版本的库、跑不出当时的数字,可信度大打折扣。HPC 计算的可复现性是科学义务——至少要用容器或模块记录完整的运行环境(编译器版本、库版本、节点配置),理想情况下连调度脚本和输入参数都版本化管理。这不是锦上添花,是基本规范。
3.4 故障和容错
大规模集群上节点故障是常态而非例外——一个跑几天的作业,中间某个节点宕机的概率不低。如果不做容错,整个作业就白跑了。HPC 的容错主要靠检查点(checkpoint)——作业定期把状态写到存储,故障后从最近的检查点恢复而非从头开始。检查点的频率是性能和安全性的权衡:太频繁影响性能(写检查点要时间),太少故障后损失大(要重算很多)。
要点速记
- 作业调度系统(SLURM)管理共享集群的资源排队和分配,用好它的关键是精准请求资源。
- 并行文件系统提供高聚合带宽的共享存储,用好的关键是大块读写和并行 IO 库。
- 容器化(Singularity)解决环境可复现,对科学计算的可信度至关重要。
- 模块系统做轻量级环境切换,和容器搭配:模块管开发工具,容器管应用部署。
- 可复现性是科学义务,别发不可复现的结果;检查点是大规模作业的容错必需。
下一章看 HPC 在哪些领域真正落地,以及前沿趋势在哪。