2.2 文件内容查看与文本过滤
2.2 文件内容查看与文本过滤
本节摘要:日志与配置文本是运维排错的核心证据,cat、less、head、tail 负责快速阅读,grep、awk、sed、sort、uniq 负责结构化提取。本节从一次"接口偶发超时"的排查全程出发,演示如何用文本流水线在几百万行日志里锁定根因证据。
事故现场:每分钟随机十几次超时 持续三天
某支付网关的第三方监控连续三天报"接口偶发超时",概率约千分之三,本机压测完全复现不了。开发同学反复看代码找不到原因,应用日志里只有零星的超时记录,看不出规律。第三天运维介入,做法完全不同:不看代码,看日志的统计特征。
第一步把三天里所有超时记录抽出来,第二步按分钟统计分布,第三步把分布图和同一时间的系统日志对齐。三步做完,规律跳出来了——超时全部集中在每小时的第 5 到 8 分钟,而系统日志显示同一时段磁盘写入延迟飙升。顺着时间线查下去,根因是同机部署的日志归档任务每小时第 5 分钟启动,把磁盘 IO 打满,支付接口的落盘操作跟着抖动。修复方案简单到 embarrassing:把归档任务挪到低峰时段并限速。
这个案例的启示是:日志不是用来"看"的,是用来"算"的。人眼看几百万行日志什么也发现不了,但统计学会让模式自己浮现。本节就把这条流水线的每一段拆开讲。
一、四个阅读器:按场景选对工具
cat 一次倾倒全部内容,适合短文件——几十行以内的配置文件,cat 加 n 带行号输出是标准用法。但对大文件 cat 是灾难:几百兆的日志 cat 下去,终端刷几分钟屏,什么都留不下。
大文件用 less。它是分页器,可以前后翻页、搜索、跳转。掌握五个按键就够用:空格翻页、斜杠搜索、n 跳到下一个匹配、g 回开头、大写 G 到结尾。less 最被低估的能力是直接读压缩包:
less /var/log/syslog.2.gz
不需要先解压,less 自动调用解压程序透明展示。轮转归档的历史日志查询全靠它。
head 与 tail 各取一端。看文件开头确认格式,看文件结尾追踪最新,方向别搞反。tail 加 f 是实时跟踪模式,运维的看家本领:
tail -f /var/log/nginx/error.log
终端停在那里,新日志一到立刻显示。排查"边操作边看反应"的问题时,开一个 tail 窗口相当于给系统接了心电图。配合 grep 过滤只看关心的内容:
tail -f /var/log/nginx/access.log | grep --line-buffered " 500 "
注意这里必须加行缓冲选项,否则 grep 会攒够一块缓冲才输出,实时性全无——这是管道过滤实时流的第一坑。
二、grep:从海量文本里捞出那几行
grep 按模式匹配行,是最常用的过滤器。匹配指定错误:
grep "ERROR" /var/log/app/service.log | head -8
2026-08-16 05:12:31 ERROR PaymentTimeout order=8831 elapsed=3205ms 2026-08-16 05:12:47 ERROR PaymentTimeout order=8839 elapsed=3011ms 2026-08-16 06:05:02 ERROR PaymentTimeout order=9122 elapsed=2888ms
高频选项浓缩成四条经验。i 忽略大小写,找日志时建议默认带上,Error 和 ERROR 别漏。v 反选,剔除干扰行。c 只数数量不出内容,快速看趋势。E 用扩展正则,多条件或关系一次表达:
grep -cE "ERROR|WARN" /var/log/app/service.log
14203
一万四千条告警级别记录——下一步自然是看它们的时间分布,这就轮到统计工具上场。
⚠️ 常见坑:grep 匹配的点号是正则通配符。搜 IP 地址片段写成 grep 加点分模式,点会匹配任意字符,可能捞出无关行。要匹配字面点号,用反斜杠转义或加 F 选项按纯文本处理。
三、awk:按列思考
日志和命令输出大多是结构化的:空格或逗号分隔的列。awk 的心智模型就是"按列处理"。取出超时记录的分钟数:
grep "ERROR" /var/log/app/service.log | awk '{print substr($2,1,5)}' | head -5
05:12 05:12 06:05 07:05 08:05
两个位置:第二个字段是时间,取前五个字符得到分钟。接着统计每分钟出现次数:
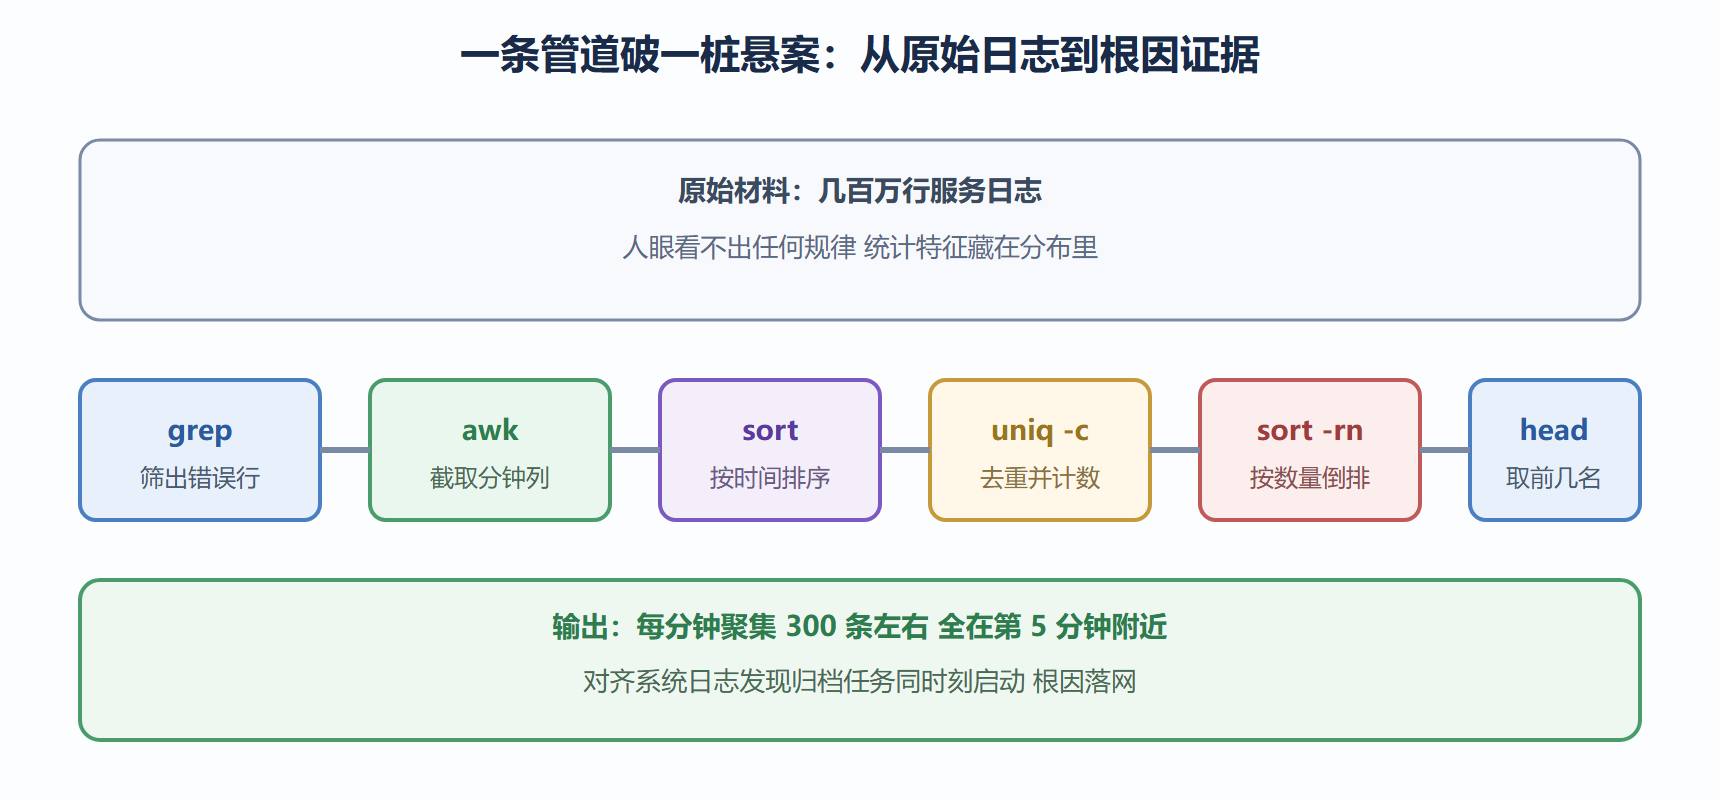
grep "ERROR" /var/log/app/service.log | awk '{print substr($2,1,5)}' | sort | uniq -c | sort -rn | head -5
312 06:05 298 07:05 305 08:05 289 09:05 301 10:05
答案自己跳出来了:每小时的第 5 分钟是重灾区,正是开篇案例的破案瞬间。这条管道值得逐段消化——grep 筛行、awk 取列、排序、去重计数、按量倒排、取前五。六段水管,一个根因。
awk 还能做条件过滤和计算,比如统计超时请求的平均耗时:
grep "ERROR" /var/log/app/service.log | awk '{sum+=$5; n++} END {print "平均耗时毫秒:", sum/n}'
平均耗时毫秒: 3050.27
第五个字段是耗时数字,累加除以计数,一段就够。awk 完整的语法是一门语言,运维日常用到的一成足够覆盖九成场景:取列、条件、累加,三招走天下。
四、sed:批量改文本
sed 流式编辑文本,运维最常用的两个场景是替换与删除行。替换配置占位符:
sed -i 's/__LISTEN_PORT__/8088/' /data/myapp/conf/myapp.conf
s 表示替换,三条斜杠分隔模式与替换文本,i 选项直接写回文件。不带 i 则只打印结果不改文件——不确定时先不带 i 预览,思路与 rm 前 ls 预演一致。
删除空行与注释行,给大配置文件瘦身便于阅读:
sed -e '/^$/d' -e '/^#/d' /etc/sysctl.conf
配合重定向存成一个"有效配置"副本,审阅配置实际生效内容时非常顺手。全词替换加 g 选项处理一行内多处匹配,不加 g 只换每行第一处——这个差异导致过无数"为什么只改了一半"的疑惑,记住它。
五、把流水线固化成脚本
排查现场搭的流水线,事后整理成脚本就是团队资产。把开篇的三步排查固化:
#!/usr/bin/env bash # 超时记录按分钟分布统计 set -euo pipefail LOG="${1:?用法: timeout_profile.sh 日志路径}" grep "ERROR" "$LOG" \ | awk '{print substr($2,1,5)}' \ | sort | uniq -c | sort -rn | head -10
调用与输出:
./timeout_profile.sh /var/log/app/service.log
312 06:05 298 07:05 305 08:05 ...
注意 set 那行的三个选项:未定义变量报错、命令失败即停、管道任一段失败即停。1.3 节讲过退出码是脚本的神经系统,这一行就是把神经接通——流水线任何一段断裂,脚本立刻喊疼而不是带病跑完。
图 2-2 文本排查流水线的六段分工
延伸:从流水线到数据思维
回头看开篇案例,它真正教的不是五条命令,而是一种思维方式:把模糊的现象翻译成可统计的量,再让工具替你数数。"变慢"翻译成超时记录的时间分布,"偶发"翻译成每分钟聚集度,模糊感受一旦变成数字表格,规律就藏不住了。这种翻译能力是文本处理命令的灵魂,比语法重要得多。
日常可以刻意练习这个翻译动作。看到"错误有点多",问自己多到什么程度、集中在什么时段、涉及哪些接口——三个问题分别对应计数、时间分布、维度分组,全是流水线的标准件。看到"这个文件挺大",问自己里面行数多少、重复占比多少、按字段切分后最大块是谁。把身边每个模糊描述都翻译一遍,命令的组合方式会自己浮现。练上一个月,你看日志的眼神会从"一堆字"变成"一张表",这是运维分析能力的分水岭。
还有一条经验值得记下:流水线要边搭边验证。不要一口气写完六段管道再回车,先跑第一段看输出对不对,接第二段再验证,逐段确认。长管道任何一段理解有偏差,最终结果就是垃圾——而垃圾的输出往往看起来还挺像样,最容易骗人。分段验证的成本是几次回车,收益是每一段都是可信的。
常见疑问解答
grep awk sed 要学到多深
一个务实的分层:grep 掌握十来个高频用法足够;awk 掌握取列、条件过滤、累加统计三招;sed 掌握替换与按模式删行。这个深度能覆盖日常八成需求。剩下的两成——复杂正则、awk 的完整脚本语法、sed 的多命令编排——用到时现学,现学的成本远低于预防性的全面学习。命令行工具是典型的"用到才记得住"型知识,背全谱是低效的。
日志轮转是什么 为什么老的日志找不到了
日志文件会无限增长,所以系统按大小或时间自动切割:改名为带编号或日期的副本,超过保留数量的删除,主文件从头再写。这就是为什么上周的日志不在主文件里,而是散落在带数字后缀的压缩文件里——用 less 直接读压缩副本,或者找到对应的归档文件再分析。理解轮转机制后,"日志莫名消失"的恐慌就变成了"去归档里找"的日常。
处理几个G的大日志 机器会很卡吗
流水线设计得好就不卡。关键技巧有仨:能过滤尽早过滤(grep 越早出场,后级数据量越小);取够即停(需要前十条就在管道尾接 head,上游会收到信号停止生产);避免把大文件整个读进内存的写法。cat 一个几个G的文件进 grep 是反面教材,正确做法是 grep 直接读文件——前者要经过一次无意义的整体倾倒。命令组合的效率意识,是初级和中级运维的分水岭之一。
正则表达式看着就头大 有必要学吗
有必要,但可以分层学。第一层是字面量加星号点号,五分钟学会,覆盖一半场景;第二层是字符组、锚点、量词,一个下午学会,再覆盖三成;第三层的捕获组、反向引用、贪婪惰性匹配,用到再学。千万别抱着正则教程从头啃——那是最快的劝退路径。本教程用到哪一层讲到哪一层,你按需吸收即可。
图形化的日志分析平台都有的年代 还练这些干什么
平台是好东西,但它是别人的系统:查询语法是它定的、能看什么是它定义的、它挂了你就瞎了。而命令行流水线是随系统自带、永远不会被下线的保底能力。更现实的场景是:平台接的日志覆盖不到某台边缘机器、平台索引延迟了十分钟、你要查的东西平台根本没采集。这时候能直接登机器拉流水线的人,就是现场最有价值的人。工具会换代,能力长在自己身上。
日志分析的三个层次
把本节的工具按使用深度分层,可以帮你知道自己练到了哪一层。第一层是"找得到":用 grep 定位已知关键词,看到具体的报错行——这是入门水平,能处理"有明确报错信息"的问题。第二层是"看得全":用 head 尾部加 tail 加 less 在日志间跳转,把一次请求的完整链路串起来——能处理"单次异常"的问题。第三层是"算得出":用 awk 与统计管道把海量记录压缩成几个数字,让模式与异常自己浮出水面——能处理"说不清哪里不对"的模糊问题。三层用的命令差别不大,差别在想问题的方法。绝大多数人停在第一层就止步了,本节希望你直接从第三层的方法论入门,命令反而是次要的。
本节要点回顾
- 日志要算不要看:统计分布比肉眼扫行更容易让模式浮现
- 阅读器各司其职:cat 短文件、less 大文件与压缩包、tail 跟实时
- tail 加 f 过滤时给 grep 加行缓冲:否则实时性失效
- grep 四经验:忽略大小写、反选、只计数、扩展正则或关系
- awk 三招走天下:取列、条件过滤、累加统计
- sed 先预览再写回:与删除命令同一个预演哲学
- 现场流水线事后固化成脚本:加严格模式,团队资产就攒起来了
下一节讲系统体检命令——在打开日志之前,先用一分钟看清楚机器的资源层发生了什么。