2.3 系统信息与负载排查命令
2.3 系统信息与负载排查命令
本节摘要:uptime、free、df、du、ps、vmstat 构成 Linux 资源层的第一轮体检工具箱。本节从一起"服务变慢但没人知道为什么"的典型报警出发,建立一套五分钟内完成的标准化初诊流程:负载看趋势、内存看压力、磁盘看余量、进程看元凶。
事故现场:一条"网站变慢"的客服工单
周四下午客服转来工单:"网站好像变慢了,客户在抱怨。"没有报警触发——因为阈值没到,只是用户先于监控感知到了劣化。这类"亚健康"故障比宕机难得多:没有明确的时间点、没有明确的报错,只有一个模糊的感受。
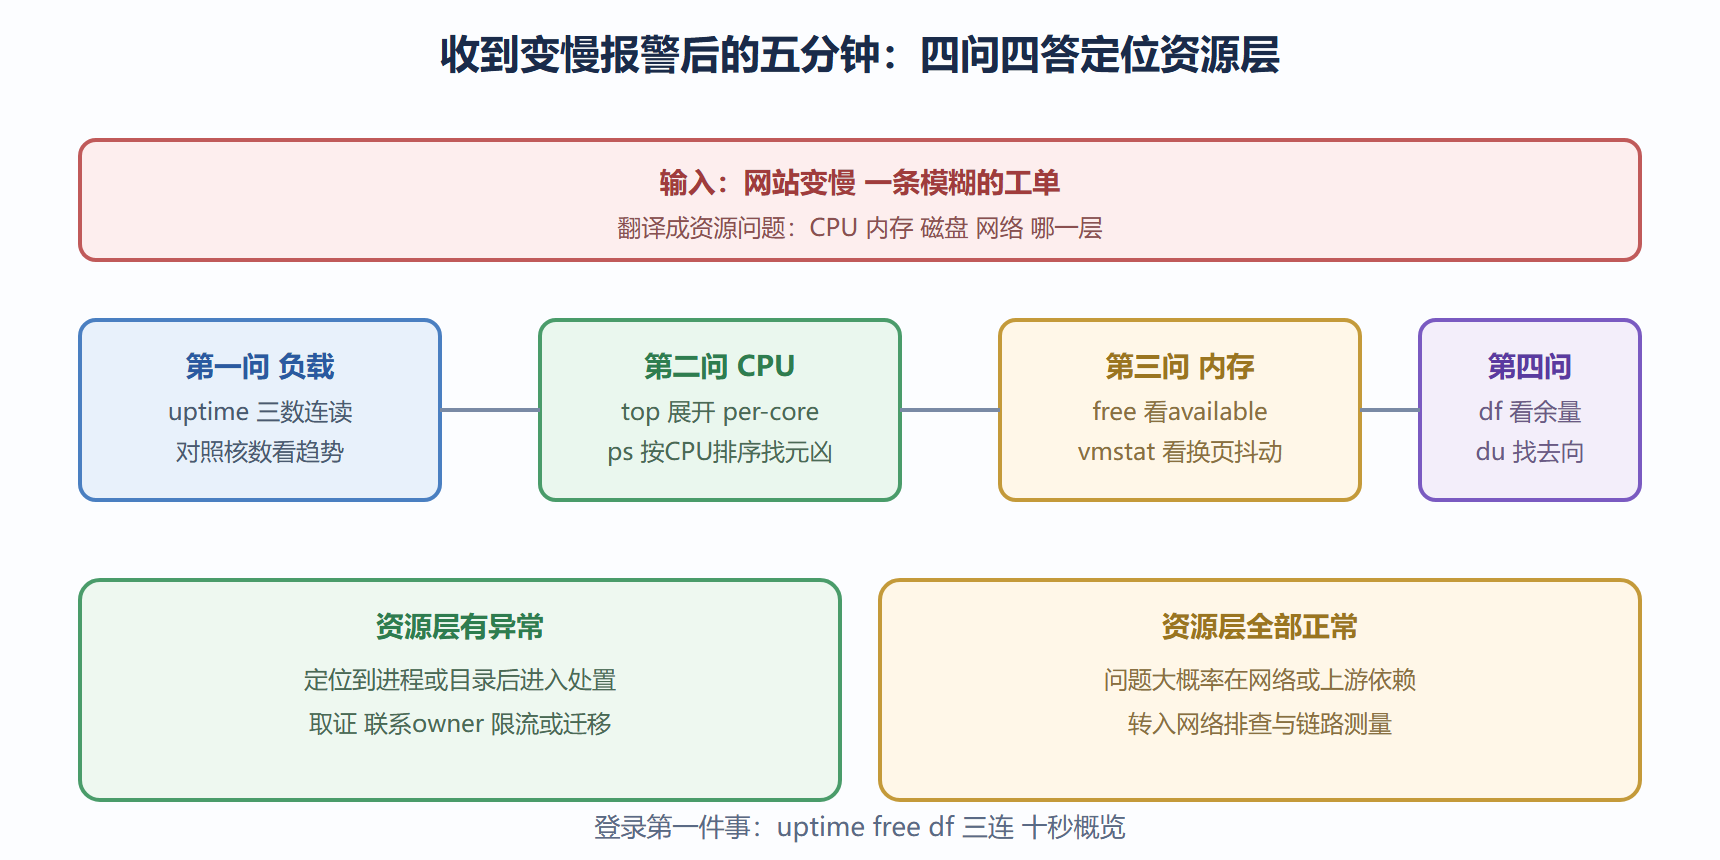
值班同学如果东一榔头西一棒槌地看,一小时也理不出头绪。正确做法是把"变慢"翻译成可度量的资源问题:是 CPU 忙不过来?内存不够开始换页?磁盘响应慢?还是三者都正常、问题在网络另一端?四问四答,五分钟内有结论。这一节就是这四问的完整打法。剧透结果:那次是同机新上的数据分析任务把 CPU 两个核吃满,Web 进程排队等调度,响应时间整体上浮。
一、第一问:整机有多忙——uptime 与负载
登录机器第一条命令:
uptime
14:23:01 up 46 days, 3:12, 2 users, load average: 3.42, 2.10, 0.95
三个负载数字分别是一分钟、五分钟、十五分钟的平均值,含义是"正在运行加不可中断等待的进程数"。解读的要诀是三数连读看趋势:这里 0.95 → 2.10 → 3.42,从十五分钟前到现在持续爬升,说明负载是正在发生的事情,不是历史残留。反过来若三个数是 3.42 → 2.10 → 0.95,则是高峰已过、正在回落,紧迫性完全不同。
负载值本身没有绝对的好坏,判断基准是 CPU 核数。机器有四个核,负载 3.42 意味着接近满载排队;有十六个核,3.42 只是小菜。核数这样查:
nproc
4
这台机器四核,负载 3.42 已经接近打满——第一问有了初步答案:整机确实在忙。但"忙"的原因还没定位,负载高可能是 CPU 计算,也可能是 IO 等待被计入。继续往下问。
二、第二问:CPU 在忙什么——top 的正确打开方式
top 是老朋友了,1.1 节看过它的静态输出。排错时的关键看两行:CPU 行里各状态的占比,和进程列表里谁在榜首。按一次键盘 1,CPU 行会展开成每个核一行,能看到负载是否集中在个别核。
%Cpu0 : 85.3 us, 5.1 sy, 0.0 ni, 9.2 id, 0.1 wa, ... %Cpu1 : 83.9 us, 6.0 sy, 0.0 ni, 9.8 id, 0.2 wa, ... %Cpu2 : 3.1 us, 1.0 sy, 0.0 ni, 95.5 id, 0.3 wa, ... %Cpu3 : 2.8 us, 0.9 sy, 0.0 ni, 96.0 id, 0.2 wa, ...
us 是用户态计算,sy 是内核态,wa 是 IO 等待,id 是空闲。这台机器两个核用户态占八成五,另两个核几乎全闲——负载不是 IO 问题,是有进程在疯狂计算,而且集中在两个核上(大概率是单进程多线程)。往进程列表里找:
ps aux --sort=-%cpu | head -4
USER PID %CPU %MEM COMMAND root 8821 189.4 6.2 python3 analysis_task.py www 1042 12.1 3.5 gunicorn worker
占住接近两个核的正是那个分析任务进程。破案主干到此完成。ps 的排序输出比交互式 top 更适合留档进故障报告,这也是它的独特价值。
⚠️ 常见坑:看到 CPU 高就直接杀进程。先确认这个进程是干什么的——是业务进程在正常高峰,还是失控任务在空转。杀错对象的二次事故,往往比原故障更难收拾。
三、第三问:内存够不够——free 的三个层次
free -h
total used free shared buff/cache available Mem: 3.9Gi 2.1Gi 186Mi 12Mi 1.6Gi 1.6Gi Swap: 2.0Gi 356Mi 1.6Gi
新手最常见的误读是看到 free 列只有 186Mi 就断言"内存快用完了"。错。Linux 会把空闲内存拿去做磁盘缓存(buff/cache 列),需要时立刻让出来——这是设计而非泄漏。真正该看的是 available 列:当前还能给进程多少内存。这里 1.6Gi,健康。
内存真正的危险信号在两处:available 长期低于总量的百分之十;swap 的 used 持续增长。前者说明内存逼近极限,后者说明已经开始用磁盘假装内存,性能会断崖式下降——磁盘比内存慢几个数量级。这台机器 swap 用了三百多兆,结合业务量判断属于历史残留,暂不处理,但值得记录进巡检台账。
内存压力的进阶确认用 vmstat 看换页活动:
vmstat 2 3
procs -----------memory---------- ---swap-- ---io---- -system-- ----cpu---- r b swpd free buff cache si so bi bo in cs us sy id wa 2 0 364544 190832 92160 1589320 0 0 2 12 120 210 22 4 73 1 2 0 364544 189440 92160 1589320 0 0 0 0 118 205 23 4 72 1 2 0 364544 188008 92160 1589320 0 0 0 0 121 214 22 5 72 1
si 与 so 两列是换入换出,持续为非零说明内存吃紧到正在抖动。这里全零,内存层排除。
四、第四问:磁盘还剩多少——df 与 du 的组合拳
df -h
Filesystem Size Used Avail Use% Mounted on udev 2.0G 0 2.0G 0% /dev /dev/vda2 40G 23G 15G 61% / /dev/vdb1 200G 187G 2.1G 99% /data
数据盘只剩 2.1G,使用率百分之九十九——如果这台机器撑到周末,大概率会重演 1.2 节那个"写满拖垮整机"的事故。df 负责发现"哪个分区紧张",du 负责回答"空间被谁吃了":
du -h --max-depth=1 /data 2>/dev/null | sort -rh | head -6
95G /data/mysql 62G /data/backup 28G /data/logs 2.1G /data/app 200G /data
数据库占九十五G,备份占六十二G。顺藤摸瓜发现备份保留了三十天的全量,而策略本该是"七天内每日、更早每周"。调整保留策略后释放四十多G,风险解除。注意 du 命令里的重定向丢弃错误输出——权限不足的目录会刷一屏报错干扰阅读,这是 du 的日常礼仪。
💡 关键直觉:df 看分区余量,du 找空间去向,两者答案对不上时(df 说满了 du 却找不到大文件)多半是被删除但仍被进程占着的文件——文件句柄没释放,空间不归还。用 lsof 找出正持有已删除文件的进程,重启它即可。这个经典疑难在第 3 章还会展开。
五、把四问固化成一页速查
四问的顺序有讲究:先看整机趋势(便宜、快、信息密度高),再看 CPU 与内存(定位到资源类型),最后看磁盘(常与业务增长相关,需要决策而非仅排查)。整个流程串起来:
uptime && free -h | head -3 && df -h | grep -v tmpfs
14:31:22 up 46 days, 3:20, 2 users, load average: 3.20, 2.15, 1.02 Mem: 3.9Gi 2.1Gi 186Mi 12Mi 1.6Gi 1.6Gi Swap: 2.0Gi 356Mi 1.6Gi Filesystem Size Used Avail Use% Mounted on /dev/vda2 40G 23G 15G 61% / /dev/vdb1 200G 187G 2.1G 99% /data
一条命令、三样核心指标、十秒完成初诊概览。把它放进你的操作习惯里,每台机器登录后的第一件事就是它。
图 2-3 五分钟初诊流程图
延伸:写好一份故障初诊记录
四问的产出不该只留在你的脑子里。故障处理完成后,一份两百字左右的初诊记录价值极高,它同时服务三个对象:给管理者的时间线、给后续深挖者的线索、给未来自己的复盘素材。记录的格式无需复杂,五段足够——现象描述(用户视角,含开始时间)、初诊数据(三条核心命令的输出摘录)、初步结论(定位到哪一层)、已采取的动作(含时间点)、遗留问题(未验证的假设与风险)。
贴一段那次"网站变慢"的真实风格记录供参考:周四十四点二十客服报慢;十四点二十三分登录,负载 3.42 持续爬升,双核用户态八成五,swap 静止,数据盘九成九;结论为分析任务占用双核导致调度排队;处置是分析任务降级运行并预约错峰;遗留问题是数据盘只剩 2.1G,已提工单清理备份保留策略。五句话,任何接手的人都能在三十秒内接上语境。
写初诊记录还有一个隐性收益:它强迫你在动手的同时保持观察。知道每个动作要留痕,你在敲命令时就会多想一层"这条输出说明什么",诊断质量随之上升。记录不是负担,是把自己的思考过程外化成可校验的文字——这与脚本要退出码、命令要预演是同一种工程伦理。
常见疑问解答
负载数字到底怎么算出来的
它统计的是两件事之和:正在 CPU 上运行的进程数,加处于不可中断睡眠状态的进程数。后者多半在等磁盘或网络 IO 完成——所以磁盘卡顿时负载也会飙升,哪怕 CPU 全闲着。这就解释了一个经典疑惑:CPU 使用率很低、负载却很高,九成是 IO 等待在作怪,方向应该往磁盘和存储链路查,而不是盯着 CPU 白费劲。
swap 用了一部分 要紧吗
分情况。开机很久的机器 swap 用掉几百兆且长期不变,是历史峰值留下的痕迹,不影响性能,不用处理。若 si so 持续非零、swap 占用持续爬升,说明内存真实吃紧,进程正在磁盘和内存之间来回倒腾,必须处理——加内存或砍掉吃内存的进程。判断关键词是"趋势":静态的占用是历史,动态的增长是现在。
CPU 使用率多少算高
没有万能线,但有几个实用的判断档位。长期超过八成:容量不足或异常进程,要查;忽高忽低跟随业务高峰:正常波动,记录基线即可;用户态高是应用在计算,内核态高是系统调用频繁(IO 小文件或网络风暴的典型信号),IO 等待高是存储拖后腿。比绝对数值更重要的是建立自己系统的基线——知道平时长什么样,异常一眼可辨。基线意识是监控思维的起点。
磁盘使用率到多少该报警
经验值是八成预警、九成紧急。留缓冲的原因:某些数据库和日志系统在空间紧张时性能先降后崩;删除大文件的瞬间可能需要临时空间做原子替换;突发流量可能几个小时吃掉几个G。等到九成九再动手,你处理的空间余量已经没了,动作会变形。容量管理永远是提前量游戏。
这些命令每次都要手敲吗
高频组合应该固化。开头的三连可以包成脚本放在家目录,登录后一条命令出全部结果;团队层面则应把体检指标接入监控系统,让机器代替人盯。手敲命令的意义在于培养判断力——知道数字从哪来、意味着什么;监控平台的意义在于解放人力。两条腿走路,别迷信任何一边。
关于阈值:数字背后的业务含义
所有"多少算高"的判断,最终都要回到业务语境。一台跑批处理机器的 CPU 常年九成是设计如此,一台登录服务器内存九成则可能随时出事;数据库盘写入延迟五毫秒是日常,对象存储盘五毫秒就该报警。所以阈值从来不是抄来的,是从自己系统的运行历史里长出来的。具体做法:连续两周在固定时间点采集核心指标,画出分布,把基线定在常態上限、把告警线定在基线上浮三成。有了自己的基线,别人的参考值只是对照,不是标准。这也是为什么成熟的运维团队都有"指标基线库"——它比任何教科书阈值都可靠。
还要为四问补一句定位上的说明:它解决的是资源层初诊,不是全部排错。资源层正常不代表系统健康——应用死锁、网络丢包、上游依赖超时都不在本章射程内。四问的价值在于快速切割:把资源层排除掉,你就知道该带着剩下的线索去哪个方向。排错的效率不在查得多快,而在排除得多快。
本节要点回顾
- 负载三数连读看趋势:一五六十五分钟连起来是走势图,孤立一个数没有意义
- 负载基准是核数:判断忙不忙,先问机器有几个核
- CPU 看 us sy wa 分工:用户态计算、内核态、IO 等待各指向不同方向
- free 看 available 不看 free:缓存是设计,可用量才是真相
- df 与 du 是组合拳:一个报病情一个找病灶,答案矛盾时查已删未释放的句柄
- 四问顺序即成本顺序:便宜的先问,贵的后问,五分钟收口
资源层的初诊会了,下一节补上两件常备兵器——查找文件的 find,与打包迁移的 tar。