2.1 变量、类型与地址
2.1 变量、类型与地址
本节摘要:C 的变量在机器上是"一段字节 + 一份解读方式"。本节建立这个模型:用取地址符拿到变量的地址,用字节数看清各类型宽度,用十六进制转储直接目击内存内容,并澄清字面量、隐式转换与整型提升这些藏在类型系统里的机器规则。
变量不是名字,是地址
写 int a = 42; 时机器做了两件事:在栈上(或寄存器)圈出 4 个字节,把 42 的补码写进去。a 这个名字编译后就不存在了,剩下的只有地址与长度。验证:
#include <stdio.h> int main(void) { int a = 42; char c = 'A'; double d = 3.14; printf("a 在 %p,占 %zu 字节\n", (void *)&a, sizeof a); printf("c 在 %p,占 %zu 字节\n", (void *)&c, sizeof c); printf("d 在 %p,占 %zu 字节\n", (void *)&d, sizeof d); return 0; }
典型输出:
a 在 0x7ffc8a01b45c,占 4 字节 c 在 0x7ffc8a01b45b,占 1 字节 d 在 0x7ffc8a01b460,占 8 字节
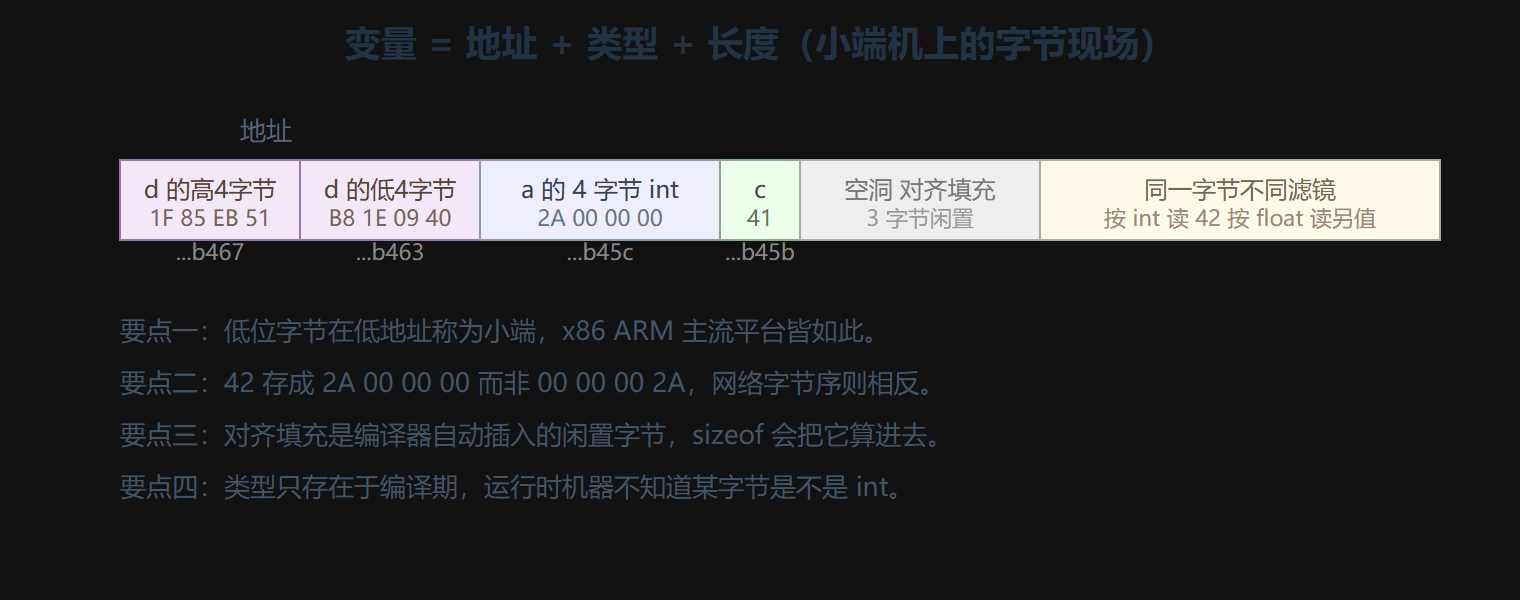
注意地址:c 恰好在 a 旁边,d 对齐到了 ...460(8 的倍数)。变量在栈上是紧挨着排布的,而且按自身大小对齐——对齐不是玄学,是 CPU 访问效率要求,第 7 章会展开。
图 1 栈上三个变量的字节排布
直接目击内存:十六进制转储
把 a 的 4 个字节逐个打出来(利用无符号字符指针走字节):
#include <stdio.h> int main(void) { int a = 42; unsigned char *p = (unsigned char *)&a; for (int i = 0; i < sizeof a; i++) printf("字节%d = 0x%02X\n", i, p[i]); return 0; }
输出:
字节0 = 0x2A 字节1 = 0x00 字节2 = 0x00 字节3 = 0x00
低位字节 0x2A(42)存在最低地址——这就是小端序。同一份字节按大端机读就是 0x2A000000。网络协议统一用大端,所以有 htonl、ntohl 这类转换函数。字符串没有字节序问题(逐字节顺序存),这也是文本好移植、二进制数据要小心字节序的原因。
类型的宽度:谁说了算
C 标准只保证最小宽度与相对关系(sizeof(char) <= sizeof(short) <= sizeof(int) <= sizeof(long)),具体数值由平台决定。64 位 Linux 下的主流布局:
| 类型 | 宽度 | 对齐 | 能表示的范围(约) |
|---|---|---|---|
| char | 1 | 1 | -128 至 127 |
| short | 2 | 2 | ±3.2 万 |
| int | 4 | 4 | ±21 亿 |
| long | 8 | 8 | ±9.2×10^18 |
| float | 4 | 4 | 6~7 位有效数字 |
| double | 8 | 8 | 15~16 位有效数字 |
| 指针 | 8 | 8 | 虚拟地址空间 |
两个高频事故点:long 在 64 位 Windows 上是 4 字节、在 64 位 Linux 上是 8 字节——跨平台代码请用 int32_t、int64_t 这类定宽类型;char 的符号性也是实现定义,做字节处理时明写 unsigned char。
字面量与隐式转换:机器上的静默改写
类型系统里最容易吃亏的是隐式转换。规则记忆版:窄类型向宽类型、整数向浮点自动转,反之要截断或丢精度。看三起事故:
int half = 7 / 2; /* 3:整数除法先发生,小数被扔掉 */ double bad = 3 / 2; /* 1.0:右侧先按 int 算完再转 double */ double ok = 3.0 / 2; /* 1.5:有一个操作数是浮点就按浮点算 */ unsigned u = 1; if (u - 1 < 0) /* 永远为假:u-1 按无符号算出极大值 */ printf("到不了这里\n");
第三例最阴险:无符号数与有符号数混合运算时,有符号被转成无符号,u - 1 得到 UINT_MAX 而不是 -1。循环写成 for (unsigned i = n-1; i >= 0; i--) 就是死循环——i >= 0 对无符号恒真。
还有一个只在汇编层看得见的规则:整型提升。char 与 short 参与运算时先提升为 int:
char a = 100, b = 100; int r = a + b; /* 200,正确:先提升成 int 再加 */ char c = a + b; /* 溢出截断,c 的值是实现定义的 -56 */
CPU 的加法器按 int 宽度工作,窄类型运算"免费"以 int 进行,结果装回窄变量时截断。这不是编译器多余的动作,是机器现实。
本节要点回顾
- 变量 = 地址 + 类型 + 长度:名字编译后消失,类型只在编译期把关,内存里只有字节。
- 小端序是主流:低位字节在低地址;跨机器的二进制数据必须显式处理字节序。
- 宽度由平台决定:跨平台用 int32_t 等定宽类型;long 在两大桌面系统宽度不同。
- 隐式转换静默改写:整数除法丢小数、有符号遇无符号变极大值、窄类型赋值截断。
- 整型提升是机器现实:char 与 short 运算按 int 进行,装回窄变量时才截断。
下一节进入字节内部:整数为什么用补码存,浮点数的 8 个字节里三个位域如何瓜分空间。
常见疑问
问:既然运行时没有类型信息,调试器怎么知道变量类型? 答案在调试符号里。编译时加 -g 参数,编译器会把变量名、类型与栈帧偏移写进独立的调试信息段,调试器读它来还原视图;运行中的程序本身依然一无所知。剥掉调试符号后,调试器也只能看到裸地址。
问:取地址运算有运行开销吗? 没有。取地址在编译期折算成栈帧偏移加基址,通常一条加法指令甚至零指令。这也是指针高效的根本原因之一——传递的只是一个小小的地址值。
问:怎么快速确认某类型在当前平台的宽度? 打印 sizeof 即可,它是编译期常量,结果只取决于目标平台。凡是涉及二进制格式、网络协议、文件布局的代码,都应显式使用定宽类型,把宽度的不确定性关在门外。