6.2 二维数组与行主序内存
6.2 二维数组与行主序内存
本节摘要:内存是一维的,"二维数组"只是编译器对一块连续内存的网格化解读——C 采用行主序:第 0 行整行排完再排第 1 行。这决定了
m[i][j]的地址公式与遍历顺序的性能差异(第 3 章实验的理论根基)。本节讲清布局、地址计算、二维数组传参的正确写法,以及"指针数组"这种真二维结构。
网格是错觉,直线是真相
int m[3][4] = { { 1, 2, 3, 4}, { 5, 6, 7, 8}, { 9, 10, 11, 12} };
在内存里它是一条 48 字节的直线:
1 2 3 4 5 6 7 8 9 10 11 12 └── 第0行 ──┘ └── 第1行 ──┘ └── 第2行 ──┘
行主序(row-major)意味着整行连续存放,行与行首尾相接。地址公式:
m[i][j] 的地址 = 首地址 + (i × 列数 + j) × 元素宽度
比如 m[1][2]:首地址 + (1×4 + 2)×4 = +24 字节,正是直线上的第 6 个元素 7。编译器把公式编进指令:mov eax, [rdi + rax*4 + rcx*16]——i 乘 16(一行 4 个 int)、j 乘 4,两级缩放一条指令完成。
图 1 行主序布局与两种遍历
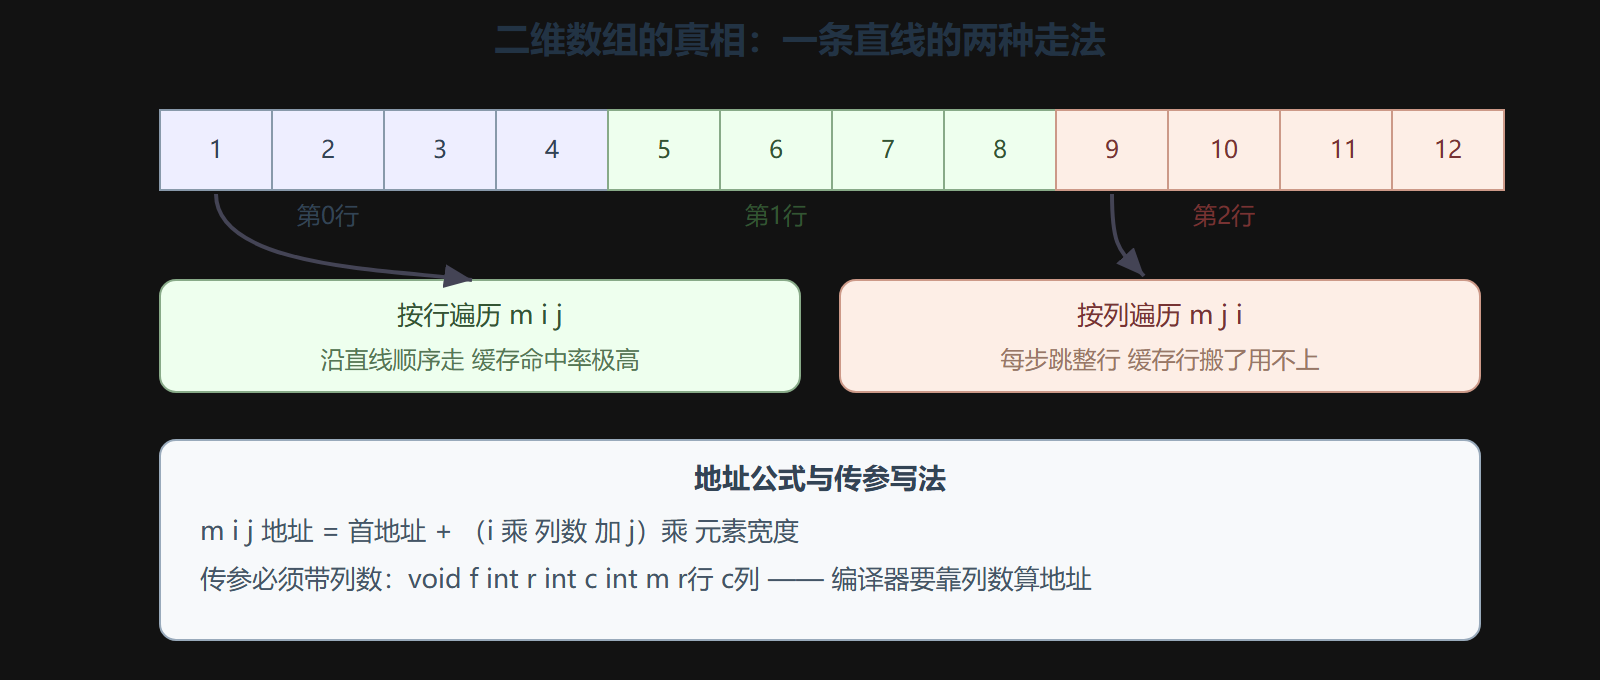
第 3 章的按行按列 5 到 10 倍性能差,理论根基就在这张图:按列访问每步跳一整行,缓存行白白搬运。
传参:列数是地址公式的一部分
/* 错误:int m[][] 编译不过,第二维不可省 */ void print_matrix(int rows, int cols, int m[][cols]) /* C99 变长数组参数 */ { for (int i = 0; i < rows; i++) { for (int j = 0; j < cols; j++) printf("%4d", m[i][j]); printf("\n"); } }
为什么列数不可省?看地址公式:没有列数就算不出 i 对应的偏移——二维数组的"形状"信息一半在类型里。int m[][4] 与 int m[][8] 是不同类型。传统写法是"数组指针":
void f(int (*m)[4], int rows); /* m 是指针,指向 int[4] 这种行类型 */
读法:m 是指针,指向"4 个 int 的数组"。m + 1 跳一整行 16 字节(第 5 章步长规则的又一次演出)。这行写法与 int m[][4] 完全等价,挑顺眼的用。
真二维:指针数组与动态分配
上面所有写法的列数在编译期定死。运行期才知道行列时,用"行的指针数组"构造真二维结构:
#include <stdio.h> #include <stdlib.h> int **make_grid(int rows, int cols) { int **g = malloc(rows * sizeof(int *)); for (int i = 0; i < rows; i++) g[i] = calloc(cols, sizeof(int)); return g; } void free_grid(int **g, int rows) { for (int i = 0; i < rows; i++) free(g[i]); /* 先释放每行 */ free(g); /* 再释放指针数组 */ } int main(void) { int **g = make_grid(3, 4); g[1][2] = 42; /* 用法与二维数组一致 */ printf("%d\n", g[1][2]); free_grid(g, 3); return 0; }
两种"二维"的取舍:
| 维度 | int m R C 静态二维 | int 指针数组 动态二维 |
|---|---|---|
| 内存形态 | 一条直线 | 每行各自一块,另加指针数组 |
| 大小 | 编译期定 | 运行期定,行长可不同 |
| 缓存友好 | 极好(行内连续) | 行内连续,行间跳跃 |
| 释放 | 自动 | 逐行 free 再 free 指针数组 |
| 访问开销 | 一次乘加 | 两次解引用 |
释放顺序不能反:先释放每行再释放指针数组——先把目录烧了,里面的页就找不到了(泄漏)。 jagged array(各行长度不同的锯齿数组)只有动态方案能做,比如存不等长句子。
⚠️ 常见坑:把动态二维当静态二维传参。
int **g与int (*)[4]内存布局完全不同(前者两级间接,后者一条直线),强转后按错误布局访问,数据全乱。两种"二维"不能混用,接口签名要对齐。
💡 关键直觉:看到任何多维数据先问"内存里怎么摆"——行主序一条直线(缓存友好)还是指针拼接(灵活但两级跳转)。布局决定性能,签名决定能不能传,两者要一起设计。
本节要点回顾
- 内存只有一条直线:行主序下 m i j 的偏移 = i 乘列数加 j,再乘元素宽度。
- 列数是类型的一部分:传参不可省(C99 变长数组参数或数组指针两种写法)。
- 数组指针加一跳一整行:步长规则在高维的延伸。
- 动态二维是两级结构:指针数组加各行内存,释放顺序先内后外。
- 静态二维与动态二维布局不同,不能强转混用。
下一节进入 C 世界最著名的约定:字符串的零结尾。
常见疑问
问:三维及以上数组还有意义吗? 有,且同样按"行主序"直线化:最右下标相邻的元素在内存里相邻。规律不变——最右侧下标连续变化的方向就是内存连续方向,最内层循环应沿它走。
问:动态二维为什么不能整体一次分配吗? 可以:按行数乘列数一次 malloc 一条直线,再用指针换算下标访问。这样缓存最友好,代价是访问要手写乘加,丢了双下标的语法糖。性能敏感的数值代码常这么干。
问:行列大小运行期才知道时,栈上能开二维数组吗? C99 支持变长数组,可以在栈上开运行期大小的数组;但大变长数组极易栈溢出,且错误处理受限(声明处无法检查失败)。工程上更稳妥的做法仍是堆分配加显式释放。
问:行主序和列主序有什么实际影响? 影响遍历性能与接口约定。数值计算库的文档会明确布局,Fortran 系语言与部分数学库用列主序,C 系用行主序;混用时数据要转置,否则计算结果整体错位。写矩阵代码前先确认布局,是最容易被忽略的正确性问题。
问:sizeof 一个二维数组怎么算? 整块相乘:行数乘列数乘元素宽度,因为内存里就是一条直线。三维同理逐维相乘。退化发生在传参之后,sizeof 只在定义所在的作用域里可信。