6.3 字符串:以零结尾的字节序列
6.3 字符串:以零结尾的字节序列
本节摘要:C 没有字符串类型——字符串只是"以零结尾的字节数组"这个约定。结尾零是唯一的身份标识:strlen 靠逐字节找零计算长度,printf 的 %s 靠找零知道在哪停。约定极简高效,但所有写入端必须保证"装得下内容加结尾零",否则越界。本节讲清约定、常用函数的风险清单与安全替代写法。
一个字节的身份标识
#include <stdio.h> #include <string.h> int main(void) { char s[6] = {'h', 'e', 'l', 'l', 'o', '\0'}; /* 手工摆出全部字节 */ char *t = "hello"; /* 字面量:只读区,自带结尾零 */ printf("%s 长度 %zu\n", s, strlen(s)); /* hello 长度 5 */ printf("sizeof s = %zu\n", sizeof s); /* 6:含结尾零 */ return 0; }
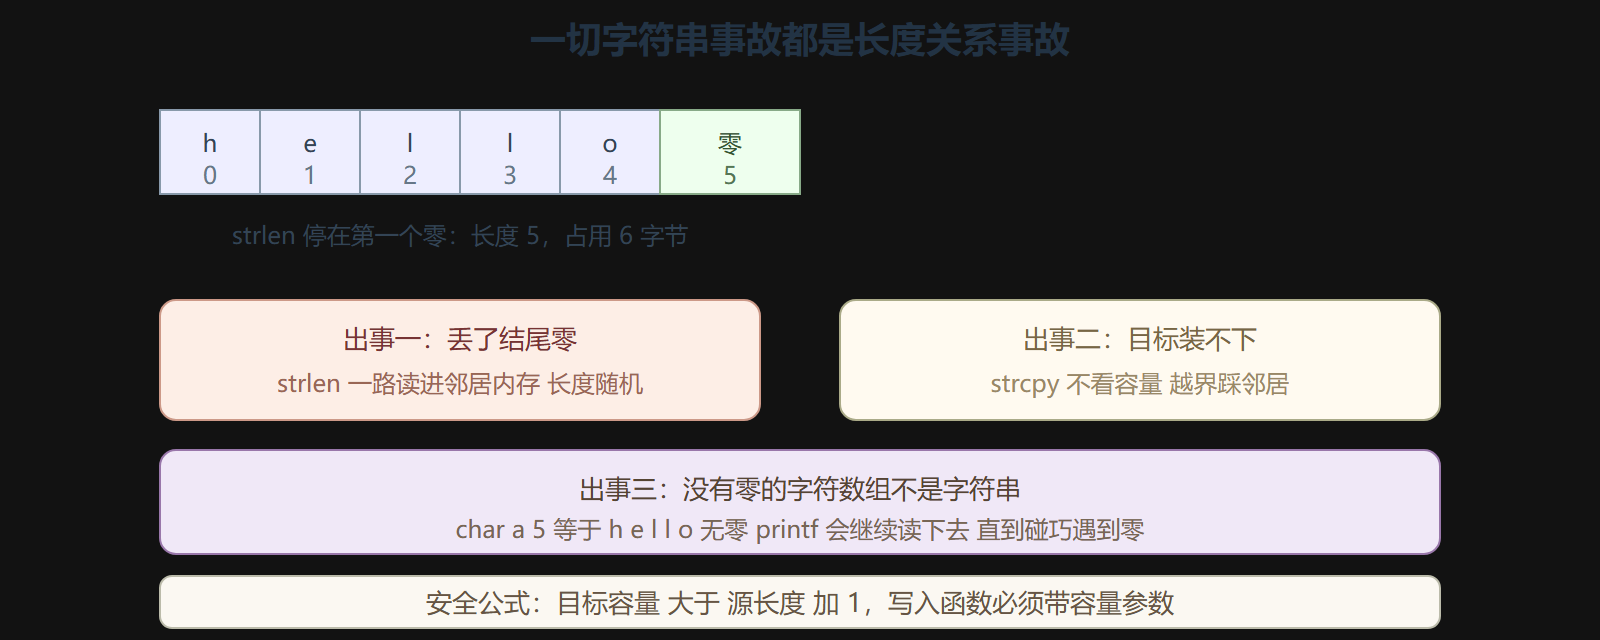
三个数字放在一起看:strlen 是 5、sizeof 是 6——长度不含结尾零,容量必须给它留位。"长度 5 的字符串需要 6 字节"是无数缓冲区大小事故的核心公式。
字符串字面量 "hello" 是只读区里的 6 个字节(第 1 章见过它的地址前缀);字符数组是把内容复制进自己的地盘。char *p = "hi" 与 char a[] = "hi" 的区别:前者指向只读区(改写即段错误),后者是栈上的副本(可改)。需要修改就用数组形式。
图 1 零结尾与三种"出事"的长度关系
常用函数与风险清单
size_t strlen(const char *s); /* 逐字节找零,O(n) */ char *strcpy(char *dst, const char *src); /* 复制直到源零:不看 dst 容量 */ char *strcat(char *dst, const char *src); /* 追加:同样不看容量 */ int strcmp(const char *a, const char *b); /* 逐字节比较,差值带符号 */ char *strncpy(char *dst, const char *src, size_t n); /* 限量复制 */ char *strncat(char *dst, const char *src, size_t n); /* 限量追加 */ char *strstr(const char *h, const char *n); /* 找子串,返回位置或 NULL */ char *strchr(const char *s, int c); /* 找字符 */
strcmp 的返回值约定:负数、0、正数对应小于、等于、大于——判断相等用 == 0,别把返回值当布尔用。strncpy 有个暗坑:源够长时它不补结尾零(精确复制 n 字节),目标可能变成"没有零的字符数组"。安全补零要自己做。
安全替换的样板:
char buf[32]; /* 拷贝:保证结尾零 */ snprintf(buf, sizeof buf, "%s", src); /* 现代首选:永不越界、总补零 */ /* 拼接 */ snprintf(buf, sizeof buf, "%s-%s", a, b); /* 读入 */ scanf("%31s", buf); /* 容量减一,留位给零 */
snprintf 是字符串操作的安全瑞士军刀:带容量、自动截断、保证结尾零。老代码里的 sprintf、strcpy、strcat,评审时一律替换。
操纵字符串的正确姿势:手写字符串反转
不调用库函数,自己走一遍字节级操作,把本章知识串起来:
#include <stdio.h> void reverse(char *s) { size_t len = 0; while (s[len] != '\0') /* 手工 strlen:逐字节找零 */ len++; for (size_t i = 0; i < len / 2; i++) { char t = s[i]; /* 首尾对调 */ s[i] = s[len - 1 - i]; s[len - 1 - i] = t; } } int main(void) { char buf[] = "machine"; /* 数组形式:可写副本 */ reverse(buf); printf("%s\n", buf); /* enihcam */ return 0; }
值得盯住的细节:char buf[] = "machine" 是栈上 8 字节副本(含零),可以原地反转;若写成 char *buf = "machine",reverse 里的写入直接段错误——第 5 章"指向谁家的活内存"判据的字符串版。
多字节字符的提醒
C 的 char 只是一个字节,中文这类多字节编码(UTF-8)一个字占多个字节、且每个字节都可能非零。strlen 对 UTF-8 返回字节数不是字符数;按字节切片可能把一个字切成两半输出乱码。处理中文文本要么用操作系统 API 的宽字符接口,要么明确按 UTF-8 规则逐码位解析——把"字节"与"字符"分开,是国际化代码的第一课。
⚠️ 常见坑:从网络或文件读入的"字符串"没有结尾零。外部数据是字节流,读进来后必须在末尾补零,才能交给 strlen 与 printf 家族——否则它们会一路读到碰巧的零为止。
💡 关键直觉:字符串的世界只有一条公式——容量必须大于内容加一。所有写入前先问"最坏情况下源有多长、我的容量够不够",问完再写,事故归零。
本节要点回顾
- 字符串 = 以零结尾的字节序列:长度不含零,容量必须含零,strlen 是 5、sizeof 是 6。
- 字面量在只读区,数组是可写副本:要改用数组形式。
- strcpy strcat sprintf 不看容量:一律换 snprintf 与限长读入;strncpy 源够长时不补零。
- strcmp 用 == 0 判相等;外部读入的字节流要补零才是字符串。
- char 是字节不是字符:UTF-8 下 strlen 给字节数,切字节会切断字符。
第 6 章结束。下一章把不同类型的成员拼进一块内存:结构体与它的对齐填充。
常见疑问
问:为什么 C 当年选择零结尾而不是带头部长度? 早期机器内存以 KB 计,每个字符串省一个长度字段是可观的节省;零结尾也让逐字节处理的外设天然匹配。代价是长度要靠遍历计算、写入端必须防越界——这是五十多年前的权衡在今天的回响。
问:字符串字面量相同内容会合并吗? 多数编译器会把相同的字面量合并成一份只读数据,两个指针可能指向同一地址。所以别比较字面量指针是否相等来判断内容——用 strcmp。
问:字符串能有多长? 理论上限是字节计数类型的上限;实际限制来自内存与你要传的容量参数。strlen 返回的类型是无符号的长度类型,接收时用对的类型,避免大字符串截断。