3.2 Module:可组合的提示词流水线
3.2 Module:可组合的提示词流水线
本节摘要:Module 是 DSPy 的结构层:内置模块给出常见行为形态的成品,自定义 Module 用 PyTorch 风格的组合语法把单步调用拼成任意流水线。本节讲内置模块家族的行为差异、自定义模块的编写约定、多层组合的接缝规则,以及编译器如何沿组合树逐个优化到每个预测器。
学习目标
阅读完本节,你应当能够:
- 说出 Predict、ChainOfThought、ReAct、ProgramOfThought、Retrieve 五个内置模块各自的行为形态与适用任务。
- 按
__init__声明子模块、forward定义数据流的约定,独立编写一个自定义 Module。 - 解释"模块只管结构、不管提示词内容"这条边界对调试方式的影响。
- 画出多层组合程序的组合树,并指出编译时优化器实际触碰的是哪些节点。
内置模块家族:行为形态的成品库
内置模块解决的是"常见行为形态不必重造"的问题。dspy.Predict 是素模块:把签名交给模型直接作答,没有附加行为,适合格式转换、分类、抽取这类单步任务。dspy.ChainOfThought 在每个调用里附加一段推理生成,让模型先思考再给字段值——它是 1.1 节"思维链话术"的模块化形态,但与手工话术有本质区别:思考段的长度、位置、措辞都是编译器的优化对象,而不是写死的咒语。dspy.ReAct 让模型在推理中交替发起工具调用(搜索、检索、计算),适合需要外部信息的开放任务。dspy.ProgramOfThought 让模型生成 Python 代码、执行后取结果,把数值计算、日期推算类问题交给确定性运行时。dspy.Retrieve 不调用生成模型,纯粹负责向检索底座发起查询并取回文段。
选型的粗规则:单步映射任务用 Predict;需要中间推理的用 ChainOfThought;证据在模型知识之外的一律加 Retrieve;涉及算术、比较、单位换算的优先 ProgramOfThought;需要边想边查的用 ReAct。这些形态可以嵌套——一个模块内部调用另一个模块,是 DSPy 程序的常态。
自定义模块的组合语法
自定义 Module 刻意模仿 PyTorch:子模块在 __init__ 里声明为实例属性,forward 方法描述数据如何流过它们。看一个带检索与自校验的完整例子:
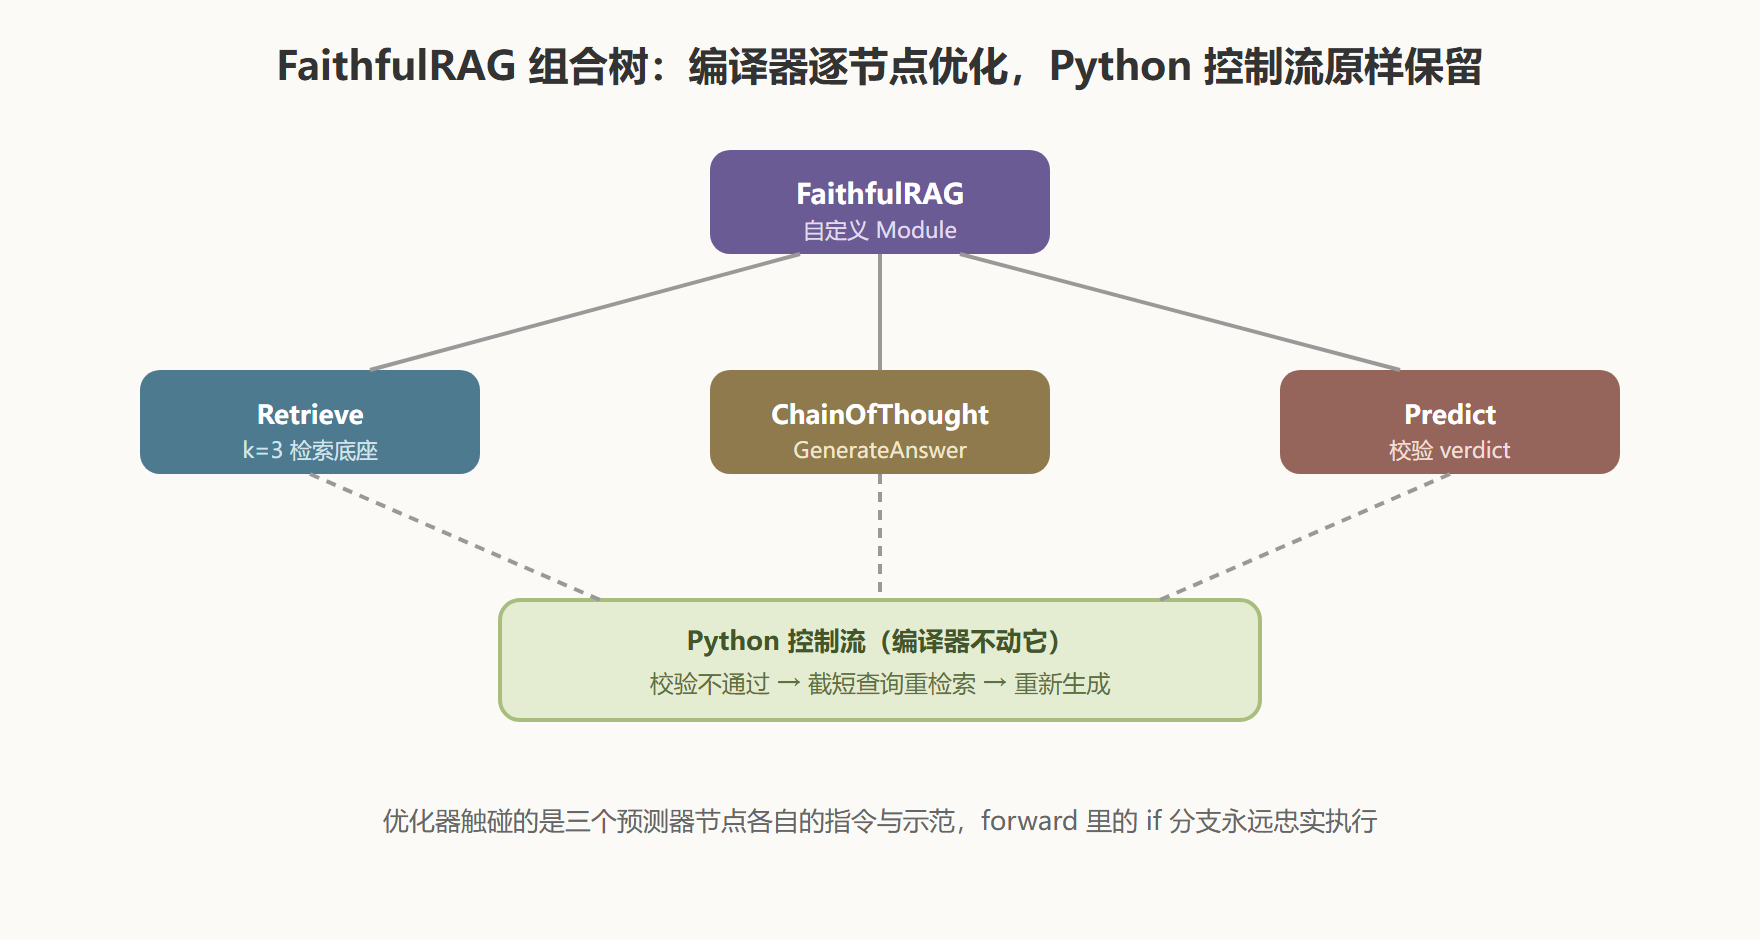
import dspy class GenerateAnswer(dspy.Signature): """基于上下文回答问题,答案简短并给出依据。""" context = dspy.InputField(desc="检索到的证据文段") question = dspy.InputField() answer = dspy.OutputField(desc="短答案") basis = dspy.OutputField(desc="答案依据的文段编号,如 P1、P2") class FaithfulRAG(dspy.Module): def __init__(self, k: int = 3): super().__init__() self.retrieve = dspy.Retrieve(k=k) self.generate = dspy.ChainOfThought(GenerateAnswer) self.check = dspy.Predict( dspy.Signature( "判断答案是否完全由证据支撑;不支撑则返回 unsupported。", context=dspy.InputField(), answer=dspy.InputField(), verdict=dspy.OutputField(desc="supported 或 unsupported"), ) ) def forward(self, question): passages = self.retrieve(question).passages context = "\n".join(passages) pred = self.generate(context=context, question=question) verdict = self.check(context=context, answer=pred.answer).verdict if verdict != "supported": # 证据不足:换一个更宽泛的查询重试一次 alt = " ".join(question.split()[:5]) passages = self.retrieve(alt).passages context = "\n".join(passages) pred = self.generate(context=context, question=question) return dspy.Prediction(answer=pred.answer, basis=pred.basis, context=passages)
三个约定值得注意。子模块必须声明为实例属性——编译器靠遍历实例属性找到所有预测器节点,藏在局部变量里的调用不会被优化。forward 里的普通 Python 逻辑(这里的一次重试)属于程序结构,编译器原样保留,它优化的只是每个预测器的提示词。返回值习惯用 dspy.Prediction 包装,让下游拿到统一的字段访问接口。
图:FaithfulRAG 的模块组合树
"只管结构"边界的调试含义
模块层这条边界——只管结构、不管提示词内容——决定了调试的分工。行为不符合预期时,先判断问题属于哪一层:检索没捞到证据、重试逻辑没触发,是结构层问题,改 forward;答案风格漂移、格式偶发错乱,多半是预测器层的提示词问题,交给编译(或检查编译产物)而不是去改代码。手工时代这些问题全糊在一个字符串里,只能全文重读;分层之后,定位问题变成了二选一的排查,这是结构层带来的实打实的工程收益。
还有一个实践要点:模块组合是编译的放大器。组合树越深、预测器越多,编译的搜索空间越大,需要的训练数据与预算也越多。两三个预测器的程序,几十条数据就能编得像样;十几个预测器的深水线程序,还指望同样少的标注,编译产物质量就会明显波动。结构复杂度要有数据规模配平——这条原则第 4 章讲编译预算时会再给出具体数字。
把组合原则浓缩成一句话:模块层写的是"控制流与数据流",预测器层留给编译器"措辞与示范"——两句话之间划清边界,代码就写不歪。顺着这条边界检查你自己写过的程序:凡是发现 forward 里出现了针对模型输出的字符串补丁("输出以逗号结尾就删掉"之类的权宜处理),都说明该行为本应通过签名描述或断言机制交给框架治理——补丁是结构层在替预测器层打工,分层名存实亡。
本节要点回顾
- 成品库思维:五个内置模块对应五种行为形态,先选形态再造轮子,嵌套组合是常态。
- PyTorch 式约定:子模块声明在
__init__,数据流写在forward,编译器遍历实例属性找预测器。 - 边界决定调试分工:结构问题改代码,措辞问题交编译;分层让排查从全文重读变成二选一。
- 组合是放大器:预测器数量决定搜索空间,结构复杂度必须与数据规模、编译预算配平。
- 通向下一节:模块组合出了结构,但"谁来决定每个节点的提示词"仍是悬案——答案要从优化器的祖先 Teleprompter 讲起。