- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
DSPy 教程导读:从手工调优到提示词编译
「提示词编译」听起来像个借来的词:提示词明明是写给大模型看的指令,怎么就跟编译器扯上了关系。这正是本教程要拆解的疑问——DSPy(Declarative Self-improving Language Model Programs)把靠手感、靠反复试错的提示词手工调优,变成了有源代码、有编译产物、有质检环节的工程流程。比这套工具本身更值得讲的,是它背后的演化过程:一代工程师如何从"改一句话、跑一遍、看感觉"的循环里走出来,逐步把提示词当成可以被编译和优化的程序来对待。跟着这条主线读,你会发现 Signature、Module、Optimizer 这些概念不是凭空设计出来的,而是每个阶段的具体痛点逼出来的答案。
一句话概括:这本教程按"演化历史"的主线组织——从提示词手工调优时代讲到提示词编译范式的成型与落地,读完你不仅会用 DSPy,还能理解它为什么长成这样。
为什么按演化主线来读
市面上讲 DSPy 的材料大多直接从 API 列起:这是 Signature,这是 Module,这是 Optimizer。照着抄能跑,但换一个任务就懵——因为你不知道每个抽象在替你解决什么问题。我们的判断是:DSPy 的每个设计决定,都对应着提示词工程史上某段真实经历过的疼。手工调优时代疼在"换个模型全部重来",于是有了可移植的程序抽象;疼在"改了这一句坏了那一句",于是有了编译时的整体优化;疼在"谁也说不清这版提示词是不是更好",于是有了内建的评估体系。按这条线走一遍,那些概念就不再是需要背诵的名词,而是水到渠成的推论。
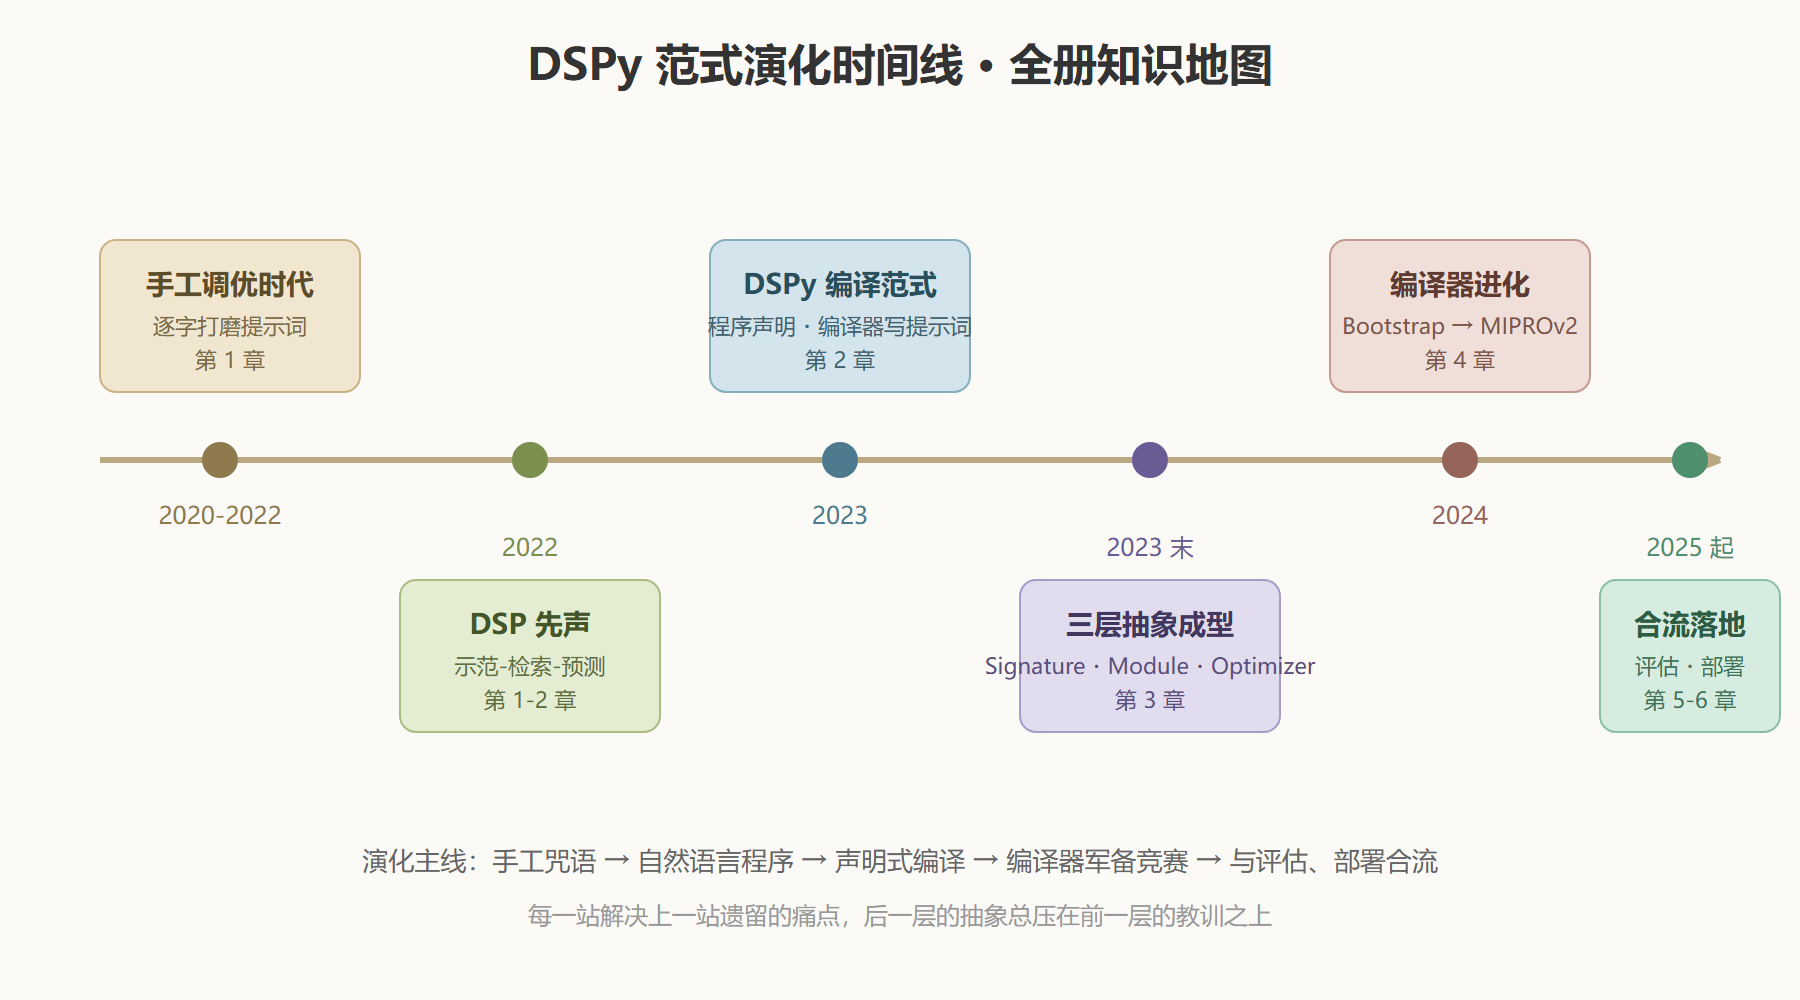
整册的脉络可以压缩成一段话。最早,工程师们把提示词当咒语,逐字打磨,性能取决于谁更有耐心;随后,斯坦福 NLP 组的 DSP 工作提出用"示范-检索-预测"的自然语言程序描述多步推理,暴露出手工写中间提示仍然不可扩展;接着 DSPy 把思路推到底——程序只声明输入输出和行为结构,提示词由编译器从数据里学出来,三层抽象(Signature、Module、Optimizer)就此成型;再往后,编译器本身经历了几轮进化,从最朴素的 BootstrapFewShot 自举示范,到 MIPRO/MIPROv2 把指令与示范放在一起联合搜索;最终,提示词编译与评估体系、断言约束、生产部署汇成一条合流的河,成为今天可以在真实业务里落地的工程实践。
图:DSPy 范式演化时间线(全册知识地图)
全册六章怎么分工
前两章是"前史"与"破题"。第 1 章回到手工调优时代,看一遍当时的武器库(指令模板、少样本示例、思维链话术)和它撞上的天花板:脆弱、不可迁移、无法回归测试、协作靠口口相传。第 2 章讲范式如何被提出——DSPy 用声明式编程替代命令式拼提示,把"程序做什么"与"提示词怎么写"彻底分开,并给出编译式的工作流程:定义程序、定义指标、交给编译器。
中间两章是体系骨架与编译器演进。第 3 章把三层抽象逐一拆开:Signature 声明输入输出契约,Module 把签名组合成流水线,Optimizer(前身叫 Teleprompter)负责把程序加数据编译成高质量提示词,而 Metrics 是整个编译过程的方向盘。第 4 章沿着编译器的演化走:动手搭环境、跑通第一个编译产物,然后看 BootstrapFewShot 如何用自举方式从少量标注里"滚雪球"出示范样例,再看 MIPRO/MIPROv2 如何把指令优化与示范选择放在一起做联合搜索,其中 num_candidates、max_bootstrapped_demos 这些参数各自的含义与调法都会落到具体数字。
后两章是合流与落地。第 5 章讲评估体系如何与编译合流:exact_match 这类硬指标、LLM judge 这类语义裁判、断言(Assert)与建议(Suggest)两类运行时约束,以及如何检查编译产物的可解释性。第 6 章把范式推到生产环境:问答、抽取、代码生成、内容创作四个方向的完整案例,外加部署拓扑、缓存策略和一份踩坑排错清单。
学习路线与前置要求
按章顺序读是最稳的路径,章节之间存在明确的依赖:第 3 章的三层抽象是全册的地基,第 4 章的编译器全部构建在这三层之上,第 5 章的评估又是第 4 章一切优化的前提(没有指标就没有优化方向),第 6 章则是前面所有内容的汇合点。如果你时间紧张,最低限度的路径是第 2 章、第 3 章、第 4 章——读完就能上手编译自己的程序;但如果要在真实业务里交付,第 5 章不能省,"没有评估集的优化"在工程上约等于没有优化。
前置要求不高:会 Python,写过简单的类和函数;对大模型的调用方式(输入一串文字、拿回一串文字)有直觉即可。不需要你训练过模型,也不需要深厚的数学功底——DSPy 的核心卖点恰恰是让"不调权重"的人也能把 LLM 程序做到高水准。
读完你能带走什么
- 能把一个手工调优的提示词项目重构成 DSPy 程序,说清楚每一步替换换来的是什么。
- 能用 Signature 精确声明任务契约,并用 Module 组合出检索增强、多跳推理等结构。
- 能根据数据量、预算和任务性质,在 BootstrapFewShot、BootstrapFewShotWithRandomSearch、MIPROv2 之间做选型,并调对关键参数。
- 能搭一套由 exact_match 与 LLM judge 组成的评估基线,让每次改动都有数字可依。
- 能识别编译产物的质量问题来源:数据不够、指标失真、还是搜索预算不足。
一条阅读建议:这本教程里的代码示例都刻意保持了"可以直接照抄改造"的形态,但请别只抄——每章末尾的拐点分析才是骨架。工具会过时,范式演化的逻辑不会。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...