3.4 Optimizer:优化器总览与选型
3.4 Optimizer:优化器总览与选型
本节摘要:把 DSPy 优化器家族摊在一张表上:从零成本的 LabeledFewShot 到联合搜索的 MIPROv2,按数据要求、搜索强度、调用开销、产物形态四个维度做系统对比,并给出按场景选型的决策规则。本节是 4.4、4.5 两节深度剖析的导览图。
先给结论:选型速查
急着干活的读者先拿走结论:只有几百条以上人工标注、任务简单,用 LabeledFewShot;标注稀缺(几十条)但程序零样本能力尚可,用 BootstrapFewShot;想在自举之上加一层保险并顺便挑选最优候选,用 BootstrapFewShotWithRandomSearch;标注几十到几百条、追求指令与示范联合调优的较高上限,用 MIPROv2;任务即将固化部署、愿意为最终几个点支付微调成本的,用 BootstrapFinetune。拿不准就先跑 BootstrapFewShot 建立基线,再用 MIPROv2 尝试超越——这是社区反复验证的稳健路径。
家族谱系与机制对比
LabeledFewShot:把人工标注样本按签名格式化为示范,不做任何生成与搜索。它回答的问题是"至少别让程序裸奔"——零样本能力弱的模型配上几条干净示范,往往就有可观提升。数据要求最高(全靠人工标注),成本最低,上限也最低。
BootstrapFewShot:自举机制的直接实现。程序自跑训练集,指标过滤轨迹,回收为示范。参数里最关键的是 max_bootstrapped_demos(自举示示范数上限)与 max_labeled_demos(混入的人工标注示范数),两者共同决定每个预测器提示词里的示范容量。它不搜索指令,也不挑选候选程序——快、便宜、可解释,是默认的第一次编译选择。
BootstrapFewShotWithRandomSearch:在自举之上叠加候选程序随机搜索。编译时会产出多个候选(默认 num_candidate_programs=8 左右:含零样本版、带标注示范版与若干随机扰动版),在验证集上逐一打分,返回最优。它比纯自举多花数倍评估开销,换来对"自举运气"的保险——自举质量依赖轨迹抽样的运气,多几个候选就多几次机会。
COPRO:只优化指令、不动示范。它为每个预测器迭代提案新指令(由提案模型基于当前指令与得分生成改良版),保留得分最高者。适合"示范好找但指令写得糙"的任务,例如指令里塞满格式要求反而干扰作答的场景。
MIPROv2:把指令提案与示范选择放进同一个贝叶斯搜索循环,用采样感知的获取函数决定下一轮评估哪组"指令加示范"组合。它需要配置 num_candidates(候选指令组数)与 num_trials(评估试验次数),还提供 auto="light"/"medium"/"heavy" 档位自动推算预算。上限最高、开销最大,是当前追求质量的主力优化器,4.5 节专门拆解。
BootstrapFinetune:不走提示词路线,把自举轨迹整理成微调数据去更新模型权重。产物从"带提示词的程序"变成"带新权重的模型",适合任务固化、部署形态明确、且拥有可微调开源模型的团队。
图:优化器对比矩阵
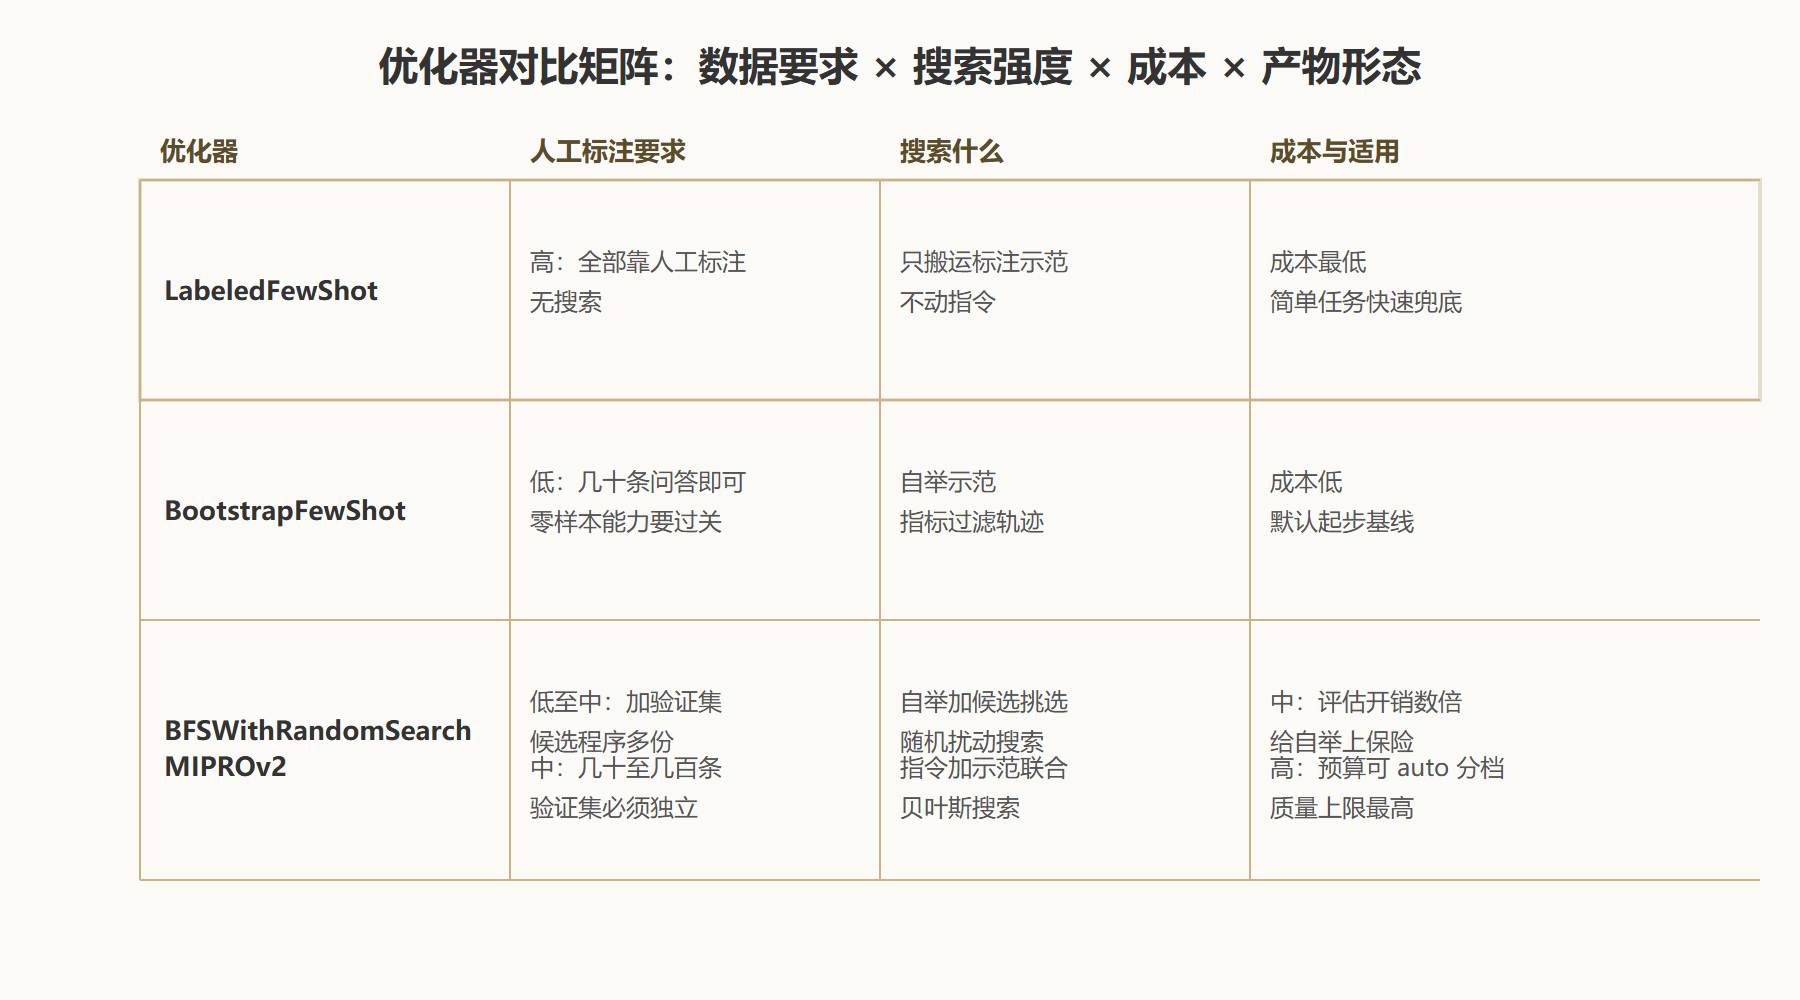
BootstrapFinetune 在矩阵之外单独记一笔:它是唯一改变产物形态的优化器——产物从提示词变成权重,选它等于选择"部署微调模型"的工程路线。
家族补遗:两个常被忽略的成员
速查表之外,还有两位成员值得认识。KNNFewShot 解决的是示范的个性化问题:为每条待处理的输入,从标注池里检索最相似的几条作为该次调用的示范——相当于把"检索增强"的思想用在示范层。它适合输入形态差异大的任务池(比如同时服务多种问法的客服系统),代价是每次调用多一次检索与示范组装。Ensemble 走的是集成路线:把多个编译产物并联,同一输入跑多个候选程序再汇总答案(投票或加权),用多倍的推理成本换取更稳的输出分布——多数生产场景用不起它,但在评估关键决策的离线场景(比如标注质量仲裁)意外地好用。
两位补遗成员还揭示了一个设计事实:优化器家族的扩展方向不止"更强的搜索",还有"示范的动态化"(KNNFewShot)与"产物的组合化"(Ensemble)。前者把示范从静态注入改成按需检索,后者把单产物部署改成多产物共识。给你的启发是:遇到瓶颈时,先判断瓶颈在搜索强度还是在示范质量——前者加预算或换 MIPROv2,后者试试 KNNFewShot 的动态示范。
组合使用也有讲究:KNNFewShot 与搜索型优化器并不互斥,先让示范池经过一轮自举提质,再交给 KNNFewShot 做运行时的按需选取,两段收益可以叠加;Ensemble 则更适合放在产物定稿之后,作为离线评估或高风险决策的仲裁层,而不是日常服务的常驻配置。把家族成员想成工具箱里的不同扳手——螺栓型号决定用哪把,而不是把手边最贵的那把当万能工具。
选型的三条决策规则
规则一,按数据定门槛:能拿出几百条干净标注时才考虑纯标注路线;只有几十条时走自举路线;一条标注都没有时,先解决数据问题而不是挑优化器——无数据的"编译"只是把随机性换了个名字。规则二,按预算定档位:把"每条候选在每个验证样本上跑一遍"的成本乘出来,MIPROv2 的完整搜索开销通常是最朴素自举的一个数量级以上,预算紧就分档(light)或减 trial。规则三,按上限需求排兵:先 BootstrapFewShot 拿基线分数,再上 MIPROv2 冲上限,两次分数之差就是"搜索强度"值多少钱——这个差值也是你向团队汇报"要不要继续投入编译预算"的直接依据。
三条规则的公共前提仍是第 3.5 节要讲的主题:所有选型都假设指标可信。指标失真时,搜索强度越大,跑偏越远——优化器是放大器,放大的是指标里的一切,包括缺陷。
用一组假设的数字把规则过一遍,看选型如何在预算表里落地。设某多跳问答程序:链路两个预测器,训练集一百条,验证集五十条,经济模型单次调用成本按一个单位计。纯自举一档:自举两轮约四百次调用,加一次验证五十次,合计约四百五十个单位——这是基线档的开销。带随机搜索一档:八个候选各在验证集上过一遍,评估开销四百个单位,加上自举本身约三百,合计七百上下,换来对自举方差的观测与择优。MIPROv2 一档:提案十次强模型调用(单价按三倍计约三十个单位),二十次试验每次小批量十样本两个预测器约四百次调用,合计八百以上。三档的价差不到一倍,但收益结构完全不同:第一档给分数,第二档给分数加置信,第三档给上限。预算排期时按"先用第一档建立基线、每两周用第三档冲一次上限"的节奏走,是最常见的排法。
本节要点回顾
- 速查结论:标注多用标注路线,标注少用自举路线,冲上限用 MIPROv2,固化部署可考虑微调路线。
- 机制光谱:从"只搬运"到"自举"到"候选挑选"到"联合贝叶斯搜索",自动化程度与开销同步上升。
- 预算意识:搜索强度真金白银,auto 档位与 num_trials 是预算旋钮;基线与上限的分数差就是预算的定价依据。
- 放大器属性:优化器放大指标的优点与缺陷,选型之前先问指标是否可信。
- 通向下一节:把"指标可信"这个问题本身讲透——指标如何设计、如何失真、如何修正,是 3.5 的全部内容。