5.1 评估与调试:让数字说话
5.1 评估与调试:让数字说话
编译完的程序好在哪、差在哪,能拿出数字吗?这个问题如果答不上来,前面两章的一切优化都失去了意义——因为没有任何人能证明它们真的发生了。本节就把评估从"跑一遍打个分"升级为一条工程化的评估回路:可并发的批量打分、可下钻的失败样本表、可持续维护的回归集。读完本节,你应当能让任何一次改动都伴随一个可复现、可解释的数字。
评估报告的解读模板
评估输出的是数字,决策需要的是解读。一份规范的评估记录应当包含五个字段:总分与方差(同一配置至少跑两遍,方差超过一个百分点必须再跑第三遍)、分项切片(按问题类型或难度切分后的分数分布)、失败分组(各错误形态的占比清单)、对比基线(与上一版产物的差值,而不是只报绝对分)、环境记录(模型版本、检索索引版本、评估日期——分数没有环境上下文就无法比较)。五个字段凑齐,这份记录才能进发布评审;缺任何一个,评审者都要靠追问补齐,评估的价值就折损了一半。
解读时还要警惕两个统计陷阱。陷阱一,小验证集上的高方差:三十条的验证集,三五条样本的翻转就是十几个点的分数波动,此区间内的"提升"多半是噪声——要么扩验证集,要么把结论降级为"方向性信号"。陷阱二,指标换代后的分数断层:换了裁判模型或指标公式,新分数与历史分数不可直接比较,必须新旧并行跑一个过渡期,重建可比性。这两个陷阱的公共根源是把分数当绝对真理,而分数只有在受控条件下才是信号。
把解读模板套在一个真实感的数字上演练一遍。假设某次重编译后的评估记录是:总分八十二(比上一版高三个点),方差零点六,分项切片显示"规则类问题"八十九、"边界类问题"六十一,失败分组里"证据未命中"占四成六,环境记录显示检索索引上周刚更新过。这套记录的正确读法是:三个点的总提升接近噪声带边缘(方差零点六算稳定,但提升幅度不大),真正值得注意的是边界类问题的塌陷与证据未命中的高占比——结合索引更新记录,怀疑点是"新索引的切块粒度不利长规则条文"。于是下一步动作不是接受这次发布,而是先跑一遍检索层独立评估验证怀疑,再决定重切块还是回滚。你可以在同一个场景里对比坏读法:"总分涨了就发布"——五个字段白准备了,塌陷与归因信息全被总分的上升淹没。
并发与限流的工程细节
num_threads 把评估从小时级压到分钟级,但它踩在模型服务的限流线上。工程细节有三:并发数按服务方限流额度的八成设置,留出重试余量;批量评估务必开启失败重试与退避(限流触发的失败若被当成"预测错误"计分,分数会被系统性压低——这是并发评估最隐蔽的坑);评估与生产流量共用同一模型服务时,给评估单独的配额标识,防止一次全量回归挤垮线上容量。这三个细节没有一条涉及算法,但每一条都能让评估结果失真或让服务事故——评估是工程活,不是算数活。
评估工具的正经用法
dspy.Evaluate 是评估回路的执行器,三个参数决定它的工程形态:
evaluate = dspy.Evaluate( devset=devset, # 独立验证集,绝不与训练集重叠 metric=exact_match, num_threads=16, # 并发线程:评估是典型的可并行负载 display_progress=True, # 进度条:长评估的刚需 display_table=5, # 失败样本表:展示前 5 条失败案例 ) score = evaluate(compiled_rag) # 典型输出:Average Metric: 82.5 / 100 (82.5%)
display_table 值得单独强调:它把失败样本连同预测、标准答案一起打出来,是最被低估的调试入口。分数告诉你"有多差",失败表告诉你"差在哪"——把失败样本按错误形态分组(检索没捞到证据、答案格式错、语义偏差、凭空编造),各组的占比就是下一步行动的优先级清单。实践经验里,失败表的前两名往往贡献了八成的失分,修它们比全盘重编译划算得多。
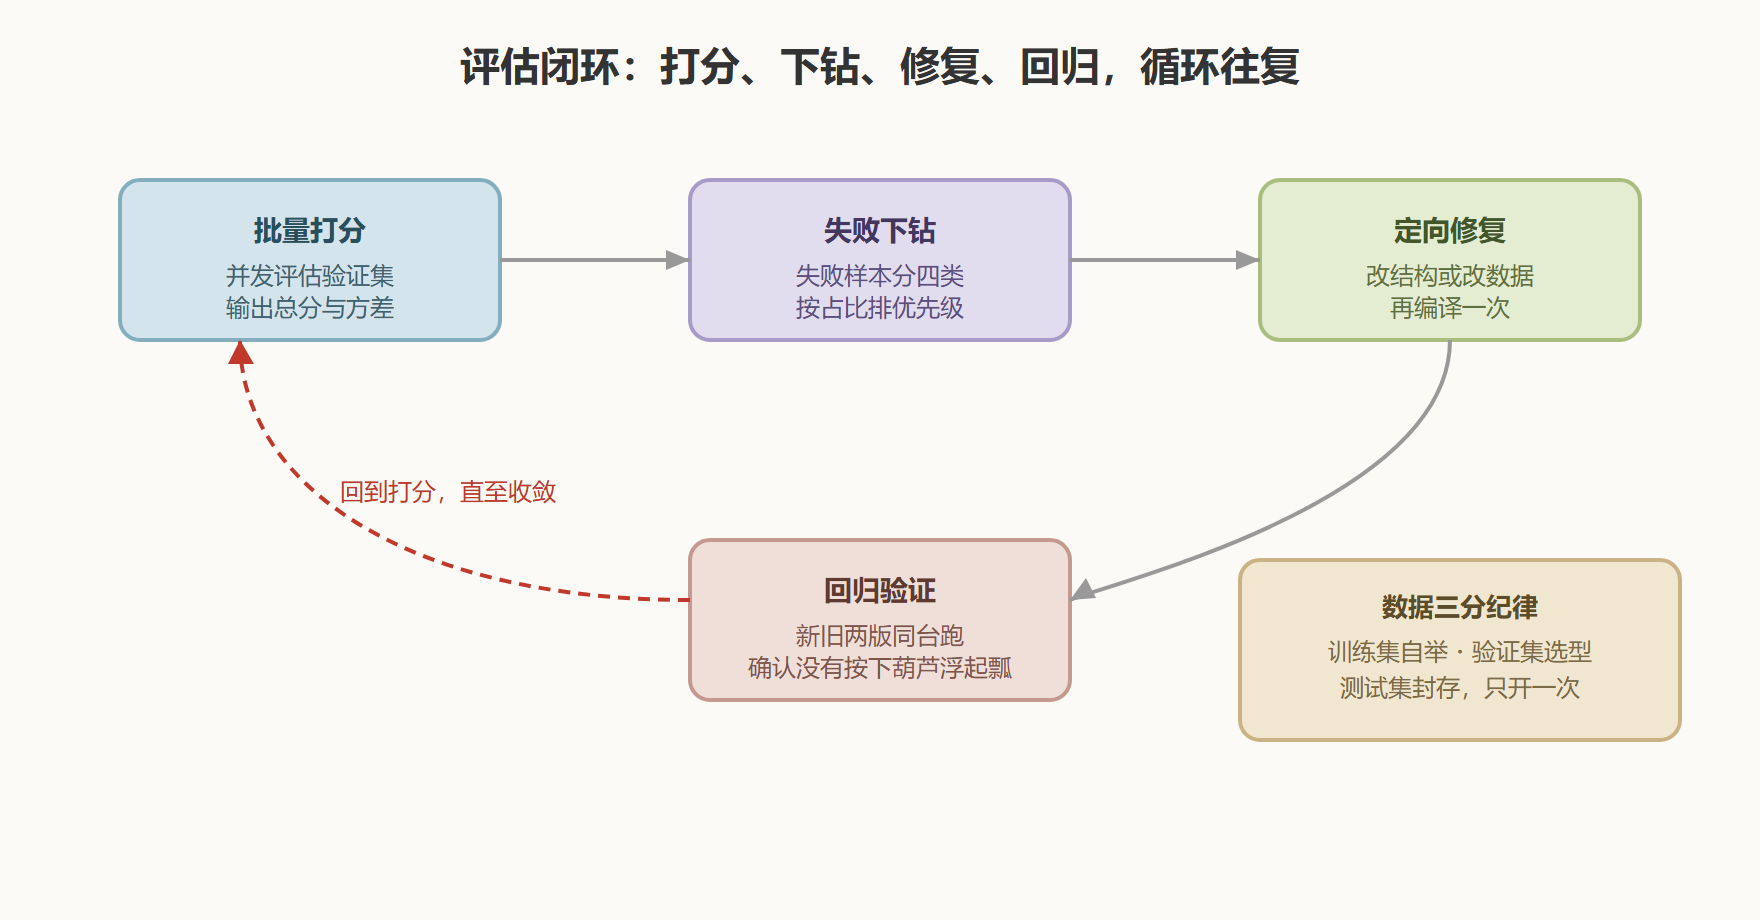
图:评估闭环与数据划分
回归集:评估回路的固定资产
评估回路的长期价值取决于回归集的维护。回归集不是切出来的验证集,而是另一份更挑剔的资产:它应当收录三类样本——历史事故样本(每次线上故障的原始问句,修复后入册)、边界样本(证据恰巧不足的问题、多义表述、超长输入)、均匀的业务分布抽样(防止修复事故后把常态拉垮)。维护节奏建议与发布节奏绑定:每次要发布新版编译产物,先在回归集上跑一次全量对比,任何一类样本的分数显著回退都视为阻断性问题。这套纪律照搬自传统软件的回归测试——LLM 程序的特殊性只在于"用例"变成了"问题加验收标准",执行框架反而更简单。
回归集会缓慢腐化:业务演变让老样本失效、指标换代让历史分数失去可比性。两个防腐手段:给每个回归样本记录录入时间与来源,定期(比如每个季度)清理不再代表当前业务的条目;指标升级时,用新旧指标并行跑一个发布周期,建立分数换算的直觉,再切换主线指标。
补一个从零开始建回归集的速成流程,给还没有任何存量资产的团队:第一步,从线上日志抽样两百条真实输入,宁要歪歪扭扭的原文不要工程师代拟的干净问句;第二步,快速标注第一轮,只标"输入加标准输出"两元组,单条标注控制在一分钟以内,先求覆盖不求完美;第三步,把明显可疑的样本单独成堆,找业务方半小时过一遍,争议样本直接丢弃不要留恋;第四步,切分封存,同步建立录入台账(时间、来源、标注人)——从日志到可用回归集,一个人两天足够。资产的价值在于启动:一份六十分的回归集远胜于一份永远在计划中的完美评估方案。
调试的分层定位法
评估告诉你哪里疼,诊断要分层做。第一层查数据:失败样本在训练集里有同类吗?没有就是分布缺口,补数据优先于改程序。第二层查检索(如果程序带检索):单独评估检索层——用"证据是否包含标准答案所需信息"做检索质量指标,这一层不依赖生成模型,分数独立可信。第三层查结构:中间预测器的输出质量如何,把链路拆开各测各的(4.3 节的拆链单测)。第四层才是查编译产物:示范池有没有污染、指令有没有跑偏——那是 5.5 节审计方法的领域。四层自上而下,每层都有独立的证据,调试就从玄学变成了排查。
一个实战案例收束本节。某团队的多跳问答程序编译后总分八成,但失败表显示"凭空编造"类占失败样本的一半。分层排查:数据层无缺口;检索层单独评估通过率很高;拆链单测发现第二跳查询生成器在证据不足时会硬编查询词;最终方案不是重编译,而是在第二跳加了建议级检查(查询词必须来自原文实体,见 5.3 节),再重编译——编造类失败清零,总分涨到九成以上。这个案例的路径值得记住:评估发现问题,分层定位根因,修复手段未必是编译,结构与约束同样是药方。
本节要点回顾
- 评估三件套:并发打分给总分与方差、失败表给错误分组、回归集给长期可比;三者构成闭环。
- 失败表优先级:按错误形态分组排优先级,前两名通常贡献八成失分,定向修复胜过全盘重编译。
- 回归集三来源:历史事故、边界样本、均匀抽样;与发布节奏绑定的全量对比是发布门禁。
- 四层定位法:数据缺口、检索质量、链路结构、编译产物,自上而下逐层排除,每层独立取证。
- 通向下一节:定位法第二层与第三层的病灶——结构缺陷——有一整套系统性的设计与重构方法,那是 5.2 的内容。