5.3 高级优化策略:断言与约束
5.3 高级优化策略:断言与约束
本节摘要:编译期优化管不了每一次真实调用,运行时质量需要另一道防线:断言(Assert)不达标就回溯重来,建议(Suggest)不达标只记警告并回馈编译期。本节讲两种约束的机制差异、代价模型、布点策略,以及它们与编译器的信号回路——这是 DSPy 把"质量控制"从被动评估推进到主动拦截的演化成果。
断言与建议:两种约束的分工
编译器的承诺是统计意义的:在验证集分布上,编译后的程序大概率表现更好。但生产环境不认可"大概率"——每一次线上调用都是一次性的,拦不住的坏输出就是事故。断言与建议把质量检查布进执行路径,两者差别在失败后的动作:
import dspy class GroundedQA(dspy.Module): def __init__(self, k: int = 3): super().__init__() self.retrieve = dspy.Retrieve(k=k) self.generate = dspy.ChainOfThought(GenerateAnswer) def forward(self, question): passages = self.retrieve(question).passages context = "\n".join(passages) pred = self.generate(context=context, question=question) # 建议:软检查。不满足只记录、不中断;编译期它会变成搜索信号 dspy.Suggest( len(pred.answer) <= 200, "答案应简短,超过二百字说明没有聚焦问题", ) # 断言:硬检查。不满足抛出回溯,触发重新生成 dspy.Assert( pred.answer.strip().lower() not in ("n/a", "unknown", "不知道"), "禁止用占位词敷衍,依据不足时应明确说明并给出缺口", target_module=self.generate, ) return pred
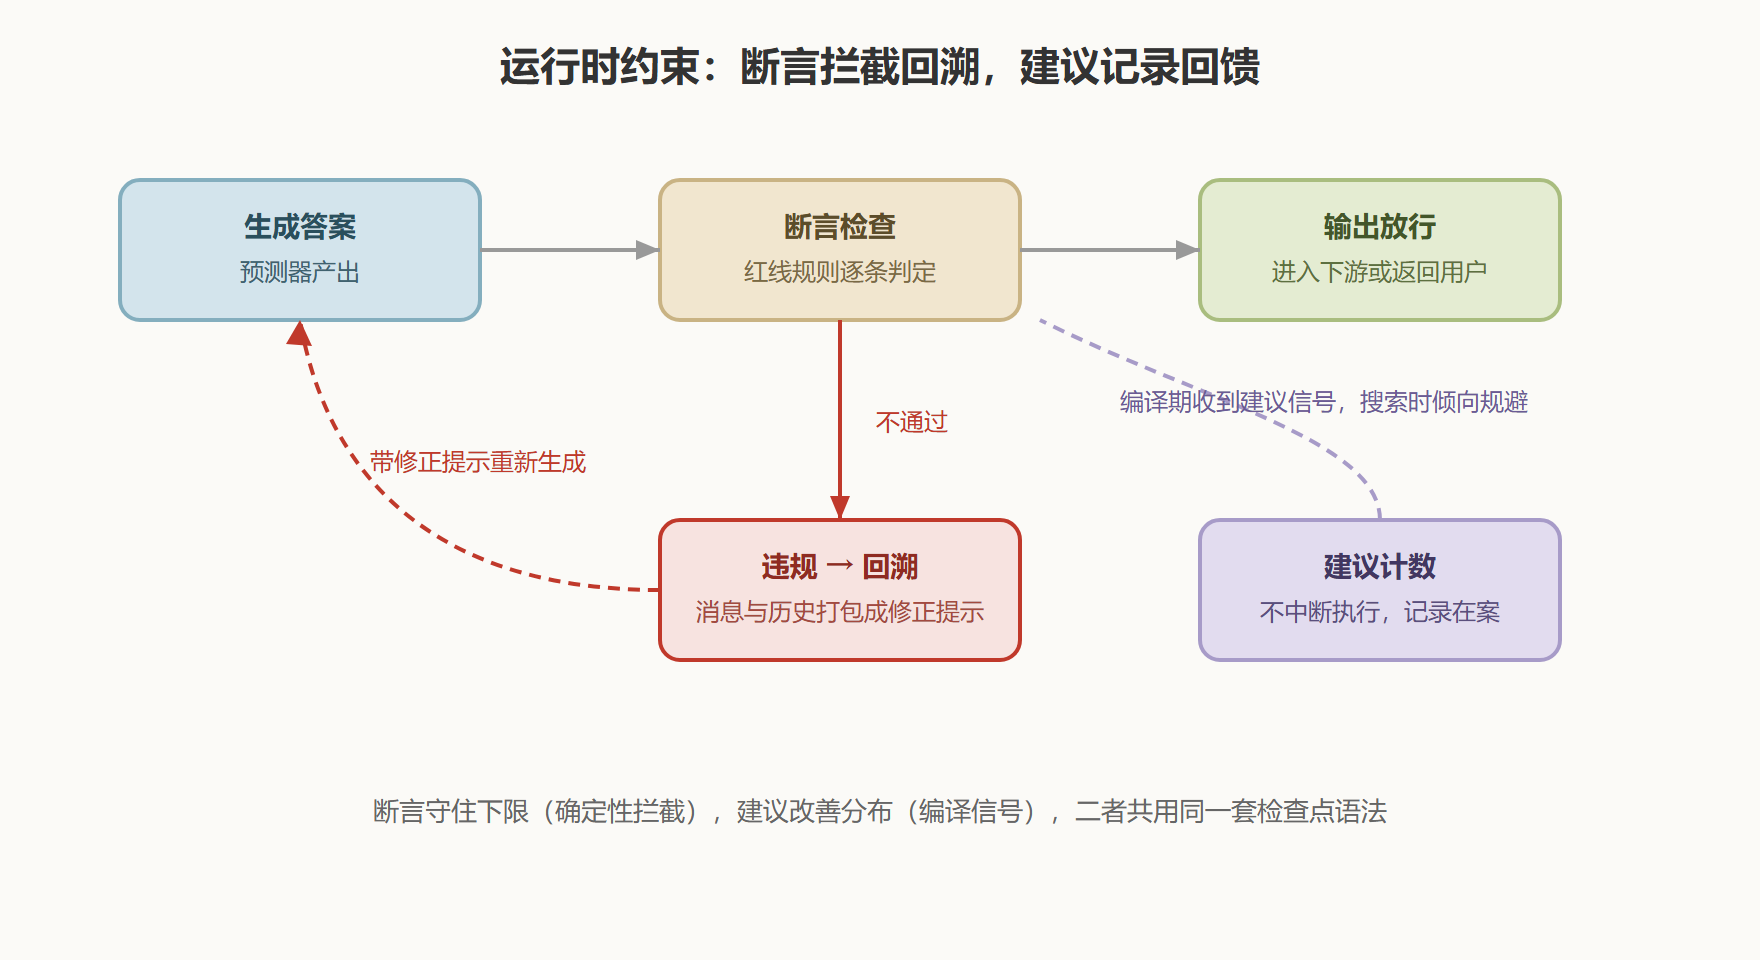
断言的失败触发回溯:框架捕获违规,把断言消息与历史尝试打包成修正提示,让目标模块重新生成——相当于把"返工指令"直接递回给闯祸的那一步,而不是让整条链路作废。建议的失败只记录计数,执行继续。两者的代价模型因此不同:断言买的是"确定性"(输出要么达标要么重试到达标),支付的是重试的时延与调用成本;建议买的是"信息"(哪里在失守),支付几乎为零。布点原则随之而来:红线规则(安全、格式底线、禁词)用断言,质量倾向(长度、风格、覆盖度)用建议——红线不容协商,倾向交给编译期慢慢学。
图:断言与建议的运行时回溯
与编译器的信号回路
断言机制最深的演化意义在编译期:自举与搜索阶段,断言与建议的触发记录会回馈给优化器——频繁触发建议的候选程序得分被压低,触发断言的轨迹直接出局。这让运行时约束从"事后的补丁"升格为"编译的隐形指标"。实践里这个回路最好用的一点是表达式检查规则的积累方式:你不需要预先把所有约束写成指标函数(有些约束写在指标里成本很高),在模块里随手放建议检查,编译器自然学会绕开高频违规区。约束的编写成本从"设计指标"降到"写一行判断",质量管理的门槛显著下降。
代价控制有一条铁律:断言的回溯次数要封顶。框架允许配置重试上限,生产环境务必设置(建议不超过 2 到 3 次)并记录最终失败率——一个回溯率常年偏高的断言,说明它在对抗任务的固有分布,正确做法是回头改结构或改提示策略,而不是放任它烧预算。
约束的编译期收益:一组对照数字
约束回馈编译的收益有多实在?一组来自多跳问答任务的对照数字可以说明。同样的程序与数据,分三种配置各编译评估:无约束基线、仅建议约束、断言加建议组合。结果是:基线端到端准确率七成出头;加了查询形态建议(约束中间查询词的长度与来源)后,检索命中率明显改善,端到端分数上浮;再加"依据必须来自证据"的出口断言后,编造类错误基本清零,总分再上一个台阶。三段收益里最值得注意的是建议的贡献路径——它没有拦截任何一次线上调用,纯粹通过编译期信号让优化器学会了规避高频违规区。约束在这里扮演的是"用一行判断改写搜索方向"的角色,性价比远超手工重写指标。
这套机制也重新定义了"提示词优化"的边界:编译器优化的不只是指令与示范,还包括约束信号指引下的行为分布。你给程序的每一行可判定的业务规则,都在参与塑造编译结果——约束写得越清晰,编译器替你守得越准。
两种常见误用与纠正
断言机制的误用也有典型两型。误用一,把统计指标塞进断言:有人希望"答案质量高于某个分数"用断言强制,于是每次生成后先跑一遍裁判模型再判定——断言的本意是可判定的确定性规则(格式、禁词、引用存在性),把主观裁判挂进断言,等于给每次调用加一个高成本的随机门禁,回溯率忽高忽低还无法归因。正确归宿是让质量信号走指标与编译(3.5 节),断言只守可判定的底线。误用二,断言条件过强导致重试风暴:条件写成了"答案必须覆盖全部要点"这类生成难度极高的强约束,回溯上限内几乎必然失败。判断标准很简单:一条断言在验证集上的通过率低于八成,说明它超出了模型当前能力边界——要么降级为建议交给编译期消化,要么回到上游改签名与示范,硬扛不是选项。
两型误用的共同根源是把断言当成了万能质检员。它真正的定位是执行路径上的最后一道闸:拦得住的确定性违规,交给它;拦不住的质量分布问题,交给指标、编译与结构设计。各司其职,机制才运转得久。
布点策略与实战清单
布点看三处。入口处:对用户输入做断言(长度上限、语言检测),把畸形输入挡在链路外。中间节点:每个会把错误放大的交接点(查询生成、证据聚合)布建议,监控失守率;对会直接触达用户的红线(依据必须来自证据、禁用词表)布断言。出口处:最终输出的格式断言(可解析、字段齐全),保住下游系统的解析兼容。
一份可迁移的检查清单:链路里每个预测器,问一遍"它的哪种输出会毒害下游?"——会毒害的就是布点位置;每条红线,问一遍"违反的代价是否不可接受?"——不可接受就用断言并封顶重试;每条倾向,问一遍"能否交给编译期慢慢学?"——能就降级为建议。三问之后,约束系统基本就位。它与 3.5 节的指标、5.1 节的评估构成完整的质量三角:指标定义方向,评估度量结果,约束守住每一次单次调用。
布点策略再配一个完整的 worked example。某工单摘要程序,链路是"抽取关键事件、按时间线整理、生成摘要"三个预测器。按三问逐点过:抽取器的哪种输出会毒害下游?事件时间戳缺失或错位——会在时间线整理时被放大成顺序错乱。这条是红线(时间线错误直接误导读者),且可代码判定(时间戳非空且格式合法),落成入口断言。时间线整理器的风险呢?事件归并错误——把两次相似事件并成一条。语义判断无法代码化,且并非每次都致命,落成建议(相似度高的相邻事件记录归并标记),让编译期慢慢学会规避。摘要器的出口呢?摘要必须每条事件都提及——这是硬性业务底线,落成出口断言,回溯封顶两次。三处布点,一次说清:红线断言、倾向建议、出口封顶,各就各位。
本节要点回顾
- 分工明确:断言守红线(不达标即回溯重来),建议记倾向(不中断、回馈编译);红线不容协商,倾向交给搜索。
- 回溯机制:违规消息与历史尝试打包成修正提示,定向返工闯祸的模块,而非整链作废。
- 信号回路:断言与建议的触发记录参与编译期打分,约束从补丁升格为隐形指标。
- 代价铁律:回溯必须封顶并监控最终失败率;长期高回溯的断言是在对抗分布,该改的是结构。
- 通向下一节:约束保证了"依据不足时老实说",但证据本身从哪来?知识源的接入与边界管理在下一节展开。