6.1 问答系统与对话机器人
6.1 问答系统与对话机器人
本节摘要:以一家内容平台的客服困境为案例,完整交付一个检索增强问答系统:任务建模、证据契约、编译与评估的全过程,多轮对话的历史管理,以及上线前的最后一轮取舍。这是全册知识的首次综合实战——前五章的每个概念都会在这里各就各位。
场景代入:一家内容平台的客服困境
某内容平台有几十万篇付费文章,客服团队每天应付上万个重复问题:"XX 课程的退款规则是什么""作者 XX 的专栏更新频率""我买的合集为什么看不到第 4 章"。人工客服疲惫不堪,早期上过一版手工提示词机器人,结局可以预料:规则越补越多、答非所问频发、没人敢动那份巨型提示词——第 1 章的全部痛点在一家公司里重演了一遍。
任务分析决定了它适合 DSPy 化改造:问题高度重复(适合知识库问答而非开放聊天)、答案必须锚定平台规则文档(证据在模型知识之外,必须检索)、错误代价高(编造退款规则是客诉事故)。三条特性分别对应 DSPy 的三个组件:重复性让标注积累可行(客服历史工单就是现成的训练数据来源),证据外部化要求检索集成,高代价要求认输契约与断言防线。
程序建模:证据、引用与认输
核心程序三件套:检索、作答、引用校验。签名把证据契约写死:
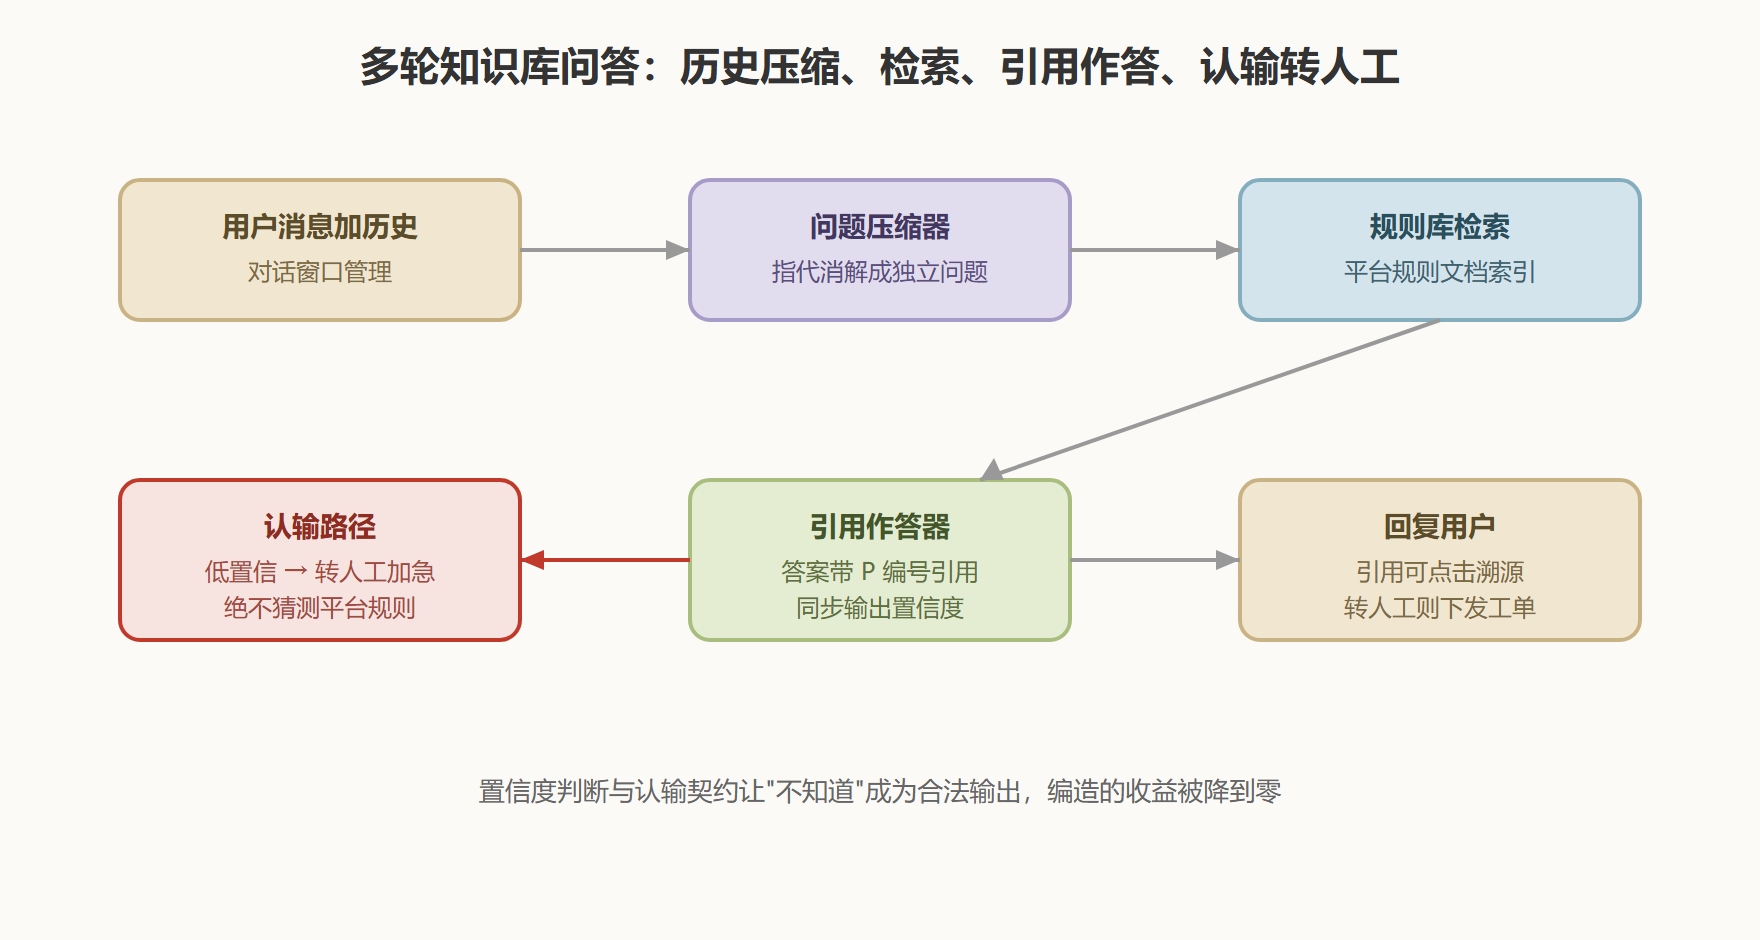
import dspy class AnswerWithCitation(dspy.Signature): """仅依据给定平台规则文段回答用户问题。 回答需标注依据编号;文段不足以回答时,明确说明无法从规则文档确认。""" history = dspy.InputField(desc="与客服的近期对话记录,可能为空") context = dspy.InputField(desc="编号后的平台规则文段:P1、P2……") question = dspy.InputField() answer = dspy.OutputField(desc="简短回答,句末标注依据如 [P2]") confidence = dspy.OutputField(desc="high / low,表示证据充分性") class KBQA(dspy.Module): def __init__(self, k: int = 5): super().__init__() self.retrieve = dspy.Retrieve(k=k) self.answer = dspy.ChainOfThought(AnswerWithCitation) def forward(self, question, history=""): query = self._condense(question, history) # 多轮:先压缩为独立问题 passages = self.retrieve(query).passages context = "\n".join(f"P{i+1}: {p}" for i, p in enumerate(passages)) pred = self.answer(history=history, context=context, question=question) if pred.confidence == "low": # 认输路径:礼貌转人工,不猜答案 return dspy.Prediction(answer="这个问题我需要转人工确认,已为您加急。", grounded=False) return dspy.Prediction(answer=pred.answer, grounded=True) def _condense(self, question, history): if not history: return question return self.condense(question=question, history=history).standalone_question
三个设计点对应前文的讲义:confidence 字段把认输机制做成一等公民(4.3 节的坏情况契约);[P2] 式引用让每条答案可追溯(5.4 节的引用纪律);多轮对话的历史压缩成独立问题再检索(对话机器人的关键技巧——用户说"那第二个方案呢"时,直接拿去检索必然失败,先压缩成完整问题)。
图:多轮对话问答系统架构
编译与评估:历史工单变训练集
客服历史工单是现成的标注源:问题加人工客服的最终回复(抽取核心事实作为标准答案)。按 4.1 节的纪律整理出两百余条,三分切分。指标用分层设计:引用格式的正则断言(答案必须含 [P数字])、事实部分的语义裁判(裁判模型与生成模型异源)、认输出的单独计分(低置信认输且规则文档确实无据的,算对)。编译路径按第 4 章的标准打法:BootstrapFewShot 起步(max_bootstrapped_demos=4),基线七成上下;上 MIPROv2(auto="medium",num_trials=20)冲到八成六;其中"转人工认输"的准确率是运营方最关心的分项——从编译前的五成四提到九成二,因为他们最怕的不是答不出,而是编规则。
评估回路的最后一块拼图是线上反馈闭环:每次转人工的会话,人工客服的最终答复回流进训练候选池,经抽检后入回归集——系统上线的那天才是数据飞轮开始转的那天。
上线后的第一周:真实数据与调整
这套系统上线第一周的运营数据,比任何实验室指标都有说服力,值得原样复盘。请求量按预期兑现,但三个数字偏离了预估,每个都触发了一次调整。第一,认输率显著高于验证集水平——线上用户的问题形态远比训练集发散,大量问题其实该命中规则文档却检索失败。处理:不是调模型,而是扩充规则文档的索引覆盖(把散落在公告里的规则正文收进索引),一周后认输率回落一半以上。第二,引用格式偶发缺失,集中在长回答上——输出截断吞掉了句末的引用标注。处理:max_tokens 给足并加一条出口建议检查(答案必须含引用标记),重试兜底。第三,多轮对话的压缩器在超长历史下失灵——窗口外的指代无法消解。处理:压缩器输入改为"滚动摘要加最近几轮"的两段式,压缩质量恢复稳定。
一周三修,没有一次动到编译产物本体——三次都是数据、参数与外围结构层面的修正。这个分布不是巧合,而是编译范式的常态收益:当你把提示词从"随时要改的文本"变成"受控的编译产物"之后,系统的大多数质量问题会显形为外围工程问题,修起来反而更快、更稳。监控面板上四个信号(失败率、延迟、认输率、成本)的日常波动,也从此都有明确的归属排查路径。
这周还顺手建成了数据飞轮的第一环:所有转人工的会话,人工客服的最终答复自动归档进训练候选池,经人工抽检后入回归集。配套的组织约定只有一条——回流数据必须过抽检这道闸,客服的回复同样有错误与临时口径,不设闸的飞轮转着转着就会把噪声当营养。抽检比例可以随系统成熟度递减,闸门本身永远保留。
本节要点回顾
- 任务特性定组件:重复性对应标注可行、证据外部化对应检索集成、高代价对应认输契约——先做这个映射再写代码。
- 认输是一等公民:置信字段加认输路径,"无法确认"成为合法输出;业务方最怕编造而非无知。
- 多轮的关键技巧:历史压缩成独立问题再检索,指代与省略在检索前消解。
- 数据飞轮:历史工单做训练集起步,线上转人工案例回流做增量——上线是数据运营的开始而非结束。
- 通向下一节:问答把答案"说"出来,抽取要把事实"写"进结构化字段——另一种契约形态在下一节展开。