2.4 空间数据库建库与入库质检
2.4 空间数据库建库与入库质检
本节摘要:建库是把散装数据变成组织化资产的一步,本节讲要素数据集与要素类的分层设计、字段约束与编码规范,以及入库前的最后一道质检关卡。第 2 章四道工序在此收官:数据体面入库,后面的多人协作、分析与发布才有可靠地基。
一份建库设计书
见过太多项目"先把数据导进去再说",三个月后字段名中英混杂、同名图层出现四个版本、没人说得清哪个是权威。建库之前需要一份哪怕只有两页的设计书,回答三个问题:库怎么分层、类怎么命名、字段怎么约束。
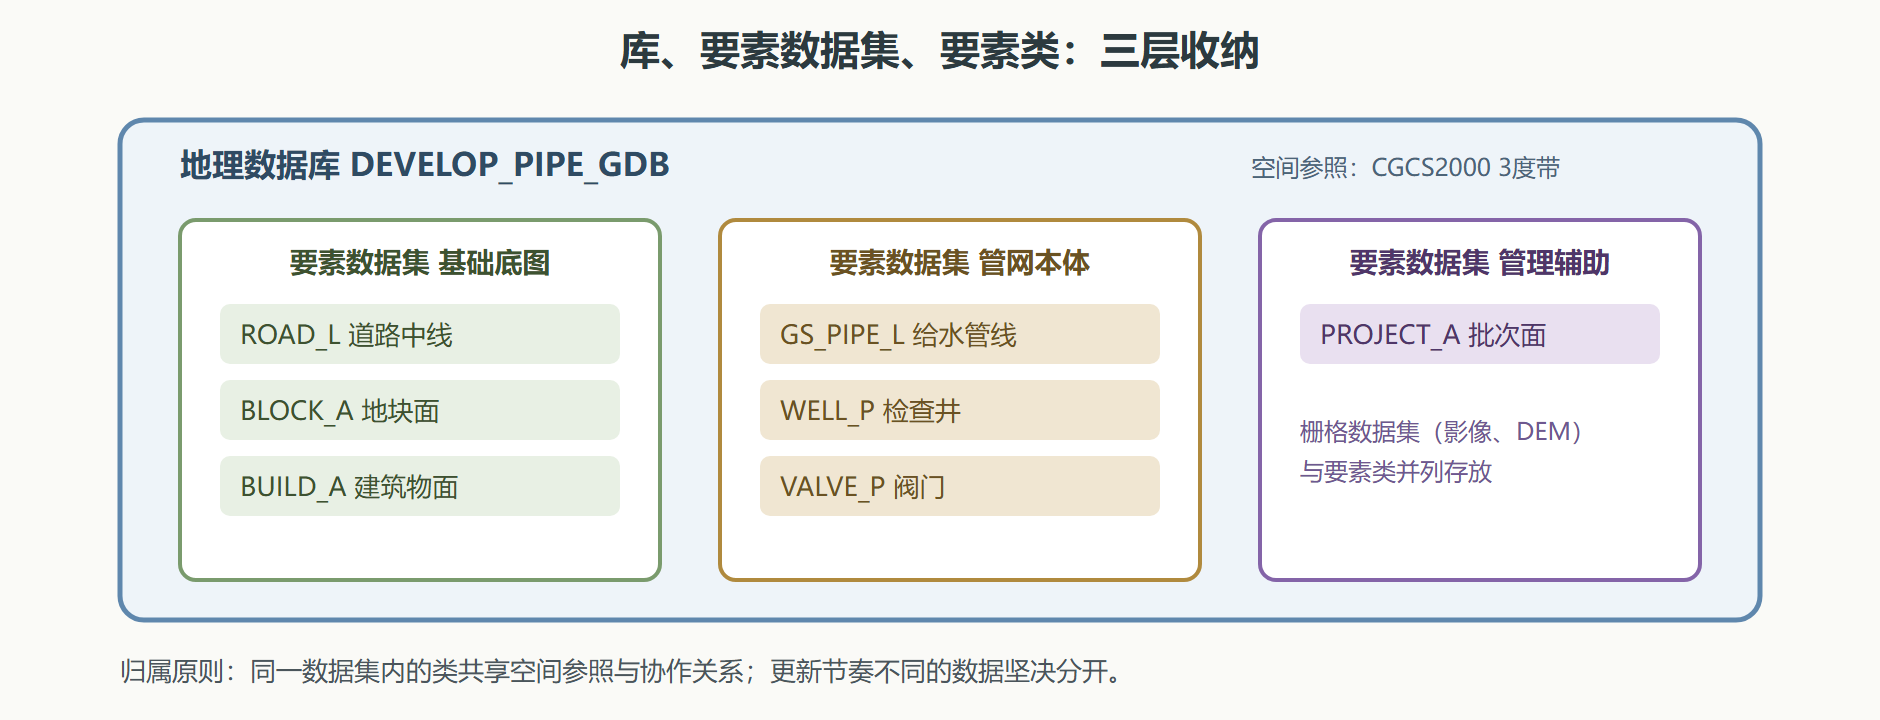
地理数据库的组织层级从上到下是:库、要素数据集、要素类(以及栅格数据集)。要素数据集把共享同一空间参照、逻辑上协同工作的要素类归成一组;要素类是最小单元,一个要素类一个几何类型。用开发区的管网库举例:
# 管网普查数据库分层设计(节选) 库:DEVELOP_PIPE_GDB 空间参照:CGCS2000 高斯3度带(带号38) 要素数据集:BASE_BASEMAP 基础底图 要素类: ROAD_L 道路中线 线 BLOCK_A 地块面 面 BUILD_A 建筑物面 面 要素数据集:PIPE_NETWORK 管网本体 要素类: GS_PIPE_L 给水管线 线 WS_PIPE_L 污水管线 线 YS_PIPE_L 雨水管线 线 WELL_P 检查井 点 VALVE_P 阀门 点 要素数据集:MANAGE_AUX 管理辅助 要素类: PROJECT_A 普查批次面 面 # 命名规则:业务前缀 + 几何类型后缀(L线 P点 A面),全程大写,禁用拼音数字混拼 # 分层原则:底图与管网分属不同数据集——更新周期与权限归属完全不同
图:地理数据库的分层组织
字段与编码:给数据立规矩
字段层面的规矩决定了三年后这库还能不能用。三条铁律:必填的身份字段(每个要素类都要有唯一标识字段与数据来源字段)、受约束的取值(地类码、管径、材质用受控词表,杜绝自由文本)、可追溯的时间字段(采集时间与更新时间分开)。看给水管线的字段设计:
# 要素类 GS_PIPE_L 字段约束设计(节选) 字段名 类型 约束 说明 PIPE_ID 字符12 唯一,非空 管段唯一编码 MATERIAL 字符10 值域:铸铁/球墨铸铁/PE/PVC 材质受控词表 DIAMETER 整型 值域:100至2000 公称直径,毫米 BURIED_Y 整型 值域:1970至2025 埋设年份 DEPTH 双精度 值域:0.3至8.0,两位小数 管顶埋深,米 SOURCE 字符20 值域:普查/竣工图/物探 数据来源 UPD_TIME 日期 默认当天 更新时间 # 错误示范:材质字段存过"球磨铸铁""球铁""QT"三种写法—— # 同一种东西三种拼法,统计分组就是三组,谁也说不清总量
入库质检:最后一道关口
数据过完 2.1 到 2.3 的工序后,入库前还要过一次成体系的质检。这份清单可以直接抄进项目文档:
# 入库质检清单(七查) 一查坐标:空间参照声明与数值范围双核对(1.3 节方法) 二查拓扑:错误数归零或有白名单说明(2.3 节方法) 三查数量:源数据要素数与入库后要素数一致 四查字段:必填字段无空值,受控字段无越界值 五查接边:跨图幅要素几何连续,无接边错位 六查逻辑:管段两端必须有井(网络类的业务规则) 七查元数据:每个要素类配齐来源、时点、精度说明 # 执行方式:逐项跑检查工具,输出质检报告,签字归档—— # 质检报告是这个库出生时的体检单,三年后排查问题全靠它
案例复盘:管网库的入库验收
背景:接 2.1 节的管网普查项目,数据全部整理完毕,等待入库验收。甲方要求两周内交付可用库。
操作:按七查清单逐项执行。前三查顺利:坐标全部统一为 CGCS2000,拓扑错误清零,管段数与外业台账一致。第四查处出问题:材质字段抽查 200 条,发现 11 条填写"球铁"、6 条填写"QT",受控词表里只有"球墨铸铁"一种写法。第六查的逻辑检查用空间叠加完成:找出两端 1 米内没有检查井的管段,共 23 条。
结果:材质字段按对照表批量归一(球铁、QT 均映射为球墨铸铁);23 条"孤儿管段"退回外业核实,其中 19 条补测了井位,4 条为废弃管段标记删除。质检报告随库归档,工期第十天交付。
解读:这次验收里最值钱的是第六查——业务规则检查。通用 GIS 工具不会知道"管段两端必须有井",这是行业知识,必须由建库者翻译成空间检查(管段端点与井点做邻近判断)。质检的深度,取决于你对业务的理解深度。
变式:若是土地利用库,第六查换成"图斑面积之和与上级控制面积吻合";若是地名地址库,换成"地址点必须落在所属行政区内"。清单框架不变,业务规则按行业替换。
💡 关键直觉:数据库不是数据的仓库,是数据的宪法——分层是行政区划,字段约束是法律条文,质检是立宪会议。宪法立得潦草,后面每一届"政府"(分析、发布、开发)都要为解释混乱付出代价。
收官与展望
第 2 章四道工序走完:接入(2.1)、统一坐标(2.2)、整形(2.3)、入库(2.4)。数据从散装原料变成了有组织、有约束、有体检报告的资产。下一章开始深加工——查询、分析、建模,把数据变成结论。
进厂工序的最后交代两件运营层面的安排。备份策略在建库当天就要落地:库文件每日增量、每周全量,备份介质离机存放——见过太多项目库建了三年没有一次备份,磁盘一响全项目归零。权限划分同样趁早:编辑权按乡镇或科室切分,查询权放开给全员,管理权只留一两人;权限拖到多人协作开始后再划,历史数据的责任边界就说不清了。
# 建库当天的两份运营配置(模板) 备份 每日增量备份 夜间自动 保留14天 每周全量备份 周日自动 保留8周 每月归档备份 异地存放 保留按档案规定 权限 编辑角色 按辖区划分 可写本辖区要素类 查询角色 全库只读 覆盖业务科室 管理角色 建库改结构 权限仅一两人 # 检验:随机挑一天 问自己"昨天的库坏了能恢复到什么时点" 答不上就是没做
本节要点回顾
- 三层收纳:库、要素数据集、要素类各司其职,更新节奏不同的数据坚决分集
- 命名三一律:业务前缀加几何后缀、全程大写、禁混拼,从源头消灭同名异义
- 字段铁律:身份字段必填、取值受控、时间可溯,受控词表是统计的前提
- 七查清单:坐标、拓扑、数量、字段、接边、逻辑、元数据,逐项出报告
- 业务规则:最深度的质检来自行业知识翻译成的空间检查,工具不会替你懂业务