2.1 建档与改档案:数据类型与DDL
2.1 建档与改档案:数据类型与 DDL
本节摘要:数据类型决定存储方式和索引效率,DDL 决定表的未来可维护性。本节给出常用类型的选择依据、建表示范,以及 ALTER 在大表上的风险与替代做法。
类型选择:第一张化验单
CREATE TABLE clinic_order ( order_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id BIGINT UNSIGNED NOT NULL, amount DECIMAL(10,2) NOT NULL, status TINYINT UNSIGNED NOT NULL DEFAULT 0, remark VARCHAR(500) DEFAULT NULL, created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP, KEY idx_user_created (user_id, created_at) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
几个有争议的选项,说下我的倾向:
- 金额用
DECIMAL,不用 FLOAT/DOUBLE——浮点误差在对账时是事故 - 状态这类小枚举用
TINYINT,一个字节搞定,比 VARCHAR 索引友好得多 VARCHAR(500)的长度是字符数不是字节数,按真实上限给即可,过长并不会立即浪费磁盘,但会影响排序内存分配- 时间字段要么 DATETIME 要么 TIMESTAMP,别用字符串存时间,否则所有按时间范围的查询都告别索引
NULL 不是零也不是空串,它是一个"未知"状态。列上大量 NULL 会让统计信息失真、让 != 判断写法翻车。能 NOT NULL 就 NOT NULL,给默认值。
改档案:ALTER 的暗坑
ALTER TABLE clinic_order ADD COLUMN channel TINYINT UNSIGNED NOT NULL DEFAULT 0;
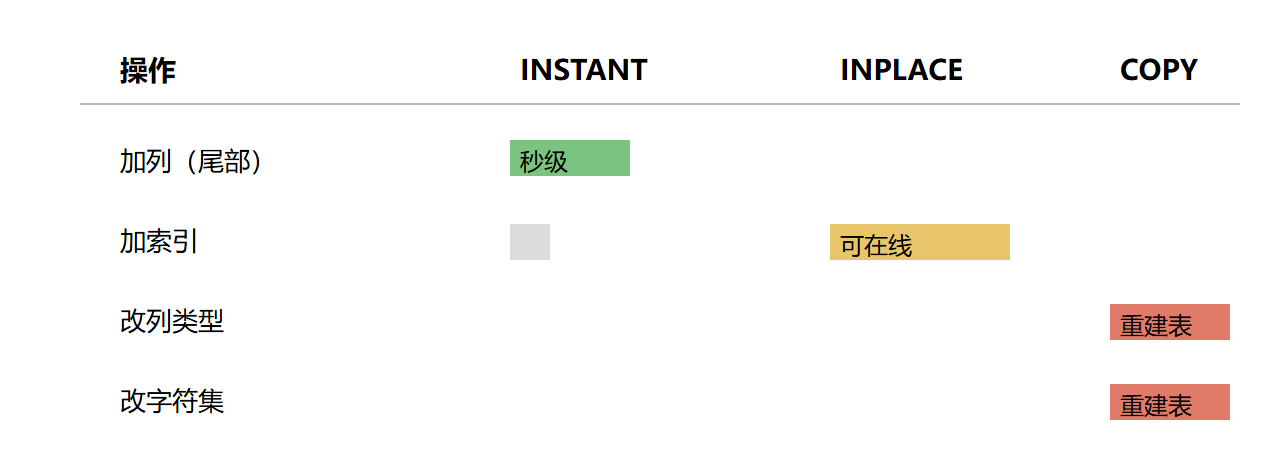
小表上随手执行没问题。大表上,某些 ALTER 会重建整张表,锁数小时。8.0 的 INSTANT 算法已经让"加列"变得秒级,但改列类型、改字符集这类操作仍是重活:
ALTER TABLE clinic_order MODIFY remark VARCHAR(1000), ALGORITHM=INSTANT; -- 如果不支持会报错,而不是偷偷换慢算法
⚠️ 常见坑:不加 ALGORITHM 就执行大表 DDL,默认可能选 COPY,线上卡死。养成显式声明预期算法的习惯,不支持就提前换 pt-online-schema-change 这类在线改表工具。
图:DDL 算法成本对比
类型对照表:一张按病情开的化验单
零散的记忆不如一张对照表牢靠,把常用场景的类型选择收敛成速查:
| 业务含义 | 推荐类型 | 反面教材 | 反面代价 |
|---|---|---|---|
| 金额 | DECIMAL(10,2) | FLOAT/DOUBLE | 对账差分,事故级 |
| 状态枚举 | TINYINT UNSIGNED | VARCHAR(20) | 索引变大,拼写错误难拦 |
| 布尔 | TINYINT(1) | CHAR(1) | 语义含混 |
| 手机号 | VARCHAR / CHAR(11) | BIGINT | 前导零丢失,国际号存不下 |
| 创建时间 | DATETIME | VARCHAR | 时间范围查询告别索引 |
| 超长文本 | TEXT | 巨大 VARCHAR | 内存排序代价失控 |
| IP 地址 | VARCHAR(45) 或 VARBINARY | INT | IPv6 存不下或转换繁琐 |
每个推荐背后都有一桩真实病例。手机号存 BIGINT 的表,某天接入海外号段带加号和前导零,写进去就变了形,修复时全表回填了整整一夜。时间存字符串的报表库,跨夏令时的海外数据排序全乱。类型选错是"出生病",越晚发现手术越大。
字符集与排序规则:建表时的隐藏选项
utf8mb4 现在已是默认,但存量表里还埋着大量老的 utf8(最多三字节,存不了表情符号)。检查与修复:
-- 查看表的字符集 SHOW CREATE TABLE clinic_order\G -- 转换字符集,注意它会重建表,大表走在线工具 ALTER TABLE clinic_order CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci;
排序规则同样要留意:0900_ai_ci 是大小写不敏感的,若 user_name 要区分大小写登录,建列时就要显式声明二进制排序规则,事后改排序规则等于改了"相等"的定义,唯一键可能当场报重复。
大表改档案的完整流程
ALTER 的风险前面提过,完整的手术流程值得走一遍。第一步确认表多大、什么算法可用:
-- 看行数与平均行长,估体积 SELECT table_rows, data_length/1024/1024 AS data_mb FROM information_schema.tables WHERE table_schema='clinic' AND table_name='clinic_order'; -- 先在预演环境试跑,确认 INSTANT 是否被支持 ALTER TABLE clinic_order ADD COLUMN ext_ref VARCHAR(64) DEFAULT NULL, ALGORITHM=INSTANT;
第二步评估主从延迟:COPY 算法的重建在主库执行,从库重放重建语句会成倍落后,低峰期执行并盯紧延迟。第三步超大的表(百 GB 级)换 pt-online-schema-change,它靠影子表加触发器同步增量,业务几乎无感——这个工具在 8.2 节的工具箱里还会出场。
一条容易被忽略的细节:ALGORITHM=INPLACE 不是 INSTANT,它不重建表但仍可能阻塞 DML 片刻,且要在Prepare 阶段拿元数据锁。改档案没有真正的免费午餐,只有代价大小之分。
本节要点回顾
- 类型即命运:DECIMAL 存钱、TINYINT 存枚举、时间用原生类型
- NULL 慎用:默认 NOT NULL 加默认值
- DDL 显式声明算法:大表改结构先评估是否 INSTANT,否则走在线工具