2.2 日常用药:DML与SELECT查询
2.2 日常用药:DML 与 SELECT 查询
本节摘要:INSERT、UPDATE、DELETE 与 SELECT 是每天要开的药。本节聚焦写法层面的性能与安全差异:批量插入、带 LIMIT 的更新、分页查询的深翻页问题。
三条安全守则
先立规矩,再谈效率:
-- 守则一:UPDATE/DELETE 必须先 SELECT 确认影响范围 SELECT COUNT(*) FROM clinic_order WHERE status = 9 AND created_at < '2025-01-01'; -- 确认数量合理后再动手 UPDATE clinic_order SET status = 9 WHERE status = 8 AND created_at < '2025-01-01'; -- 守则二:大变更永远带 LIMIT 分批 DELETE FROM audit_log WHERE created_at < '2024-01-01' LIMIT 1000; -- 守则三:插入用显式列名,别依赖表结构顺序 INSERT INTO clinic_order (user_id, amount, status) VALUES (1001, 59.90, 0);
不带 WHERE 的 UPDATE 是数据库界的"全麻手术",诊断环境里可以试一次感受一下,生产里一次都不能有。
批量插入的正确姿势
-- 一条一条插 1 万行:1 万次网络往返 -- 攒成一批: INSERT INTO clinic_order (user_id, amount, status) VALUES (1001, 59.90, 0), (1002, 33.00, 0), (1003, 12.50, 1);
单批几百到一两千行是比较舒服的区间,太大反而冲击 binlog 与主从延迟。
深翻页:一个经典病例
-- 病例:运营后台导出,翻到第 10 万页 SELECT * FROM clinic_order ORDER BY order_id LIMIT 1000000, 20; -- 症状:越翻越慢,最后超时
MySQL 必须真的扫过并丢弃前 100 万行。处方是"记住上次位置"的游标式翻页:
SELECT * FROM clinic_order WHERE order_id > 1001000 ORDER BY order_id LIMIT 20;
图:深翻页两种写法的扫描量对比
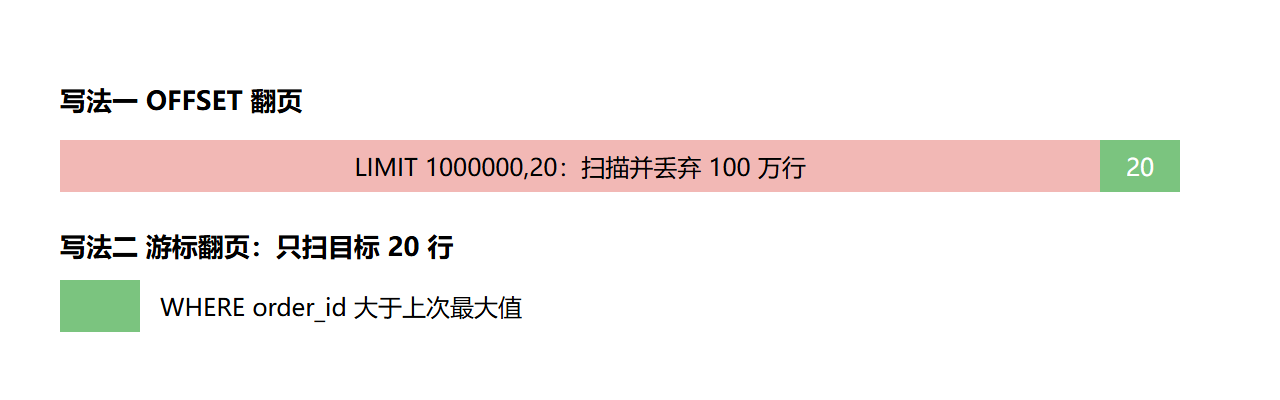
💡 关键直觉:OFFSET 不是"跳到第 N 行",是"数完前 N 行再扔掉"。凡是页码很深的接口,都应该改成游标。
UPSERT:存在就更新,不存在就插入
幂等写入是电商与日志场景的刚需,MySQL 的专写法是 INSERT ... ON DUPLICATE KEY UPDATE:
-- 购物车语义:同一用户同一商品只留一条,重复加购就累加数量 INSERT INTO cart (user_id, sku, quantity) VALUES (1001, 8888, 1) ON DUPLICATE KEY UPDATE quantity = quantity + 1; -- 需要区分"插入了"还是"更新了",看受影响行数:1 是插入,2 是更新
它还有一个孪生兄弟 REPLACE INTO,语义是冲突先删再插。两者的差别是生死攸关的:REPLACE 会删掉旧整行再插入新行,没出现在语句里的列会被重置成默认值,而且删除动作会触发级联与自增跳号。多数业务想要的是 ON DUPLICATE KEY UPDATE,REPLACE 只适合"整行覆盖"语义明确的场景。
更新的完整病例:一次差点删库的批量操作
把本章守则串成一个完整病例。现象:运营要求把某活动期间所有待支付订单置为已取消,共约 37 万行。值班同学直接执行了一条不带 LIMIT 的 UPDATE,行锁从第一条一直改到最后一条,binlog 单事务 300 多 MB,从库重放卡了四分钟,期间读写分离的读接口全部读到旧数据,被用户截图发到了社交平台。
正确的手术分三步。先查范围并核对数量:
SELECT COUNT(*) FROM clinic_order WHERE status = 0 AND created_at BETWEEN '2026-08-01' AND '2026-08-03';
再分批更新,每批两千行,批间提交释放锁:
UPDATE clinic_order SET status = 4 WHERE status = 0 AND created_at BETWEEN '2026-08-01' AND '2026-08-03' LIMIT 2000; -- 影响行数为 0 时收工;注意主键续跳的表要改用 id > 上次最大id 的条件翻页
最后抽样复核与对账。这条流程里每一步都可以在前一章的环境里演练,成本几乎为零——这也是"诊断环境敢乱动"的价值所在。
SELECT 的书写顺序与执行顺序
写 SQL 久了容易忽略一件事:书写顺序与执行顺序是两套体系。书写是 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY、LIMIT,执行却是 FROM 先行、WHERE 过滤、分组、聚合、HAVING 再过滤分组结果、SELECT 选列、最后排序截断。理解执行顺序能解释很多"看起来对却报错"的写法:
-- 报错:WHERE 里用了 SELECT 起的别名,执行时别名还没诞生 SELECT user_id, COUNT(*) AS cnt FROM clinic_order WHERE cnt > 3 GROUP BY user_id; -- 正确:过滤聚合结果要用 HAVING SELECT user_id, COUNT(*) AS cnt FROM clinic_order GROUP BY user_id HAVING cnt > 3;
同理,同层查询里别名能在 ORDER BY 用(排序在选列之后),不能在 WHERE 用。这个执行顺序的心智模型,到第 4 章读执行计划时会再次派上用场。
聚合与分组的两个细节
分组统计是报表的主力,两个细节决定它是快是慢。第一个细节是 WHERE 与 HAVING 的分工:能在 WHERE 阶段过滤的行,绝不留到 HAVING。前者在扫描时就把行丢掉,后者要等分组聚合完再丢,工作量差一个数量级:
-- 慢:先对所有用户分组,再扔掉小用户 SELECT user_id, COUNT(*) c FROM clinic_order GROUP BY user_id HAVING user_id % 10 = 0; -- 快:扫描阶段就过滤 SELECT user_id, COUNT(*) c FROM clinic_order WHERE user_id % 10 = 0 GROUP BY user_id;
第二个细节是分组隐含的排序。老版本 MySQL 的 GROUP BY 默认带排序,8.0 已取消,但显式 ORDER BY NULL 不再需要的习惯仍有价值——它逼着写语句的人想清楚"我要不要顺序",这个意识比任何单个语法都重要。
计数的精确与妥协
COUNT 是被低估的深坑。InnoDB 的 COUNT(*) 要真数行数(事务可见性决定它没法存一个全局精确值),两千万行的表裸数一次可能要十几秒。三种工程妥协按场景选:估算值够用时读 SHOW TABLE STATUS 或 EXPLAIN 的 rows,毫秒级;要较准的近似值用统计表加定时任务;列表页的"共 N 条"直接砍掉或封顶显示"999+"——用户并不需要精确总数,需要的是产品经理放过这条 SQL。
本节要点回顾
- 写操作三守则:先查范围、分批带 LIMIT、显式列名
- 批量插入:几百行一批,别单行循环
- 深翻页:OFFSET 换游标,扫描量从百万级降到常数级