4.1 病理切片:B-Tree索引原理
4.1 病理切片:B+ 树索引原理
本节摘要:InnoDB 用 B+ 树组织索引,主键构成聚簇索引,叶子节点就是数据本身;二级索引叶子存主键值,命中后可能需要回表。理解最左前缀与索引失效场景,是索引处方的药理基础。
树为什么快
一千万行的表,B+ 树高度通常只有 3 到 4 层,一次主键查找等于三四次页访问,其中前几层几乎总在缓冲池里。顺序扫描一千万行的对比之下,差距是几个数量级。
CREATE TABLE clinic_order ( order_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id BIGINT UNSIGNED NOT NULL, status TINYINT UNSIGNED NOT NULL, created_at DATETIME NOT NULL, KEY idx_user_created (user_id, created_at) );
这张表里有两棵树:
- 聚簇索引(主键):叶子节点直接挂整行数据
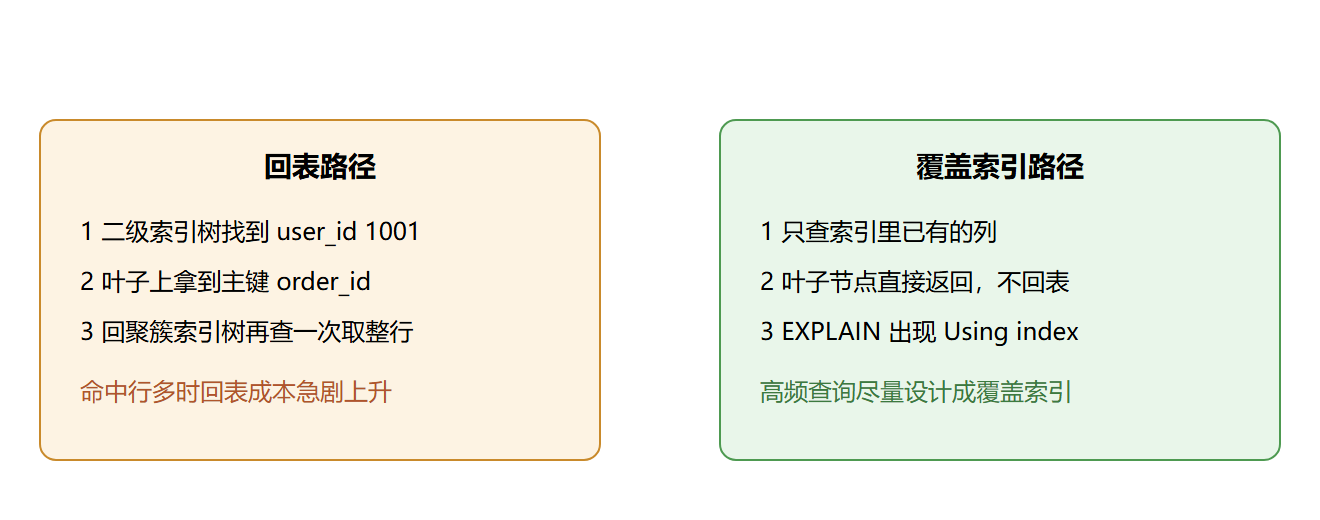
- 二级索引 idx_user_created:叶子节点挂 user_id、created_at 加上主键 order_id
按 user_id 查 order_id 时,二级索引里就有全部答案,不用再回聚簇索引取整行——这叫覆盖索引,EXPLAIN 里显示为 Using index,是性价比最高的查询形态。
最左前缀:联合索引的入口规则
索引 (user_id, created_at) 像电话簿按"姓、名"排序:知道姓能二分,只知道名只能全本翻。
-- 能用上索引 SELECT * FROM clinic_order WHERE user_id = 1001 AND created_at > '2026-01-01'; SELECT * FROM clinic_order WHERE user_id = 1001; -- 用不上(缺了第一列) SELECT * FROM clinic_order WHERE created_at > '2026-01-01';
索引失效病例三连
-- 病例一:函数包住索引列 SELECT * FROM clinic_order WHERE DATE(created_at) = '2026-08-01'; -- 处方:改写成范围条件 SELECT * FROM clinic_order WHERE created_at >= '2026-08-01' AND created_at < '2026-08-02'; -- 病例二:隐式类型转换,phone 是 CHAR SELECT * FROM clinic_user WHERE phone = 13800138000; -- 处方:传字符串常量 SELECT * FROM clinic_user WHERE phone = '13800138000'; -- 病例三:前置通配符 SELECT * FROM clinic_user WHERE user_name LIKE '%大夫';
图:一次二级索引查询的两条路径
💡 关键直觉:索引不是越多越好。每棵树都要随写入维护,二级索引多的表,INSERT 与 UPDATE 会明显变慢。诊断室的口诀:按查询建索引,不按列建索引。
索引下推与回表的账本
5.6 之后有个值得单独记账的优化:索引下推。联合索引 (user_id, status, created_at) 上查 user_id 固定、status 等值的行,引擎能在索引里直接判断 status,只把满足的行拿去回表,而不是先把 user_id 命中的所有行回完表再由 Server 层过滤。EXPLAIN 的 Extra 会写 Using index condition。这笔账在命中行数与条件过滤比例悬殊时尤其划算:
-- user_id=1001 有 10 万行,其中 status=2 只有 300 行 -- 无下推:回表 10 万次;有下推:回表 300 次 SELECT * FROM clinic_order WHERE user_id = 1001 AND status = 2;
设计联合索引时下推是隐性福利:把等值条件列尽量往前放,让引擎在索引内部多筛一阵,回表账单就薄一叠。
前缀索引:长字符串的瘦身术
用户名、邮箱这类长字符串整列建索引会让树变得臃肿。前缀索引只索引开头若干字符:
-- 先看区分度:取多长够用 SELECT COUNT(DISTINCT LEFT(user_name, 6)) / COUNT(*) FROM clinic_user; SELECT COUNT(DISTINCT LEFT(user_name, 8)) / COUNT(*) FROM clinic_user; -- 假设 8 字符已接近全列区分度 ALTER TABLE clinic_user ADD KEY idx_name_prefix (user_name(8));
代价要记在账上:前缀索引无法覆盖索引(列上取的是片段),也无法用于 ORDER BY 的完全排序。它的定位是"用很小的索引换可接受的过滤力",适合长文本的等值查找,不适合要排序的范围扫描。
索引的维护成本:一次写入的慢动作
索引不是免费的,看一次 INSERT 的慢动作就明白:聚簇索引按主键顺序插入(自增主键天然顺序写,这也是推荐自增或趋势递增主键的原因——随机主键比如 UUID 会让每次插入都写树的中间页,树被写得很散);每个二级索引各插一条进自己的树;change buffer 能把唯一索引之外的二级索引写先攒起来,但唯一索引必须当场读页校验,这就是"唯一索引写入更贵"的机理。
-- 看一张表背了几棵树的索引 SELECT index_name, non_unique, seq_in_index, column_name FROM information_schema.statistics WHERE table_schema = 'clinic' AND table_name = 'clinic_order' ORDER BY index_name, seq_in_index;
诊断室清索引的动作:列出全表索引,对照慢日志里的真实查询,半年没被 possible_keys 光顾过的索引进入观察名单,再核对业务方后删除。索引瘦身后的写入提速,常比想象中明显。
本节要点回顾
- 两棵树:聚簇索引挂整行,二级索引挂主键,回表是二次查找
- 最左前缀:联合索引按定义顺序排,跳过第一列即失效
- 三大失效:函数包列、隐式类型转换、前置通配符