4.2 读片指南:EXPLAIN执行计划
4.2 读片指南:EXPLAIN 执行计划
本节摘要:EXPLAIN 是慢查询的影像检查。type 列看访问方式的等级,key 与 rows 看走了哪条路、要扫多少行,Extra 看有没有filesort 与临时表。本节逐列解读并判读一个真实病例。
拍片
EXPLAIN SELECT * FROM clinic_order WHERE user_id = 1001 AND status = 2 ORDER BY created_at DESC LIMIT 20;
各列读法(按诊断价值排序)
| 列 | 读什么 | 危险信号 |
|---|---|---|
| type | 访问方式等级 | ALL 全表扫描 |
| key / possible_keys | 实际用与候选索引 | NULL 说明没索引可用 |
| rows | 预估扫描行数 | 与结果集相差悬殊 |
| Extra | 附加动作 | Using filesort、Using temporary |
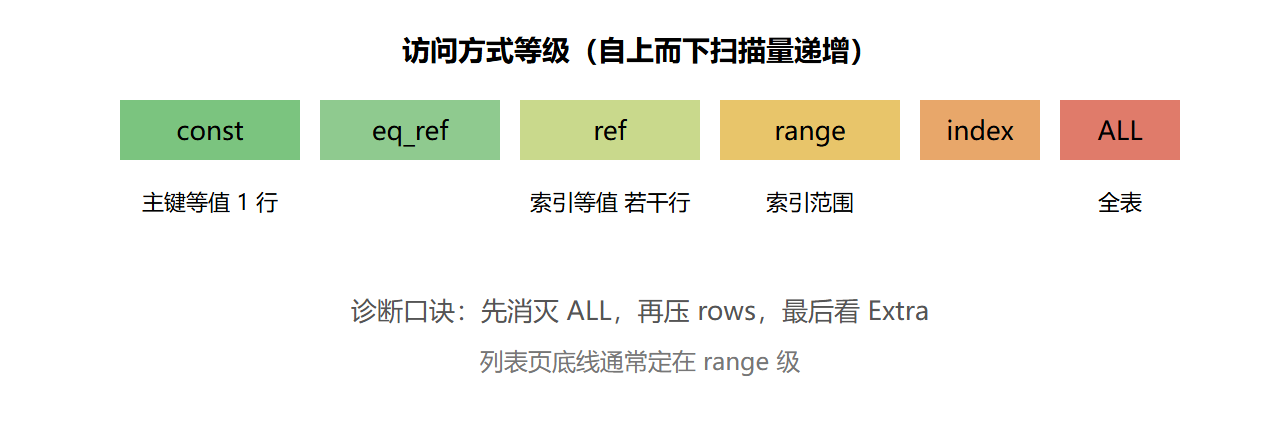
type 从好到坏大致是:const、eq_ref、ref、range、index、ALL。index 比 ALL 略好——扫的是索引整棵树而不是数据表,但本质上还是全扫,见到它别急着安心。
一个病例的判读
EXPLAIN SELECT * FROM clinic_order WHERE DATE(created_at) = '2026-08-01'; -- type: ALL -- key: NULL -- rows: 9876543 -- Extra: NULL
读片结论:函数包住列导致索引失效,预估扫描近千万行,虽然最终只要几百行。处方即 4.1 节的范围条件改写,复测后 type 变 range,rows 掉到几千。
EXPLAIN SELECT user_id, COUNT(*) FROM clinic_order WHERE status = 1 GROUP BY user_id; -- Extra: Using index; Using temporary
第二张片:走了覆盖索引(好消息),但分组产生了临时表。分组列与索引前缀对齐时临时表可以消失,这类微调在列表页聚合里很常见。
⚠️ 常见坑:EXPLAIN 的 rows 是基于统计信息的估算,不是精确值。统计过期时估算可差一个数量级,怀疑时先跑 ANALYZE TABLE 再拍片。
图:type 等级与扫描量示意
完整判读一个多表病例
单表拍片看三列就够,多表 join 的片子要多看一眼两列:id 与 ref。id 相同从上往下执行,id 不同大的先执行。驱动顺序错了,扫描量按乘法放大。看一个真实形状:
EXPLAIN SELECT u.user_name, COUNT(*) cnt FROM clinic_order o JOIN clinic_user u ON u.user_id = o.user_id WHERE o.status = 2 AND u.created_at > '2025-01-01' GROUP BY u.user_id;
假想输出里 o 表 type 是 ref、key 是 idx_status(假设只有单列状态索引),rows 五十万;u 表 type 是 eq_ref、rows 一。这张片的病灶在驱动表:五十万行逐个回表再 join,而 status=2 只是低区分度筛选。处方是把订单表建 (status, user_id) 联合索引,驱动表扫描量缩到目标量级,整条语句从秒级落到百毫秒内。多表优化的第一直觉永远是先看驱动表扫了多少行。
EXPLAIN 的两个替身
普通 EXPLAIN 是估算,两个替身能拿真实数据。EXPLAIN ANALYZE(8.0.18 起)真的执行语句并报出每一步的实际行数与耗时,估算与实际的落差一目了然,是"rows 看着不大但还是慢"时的照妖镜:
EXPLAIN ANALYZE SELECT * FROM clinic_order WHERE user_id = 1001 AND status = 2; -- 输出里 actual time 与 rows 是实测值,和估算值并排
optimizer trace 则把优化器的选择过程全录下来,候选路径各算出多少成本、为什么放弃某索引,适合研究"它为什么不用我的索引"这类悬案:
SET optimizer_trace='enabled=one_shot'; SELECT ...; -- 你的查询 SELECT * FROM information_schema.OPTIMIZER_TRACE;
注意 EXPLAIN ANALYZE 会真跑语句, UPDATE/DELETE 别拿它拍片——先用 SELECT 形态复现,或者用 EXPLAIN(纯估算)看写语句的计划。
病例归档:一张片的完整诊断书
把本节的读法收拢成一张诊断书的固定栏目:访问方式(type)定病情等级;扫描量(rows)与结果集大小的比值定性价比;附加动作(Extra)提示隐性成本;多表时驱动表扫描量定主攻方向;估算可疑时 ANALYZE TABLE 后复拍,必要时 EXPLAIN ANALYZE 取实测。五栏写完,处方自然浮出:补索引、改写条件、还是干脆把查询挪个地方。这个流程在第 8 章的随身卡上会再做一次总结。
Extra 列的其余暗号
Using filesort 与 Using temporary 之外,Extra 还有几个值得认识的暗号。Using index 是好消息,覆盖索引生效免回表。Using where 是中性词,Server 层过滤,配合低 rows 无妨,配合 ALL 就要警惕。Using join buffer 是相邻表没有可用索引被动用了连接缓冲,Block Nested Loop 的老名字,多表查询里看到它通常意味着被驱动表缺索引。Impossible WHERE 与 no matching row 直接判了语句死刑,条件恒假,常见于业务参数没传进来拼出了空条件——它常是应用层 bug 的第一现场。
-- 亲手制造几个暗号对照看 EXPLAIN SELECT user_id FROM clinic_order WHERE user_id = 1000000; -- Extra: Impossible WHERE noticed after reading const tables(值超出范围时)
本节要点回顾
- 先看 type 再看 rows 最后看 Extra,三步定位病灶
- rows 与结果集的比例是性价比判断的核心指标
- 估算会失真:统计过期先 ANALYZE TABLE