2.1 协议架构与 OpenFlow 报文头拆解
2.1 协议架构与 OpenFlow 报文头拆解
本节摘要:所有 OpenFlow 消息共用一个 8 字节报文头:版本 1 字节、类型 1 字节、总长 2 字节、事务号 4 字节。本节拆解这 8 个字节的每一个位段,讲清通道承载方式与字节序约定,并给出在 Wireshark 中定位它们的操作方法。这是后续一切消息解剖的公共入口。
学习目标
阅读完本节,你应当能够:
- 画出 8 字节 OpenFlow 报文头并标注字段位宽
- 解释 xid 如何把请求与应答配对
- 在 Wireshark 中找到报文头的十六进制原文
协议栈位置
OpenFlow 消息不直接跑在裸线上,它的承载栈是 OpenFlow / TLS(可选) / TCP / IP。控制器被动监听 6653 端口,交换机主动发起连接。也就是说,在抓包里找 OpenFlow,先找 TCP 6653 的流。
一个常被问的问题:为什么不用 UDP?因为消息有大有小——Flow-Mod 可以带上几十条指令,分片与可靠性自己造太贵,TCP 现成。而 Echo 消息兼作保活探测,弥补了 TCP keepalive 粒度太粗的问题。
OpenFlow 1.3 报文头字段布局
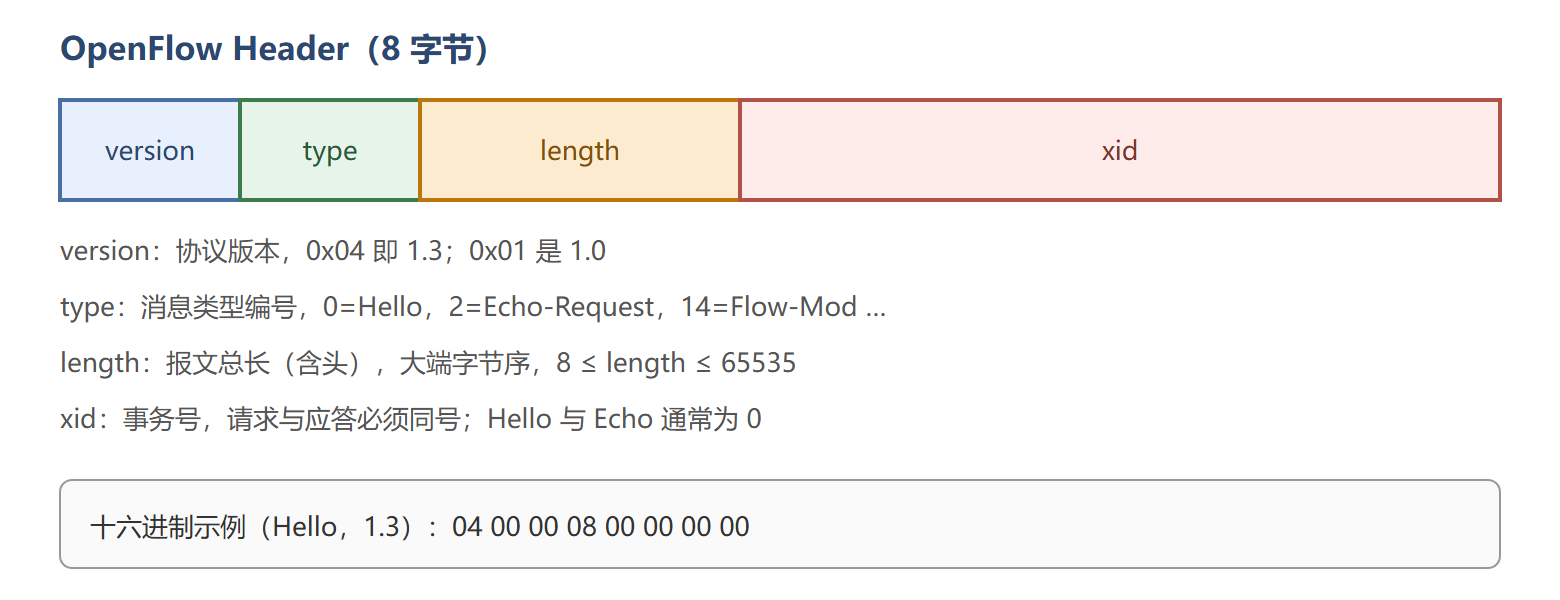
四个字段里最值得多讲的是 xid。控制器发出 Barrier-Request 带 xid 为 7,交换机回 Barrier-Reply 也带 7,控制器据此确认"到这条为止的消息都已执行完毕"。没有 xid,异步混行的通道上请求与应配对就乱了。Hello 与 Echo 是对称消息,xid 通常填 0,不参与配对。
字节序:length 与后续消息体里的多字节整数一律大端(网络字节序)。写协议栈代码时忘了转换,是新手实现里最经典的 bug——抓包看到的 length 会是一个荒谬的大数。
在解剖镜下确认
在 1.4 节的抓包文件里任选一帧 Hello,Wireshark 分两层显示:OpenFlow 1.3 协议层展开后,Version / Type / Length / Transaction ID 四行与十六进制区一一对应。把 type 字段的十六进制值抄下来,对照下一节的消息类型表,你已经可以给任何一帧报文"验明正身"。
一个最小验证脚本(用 Python 十六进制直接读头):
import struct def parse_header(b: bytes): version, mtype, length, xid = struct.unpack("!BBHI", b[:8]) return {"version": version, "type": mtype, "length": length, "xid": xid} # 示例:04 00 00 08 00 00 00 00 → 版本1.3 Hello 总长8 xid=0
💡 关键直觉:报文头是协议的"封面"——type 决定你该翻到哪一章解析体,xid 决定这句话是回答谁的。8 字节读懂,剩下全是查表工作。
手工解析:八行 Python 拆一个头
不信 Wireshark 的时候,自己拆。下面这段脚本从 pcap 独立出来的字节流里解析 OpenFlow 夥部,逻辑与协议规范逐字节对应:
import struct frame = bytes.fromhex('04 0e 00 20 00 00 00 07') # struct 格式串:! 表示网络序(大端),B=1字节 u8, H=2字节 u16, I=4字节 u32 version, msg_type, length, xid = struct.unpack('!BBHI', frame[:8]) print(f'version={version} (0x{version:02x}) -> 1.{version-1}') # version=4 (0x04) -> 1.3 print(f'type={msg_type} length={length} xid={xid}') # type=14 length=32 xid=7 → 14 号消息,应答必须带回相同的 xid=7 assert length == len(frame) or len(frame) == 8
三个细节值得在控制台上把玩。把 04 改成 05,解析出 1.4——版本号就是数字本身,1.0 到 1.5 对应 0x01 到 0x06,这也是为什么 Hello 里可以直接填最高版本。把 length 改成小于 8 的值,真实交换机会回 Bad Request 错误,因为头本身就要占 8 字节。把 xid 换成任意值,观察 Echo-Request 与 Echo-Reply 的配对关系——所有请求类消息都必须原样带回 xid,控制器并发发出多个 Multipart 请求时,靠 xid 才能把乱序到达的应答分拣回各自的请求,这个字段是通道上唯一的"回执编号"。
边界情况:padding、对齐与 length 的边界
拆真实报文时还会遇到三个规范文本里才写清的边角。多数消息体在 64 位边界对齐,未用字段填零,Wireshark 展示为 padding——解析时跳过即可,但手工构造报文时漏掉 padding 会让对端算错 length 直接判错。length 必须是 8 的倍数,不满足的消息在规范层面就是非法。最后,一个 TCP 分段可能装多条完整 OpenFlow 消息(Hello 之后紧跟 Echo 很常见),也可能一条长消息跨多个分段——解析器必须按 length 切流,而不能假设"一段一消息",这是所有自写解析工具的第一坑。
顺带把"通道上到底有几层"说透:物理上你看到的是 TCP 流,逻辑上 OpenFlow 在其上定义了消息边界(靠 length 字段切分),再往上是消息类型家族,最后才是语义层的事务配对(靠 xid)。四层各司其职,排障时按层归位——连接问题看 TCP,解析问题看消息边界,流程问题看类型与 xid。Wireshark 的分层展开恰好对应这四层,学会在它的显示过滤器里分别用 tcp、openflow、of.type、of.xid 表达这四层关切,逐帧阅读的速度会快一个量级。
本节要点回顾
- 承载栈:OpenFlow 在 TLS(可选)/TCP 之上,控制器监听 6653
- 四字段头:version、type、length、xid,共 8 字节,大端序
- xid 的作用:请求—应答配对,Barrier 系列尤其依赖它
- 验证手段:Wireshark 十六进制区对照协议层,或用 struct 手工解析
下一节把 type 字段展开成完整的消息家族。