4.3 端口控制与端口消息
4.3 端口控制与端口消息
本节摘要:端口是 OpenFlow 世界里物理与逻辑的交界:Port-Mod 消息让控制器改写端口属性(up/down、MAC、广告速率、阻塞标志),Port-Status 让交换机上报端口变化,队列配置消息则挂在端口之下。本节梳理端口相关的三族消息与端口的完整生命周期。
端口不只是编号
2.4 节把端口当 OUTPUT 的目标讲,这一节把它当管理对象讲。一个 OpenFlow 端口的完整画像分四组属性:
Port 属性四件套 { 身份: port_no, hw_addr, name, config 状态: state(link down / blocked / live) 能力: current / advertised / supported / peer 速率与双工 统计: 收发包数、字节数、错误数、丢弃数 }
config 与 state 的区别要分清:config 是控制器写的意愿(比如管理性禁用),state 是设备观察的事实(对端链路是否在)。admin down(config)与 link down(state)在排障时指向完全不同的方向——前者查管理面,后者查线缆和对端。
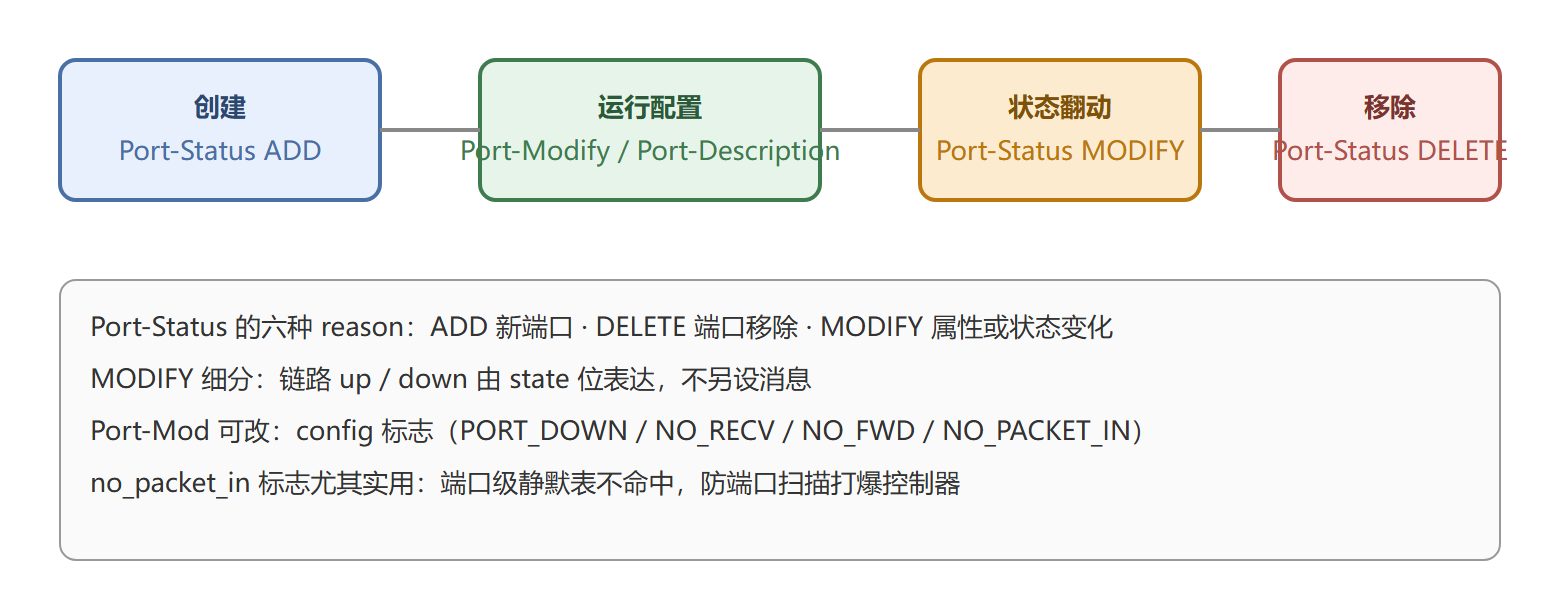
端口生命周期与消息族
三个实用标志
config 标志里最值得记住的三个:
- PORT_DOWN:管理性禁用端口,效果等同拔线但可秒级恢复——变更窗口的常用手段
- NO_FWD:端口不转发流量(保留给管理或 LLDP 专用口)
- NO_PACKET_IN:该端口的表不命中不再上送控制器。面对失控的端口扫描,这个标志能在数据面掐断 Packet-In 风暴,给控制器续命
实验台上体验管理性开关:
# 禁用 s1 的端口 2,h1 到 h2 的流量立刻中断 sudo ovs-ofctl -O OpenFlow13 mod-port s1 2 down sudo ovs-ofctl -O OpenFlow13 mod-port s1 2 up
端口翻动与控制器响应
链路抖动的完整报文链是:交换机发现 state 位变化 → Port-Status(MODIFY) 上报 → 控制器更新拓扑库(3.3 节的邻接表)→ 受影响的组表(fast failover 已在数据面先切换)与流表被批量 MODIFY。抓包特征鲜明:一帧 Port-Status 后紧跟密集的 Flow-Mod 与 Group-Mod。
端口的统计与描述信息则通过 Multipart-Request 的 PORT / PORT-DESC 类型拉取,是 6.2 节网络监控的主要数据源。
⚠️ 常见坑:Port-Mod 修改 advertised 速率只影响自动协商的下次握手,不会立刻改变 current 速率。想立即生效要靠端口重启。
💡 关键直觉:把 config 当"开关柜"、state 当"仪表盘"——管理动作写前者,监控读后者,混用会导致"我明明没关它为什么 down 了"这类误判。
动手:用 NO_PACKET_IN 挡住一次扫描风暴
正文的三个标志里,NO_PACKET_IN 最值得亲手验一次。场景:h1 用 nmap 对不存在的子网做高速扫描,每发一个包都表不命中,全部涌向控制器。先看风暴模样,再上阀门:
# 给 s1 的 1 号口上阀门 sudo ovs-ofctl -O OpenFlow13 mod-port s1 1 no_packet_in # 业务影响验证:h1 ping h2 仍通(已命中的流走既有规则,不受影响) sudo ovs-ofctl -O OpenFlow13 mod-port s1 1 up # 实验后恢复
这个实验精确演示了阀门的作用面:它只切断"未知流上送"这条路,不干扰已建立的转发。代价也明确——该端口的新业务再也起不来流,所以生产上 NO_PACKET_IN 更适合施于"只出不进"的出口端口或确知无新业务的主机口,而不是全网默认。与之配合的还有控制器侧的 miss_send_len 调整(把上送的包截短到 128 字节)与上送速率限制,三层防线叠起来才扛得住真实 DDoS。
端口翻动的连锁排障
一次物理抖动在协议上的连锁反应值得完整走一遍:交换机发 Port-Status(reason=MODIFY,链路 down)→ 控制器拓扑模块摘除链路 → 引用该端口的路由重算 → 涉及交换机批量收到 Flow-Mod 与 Group-Mod → 若路径上有 fast failover 组,重算前数据面已先行切换。排障时的观察顺序就按这条链来:先 tcpdump 确认 Port-Status 发出的时间点,再对照控制器日志的重收敛耗时,最后 dump-flows 检查批量下发是否完整。翻动频繁的链路会把这条链每分钟跑一遍,控制器 CPU 与通道带宽都会被消耗,这才是"翻动链路"比"断链路"更麻烦的工程原因。
端口号编码体系也值得单独记一笔:1 到 0xffffff00 是物理与逻辑端口的开放区间,最高段的 0xffffff00 之后是保留端口(CONTROLLER、FLOOD、ALL、LOCAL、NORMAL 等),它们不出现在任何面板上,却都能作为 OUTPUT 的目标。翻动排障时先确认端口身份属于哪一段——物理口的状态翻动要看链路与驱动,保留端口的行为异常则多半是控制器下发了语义不当的动作。两套排查思路完全不同,第一步就分错段,后面全是弯路。
端口故障排查还有一条经验值得单独记录:先看统计再看消息。Port-Status 消息只告诉你"状态变了",但"为什么变"要靠 Multipart 查询的端口统计去猜——计数器的 rate 骤降说明流量中断在前,Port-Status 只是结果;计数器正常而控制器报端口 down,则多半是控制器侧的状态机出了问题。把"数据面计数器"和"控制面消息"当作两个独立证据源交叉验证,能省掉大量在错误方向上的排查时间。
本节要点回顾
- 属性四件套:身份、状态、能力、统计;config 是意愿,state 是事实
- 消息族:Port-Mod 写、Port-Status 报、Multipart 查
- 实用标志:PORT_DOWN 管理开关、NO_PACKET_IN 防 Packet-In 风暴
- 翻动链:Port-Status → 拓扑更新 → 批量重下发
端口之下还有排队的问题——下一节讲队列与 QoS。