5.2 OpenFlow 部署模型
5.2 OpenFlow 部署模型
本节摘要:部署形态决定故障特征:单控制器简单但单点、集群高可用但复杂、混合增强(OpenFlow 管精细流量、传统协议兜底)务实但边界要划清。本节比较三种模型,并重点讨论控制器失联后交换机的三种退化模式——fail-independent、fail-secure、fail-standalone,这是部署设计里生死攸关的一节。
学习目标
阅读完本节,你应当能够:
- 对比三种部署模型的适用规模与代价
- 解释交换机失联模式三选项的行为差异
- 设计控制通道的高可用拓扑
三种模型
| 模型 | 适用规模 | 核心风险 | 典型组合 |
|---|---|---|---|
| 单控制器 | 实验、小园区 | 单点故障 | Ryu + 双机冷备 |
| 控制器集群 | 数据中心、运营商 | 一致性复杂度 | ONOS/ODL 多实例 |
| 混合增强 | 渐进改造现网 | 边界不清、双头管理 | OpenFlow 只管新业务流 |
部署模型与失联行为对照
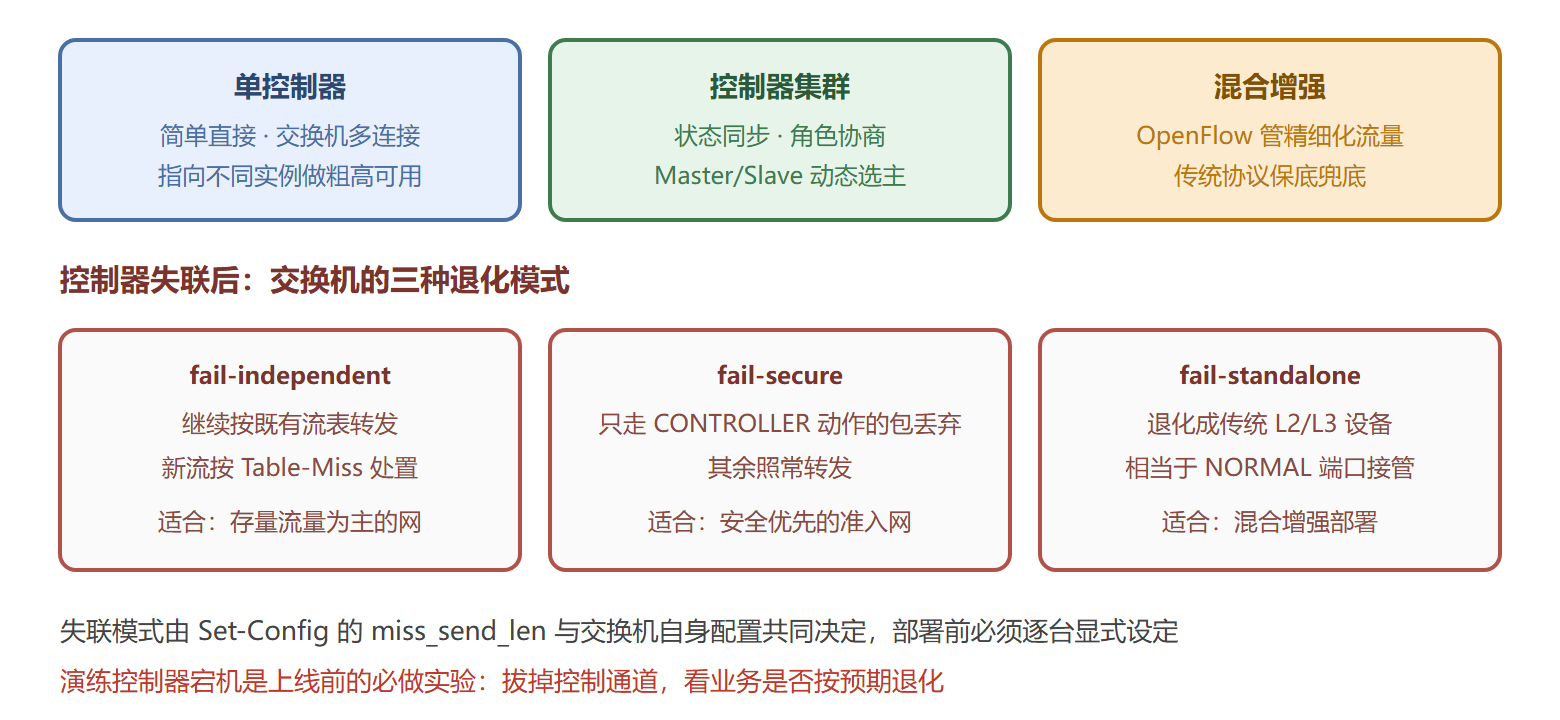
多控制器连接的细节
1.3 允许一台交换机同时连接多个控制器实例,角色分 Master(唯一写者)、Equal(多写者,需上层同步)、Slave(只读观察)。角色变更通过 Role-Request/Reply 完成,切换延迟在亚秒级。工程建议:
- 交换机侧配置至少两个控制器地址(主备),失联自动重连备用
- 集群内部用 Raft 类协议同步拓扑与主机状态,避免 3.1 节说的脑裂
- 控制通道走独立的管理网(带外),与业务面物理分离——业务网故障时控制通道还活着,你才有机会修复
混合模型:现实最常见的形态
纯 OpenFlow 网络极少,现实部署多是"岛":新业务流量(如某租户 Overlay)走 OpenFlow 精细控制,岛外仍跑 OSPF/BGP。边界设计两条纪律:
- 边界点双栈:岛边界的交换机同时说两种语言(OpenFlow 流表 + 传统路由进程),路由信息单向注入,避免环路
- 故障收敛对齐:岛内 fast failover 组的切换时间(毫秒)与传统路由收敛(秒级)不一致,边界处要设路由保持定时器,防止抖动放大
⚠️ 常见坑:忘了设控制通道的 TCP keepalive 与 Echo 超时,控制器进程假死但连接"半开",交换机迟迟不切换备用——高可用形同虚设。
💡 关键直觉:部署设计的第一性问题不是"性能多高",而是"控制器死掉时网络变成什么样"。把退化模式设计好,OpenFlow 才敢进生产网。
动手:把失联行为配置出来看
三种失联模式不是理论分型,OVS 里一条命令就能切换,配出来观察差异是理解它们的捷径:
# 造一台 fail-secure 的交换机:失联后流表冻结,按既有规则继续转 sudo ovs-vsctl set bridge s1 fail_mode=secure sudo ovs-ofctl -O OpenFlow13 add-flow s1 "priority=100,ip,actions=NORMAL" # 对比 standalone 模式: sudo ovs-vsctl set bridge s1 fail_mode=standalone # 失联约 10 秒后,交换机自作主张装 NORMAL 兜底,回到传统交换机行为 sudo ovs-ofctl -O OpenFlow13 dump-flows s1 | head -3 # 输出可见 priority=0 actions=NORMAL 的自装条目
两种模式的适用面由此一目了然:策略强一致的环境(安全隔离是硬要求的租户网)必须 secure,宁可断不可乱;纯连通性优先的环境(实验网、办公网试点)用 standalone 换取控制器故障时的可用性。真正危险的是没显式配置——很多设备的默认值是 standalone,安全团队以为策略还在执行,实际上控制器一断,边界规则全部让位给"能通就好"。部署评审清单里失联模式必须是一栏显式确认项。
失联模式选型速查 { 租户隔离/安全边界 -> fail-secure(冻结流表,宁可断不可乱) 办公网/实验网 -> fail-standalone(自动 NORMAL 兜底,保连通) 出口/汇聚层 -> 严禁默认值,逐台显式配置并纳入验收 } → 验收命令: ovs-vsctl get bridge s1 fail_mode 必须与设计表一致
多控制器细节:角色切换的观察点
Master/Slave 多控环境下,观察点有二。第一,Slave 连接上交换机会收到 Flow-Mod 吗——不会,Slave 通道基本只读(Echo 与统计可用),写操作应被交换机拒绝并回 Error,这是验证角色协商是否生效的报文级证据。第二,Role-Request 的 transition 序列:切换 Master 时控制器应先索取现任 Master 的 generation_id 更大的新代次,代次不增会被交换机拒绝,这个机制防的就是两个控制器都自认 Master 的脑裂窗口。演练高可用切换时,抓包看 generation_id 的递增与旧 Master 写操作被拒的 Error,比看任何日志都确凿。
混合模型再补一个边界设计细节:OpenFlow 域与传统域的交接点是最脆弱的部位,两侧对同一条链路的状态感知时间必须对齐。典型事故是 OpenFlow 侧重路由在 50 毫秒内完成,而传统侧 OSPF 收敛要 2 秒,中间窗口内两侧路由表不一致,流量在交界点来回乒乓。设计手段包括在交界点两侧都配置 BFD 加速、或把交界链路的故障检测统一交给更快的机制。这类问题的共同解法是把"收敛时间预算表"写进设计文档——每条路径、每层机制的感知与收敛耗时一列,超预算的组合在设计评审就该被拦下,而不是等割接夜现形。
部署模型的选择还有一个组织维度的考量常被漏算:控制器的运维归属。集中控制把网络决策收敛到一个软件系统,这个系统的变更管理、监控值班、故障响应该由网络团队还是平台团队承担,需要在立项时写清——权责悬空的控制器会在第一次生产事故时变成两个团队互相推诿的现场。实践中行之有效的做法是把控制器当作一个线上服务来对待:有负责人、有变更窗口、有监控大盘、有值班响应,而不是当作一台"高级交换机"塞进机房了事。
本节要点回顾
- 三模型:单机(实验)、集群(生产核心)、混合增强(渐进改造)
- 失联三模式:fail-independent / fail-secure / fail-standalone,必须显式设定
- 多控制器:Master/Equal/Slave 角色,带外管理网与双控制器地址是底线
- 混合边界:双栈边界点 + 收敛时间对齐
部署形态定了,下一节写真正的应用。