1.1 什么是Hive:SQL到MapReduce的翻译
1.1 什么是 Hive:SQL 到 MapReduce 的翻译
本节摘要:Hive 是建立在 Hadoop 之上的数据仓库基础设施,核心能力是把类 SQL 语言(HiveQL)翻译成 MapReduce 或 Tez 任务,让不写 Java 的分析师也能处理 TB 级数据。本节从手写 MapReduce 的痛苦出发,演示同一条统计需求的两副面孔,再划清 Hive 与传统数据库的边界。
从一段 Java 说起
2008 年前后,Facebook 的数据团队每天要处理几十亿条日志。当时的工具只有 MapReduce:想统计"每个用户产生了多少条行为日志",工程师要写一个 Java 类,配置作业、打包、提交、取结果,一个需求一个类,一个类上百行。
简化版的词频统计大致长这样:
public class WordCount extends Configured implements Tool { public static class Map extends Mapper<LongWritable, Text, Text, IntWritable> { private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(LongWritable key, Text value, Context ctx) throws IOException, InterruptedException { for (String w : value.toString().split("\\s+")) { word.set(w); ctx.write(word, one); } } } public static class Reduce extends Reducer<Text, IntWritable, Text, LongWritable> { public void reduce(Text key, Iterable<IntWritable> vals, Context ctx) throws IOException, InterruptedException { long sum = 0; for (IntWritable v : vals) sum += v.get(); ctx.write(key, new LongWritable(sum)); } } }
这段代码真正与业务有关的只有两行:拆词、求和。剩下的全是框架仪式——类型声明、异常签名、打包配置。更糟的是它不可组合:想先过滤再聚合再排序,就得把三个作业串起来,自己管理中间结果的目录。
而同样的需求,在 Hive 里是这样:
SELECT word, COUNT(*) AS cnt FROM logs LATERAL VIEW explode(split(line, ' ')) t AS word GROUP BY word ORDER BY cnt DESC;
五行,任何会 SQL 的分析师都能读懂、能改。Hive 的全部价值就压在这两个例子的差距上:它没有让 Hadoop 变快,也没有让 HDFS 变强,它只是让"使用 Hadoop"的门槛从 Java 工程师降到了 SQL 分析师。
这門生意之所以可行,是因为 SQL 的代数结构与 MapReduce 存在稳定的映射关系。SQL 无论多复杂,最终都能分解为有限几种代数运算:过滤(WHERE)、投影(SELECT 列)、分组聚合(GROUP BY)、连接(JOIN)、排序(ORDER BY)。而 MapReduce 恰好提供了两种可组合的执行原语:Map 阶段做逐条转换,Reduce 阶段按键分组处理。一个 GROUP BY 拆成"Map 端按分组键打标签、Reduce 端按键聚合";一个 JOIN 拆成"Map 端给两边数据打上表来源标签、按连接键shuffle、Reduce 端拼对"。映射关系成立,翻译官就有饭吃。
翻译官的工作台
把这条映射关系画成图,就是贯穿全册的"工作台"——SQL 从左边递进去,分布式任务从右边交出来,中间四道工序:
Hive 翻译官工作台总览
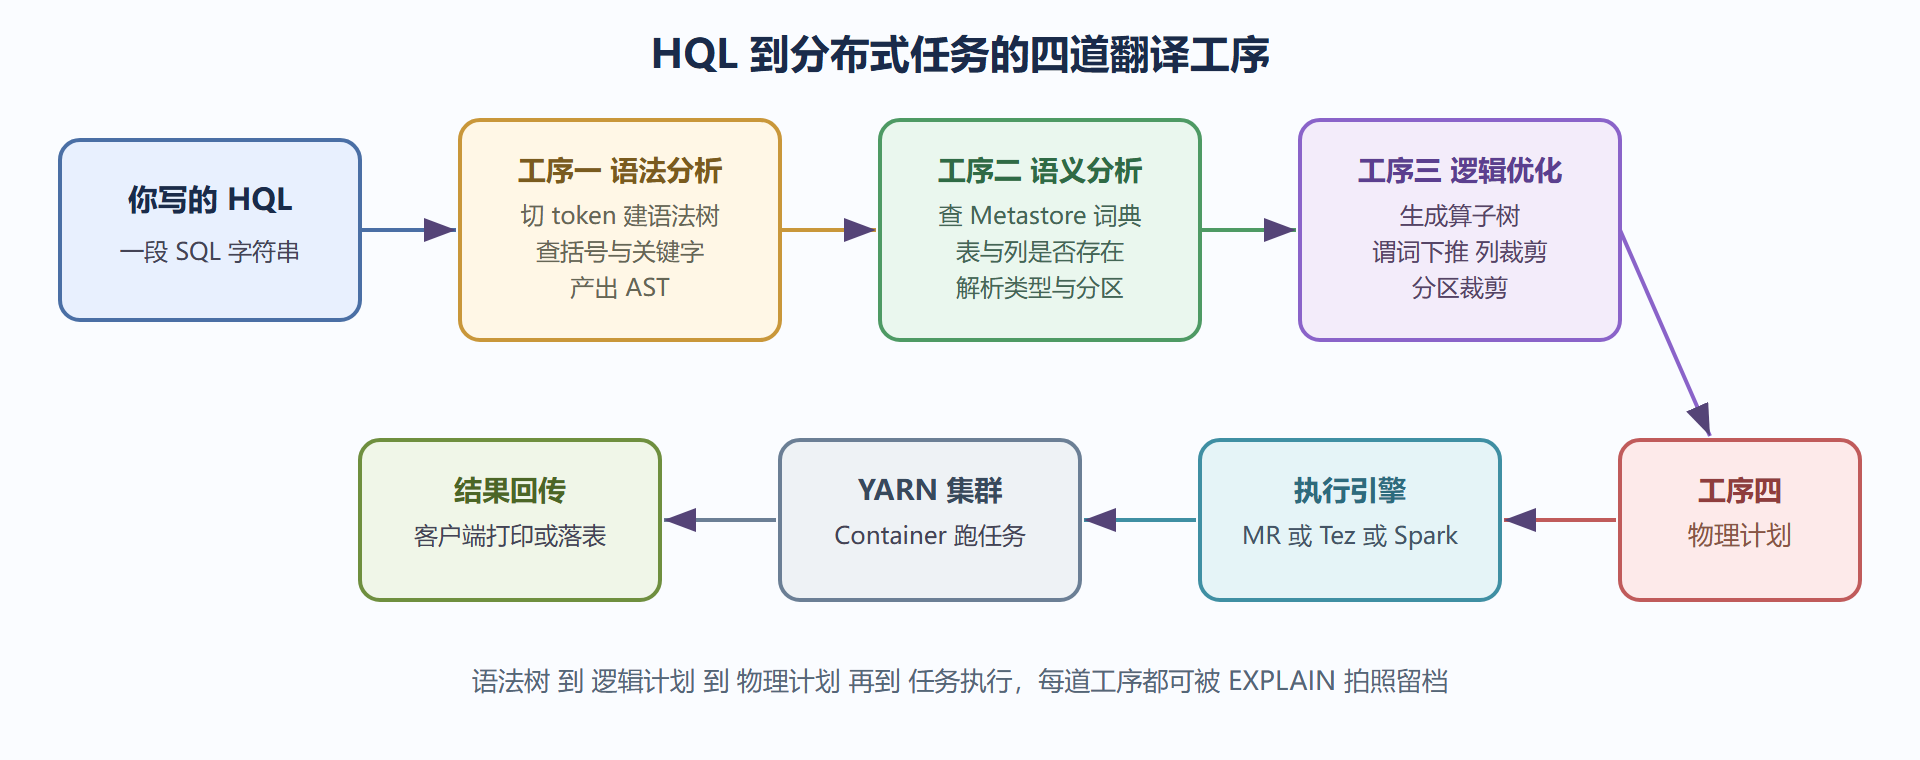
同一条需求的两个世界
用电商场景把翻译落到具体。需求:统计 2026 年 1 月 15 日每个客户的消费总额。HQL 写出来是:
SELECT customer_id, SUM(price) AS amt FROM sales WHERE dt = '2026-01-15' GROUP BY customer_id;
提交后 EXPLAIN 一下(EXPLAIN 的用法下一节详细讲,这里先看骨架),Hive 会告诉你它把这句话翻译成了一个 MapReduce 作业:
STAGE DEPENDENCIES: Stage-1 is a root stage Stage-0 depends on stages: Stage-1 STAGE PLANS: Stage: Stage-1 Map Reduce Alias -> Map Operator Tree: sales TableScan alias: sales Filter Operator predicate: (dt = '2026-01-15') (type: boolean) Select Operator expressions: customer_id (type: string), price (type: decimal(10,2)) Reduce Operator Tree: Group By Operator aggregations: sum(price) keys: customer_id (type: string) mode: hash
对照着读,翻译规则一目了然:
- WHERE dt 这件事变成 Map 端的 Filter Operator,紧跟在 TableScan 后面——每读一行就先判断,不合格的直接丢,不进网络;
- SELECT 两列变成 Select Operator,即投影——80 列的表只放行 2 列,这是后面讲列裁剪的伏笔;
- GROUP BY customer_id 变成 Shuffle 的分区键与 Reduce 端的 Group By Operator——相同客户的所有行被网络送到同一个 Reduce 任务;
- SUM(price) 变成 Reduce 端聚合函数的参数。
一条 SQL,五个算子,一次 Map 与 Reduce 的分工。所谓"Hive 底层",就是这张算子清单加它的调度顺序。以后你在任何资料里看到"谓词下推""Map 端聚合"这些词,指的都是对这张清单的某处修改。
Hive 不是什么
翻译官的比喻也能帮你看清 Hive 的边界。译员不生产稿件,也不保管档案——同样,Hive 自己既不存储数据,也不执行计算:
- 数据在 HDFS:Hive 表只是 HDFS 目录的"户籍登记",sales 表对应一个目录,每个分区是子目录,数据文件躺在里面,HDFS 负责分块与副本;
- 元数据在 Metastore:表名、列类型、分区列表这些"户籍信息"存在一个关系型数据库里,默认 Derby,生产用 MySQL;
- 计算在 YARN 集群:翻译出来的任务提交给 YARN,由它分配 Container 执行。
由此推出 Hive 与传统数据库的几条硬边界,每一条都值得在选型时掂量:
| 维度 | 传统数据库 | Hive |
|---|---|---|
| 查询延迟 | 毫秒到秒级 | 即使小查询也是几十秒起步(Tez 与 LLAP 有改善) |
| 数据修改 | 行级增删改随意 | 追加为主,更新删除依赖 ACID 表且有条件 |
| 索引 | B 树哈希随机访问 | 没有常规索引,靠分区裁剪与列存跳读 |
| 数据规模 | 单机 GB 到 TB | 集群 TB 到 PB |
| 事务 | 完整 ACID | 有限 ACID,不适合高并发点查 |
| Schema 生效时机 | 写入时校验 | 读时模式,脏数据在查询时才暴露 |
其中"读时模式"(schema on read)最值得展开:往 Hive 表里 LOAD 一个文件,Hive 不检查内容是否合规,只在查询时按建表声明的分隔符与类型去解析,解析失败就给 NULL。好处是装载零成本、历史数据可以反复用不同 Schema 读;代价是脏数据发现得晚,'abc' 装进 INT 列不会在入库时报错,而是在聚合结果悄悄变小时才被察觉。生产上的对策是建表时把可疑列先设为 STRING,清洗后再 CAST 到目标类型。
本节要点回顾
- Hive 的本质:把 HiveQL 编译成 MapReduce 或 Tez 任务的翻译层,自身不存数据、不执行计算;
- 翻译可行的根基:SQL 的代数运算与 MapReduce 的执行原语之间存在稳定映射,GROUP BY 对应 Shuffle 分组、JOIN 对应按键重分布;
- 算子视角:一条查询被翻译成 TableScan、Filter、Select、GroupBy 等算子的清单与调度顺序,EXPLAIN 能把它打印出来;
- 三大分离:数据在 HDFS、元数据在 Metastore、计算在 YARN,Hive 只负责翻译与调度;
- 能力边界:分钟级延迟、弱事务、无随机索引,它擅长的是海量数据的批处理分析,不是在线服务。
下一节我们走进翻译公司内部,看 Client、Driver、Metastore、执行引擎这四个部门如何接力完成一次翻译。