1.2 Hive架构:四大组件的接力
1.2 Hive 架构:四大组件的接力
本节摘要:Hive 架构由 Client、Driver、Metastore、执行引擎四大部分组成。本节以一条查询的完整生命周期为线索,讲清每个组件在翻译流程中的职责、组件之间的调用顺序,以及 Metastore 独立部署带来的运维含义。
先看一次完整的往返
上一节把 Hive 比作翻译官,这一节拆翻译公司的组织架构。拆之前先约定视角:不看静态的组件清单,看一条查询从提交到返回的动态接力——组件只有放在接力顺序里才容易记住。
假设分析师在 Beeline 里敲下:
SELECT region, COUNT(*) FROM orders WHERE dt = '2026-01-15' GROUP BY region;
这条字符串要经过六个停靠站:
- Client(Beeline) 接收 SQL,通过 JDBC 协议把它发给 HiveServer2;
- HiveServer2 内的 Driver 接稿,启动编译流程:语法分析、语义分析、优化、生成物理计划;
- Driver 在语义分析阶段向 Metastore 发起一串 RPC:orders 表存在吗、dt 是不是分区列、region 的类型是什么、这个分区下有哪些文件;
- Driver 把物理计划交给 执行引擎,执行引擎向 YARN 申请资源、启动 MR 或 Tez 任务,任务直接读 HDFS 数据;
- 任务跑完,执行引擎 把结果汇总回 Driver;
- Driver 把结果集通过 HiveServer2 送回 Beeline 打印。
六步里 HiveServer2 与 Driver 是一体的,所以宏观上就是四大件:Client 管进出、Driver 管翻译、Metastore 管词典、执行引擎管施工。
Hive 架构分层图
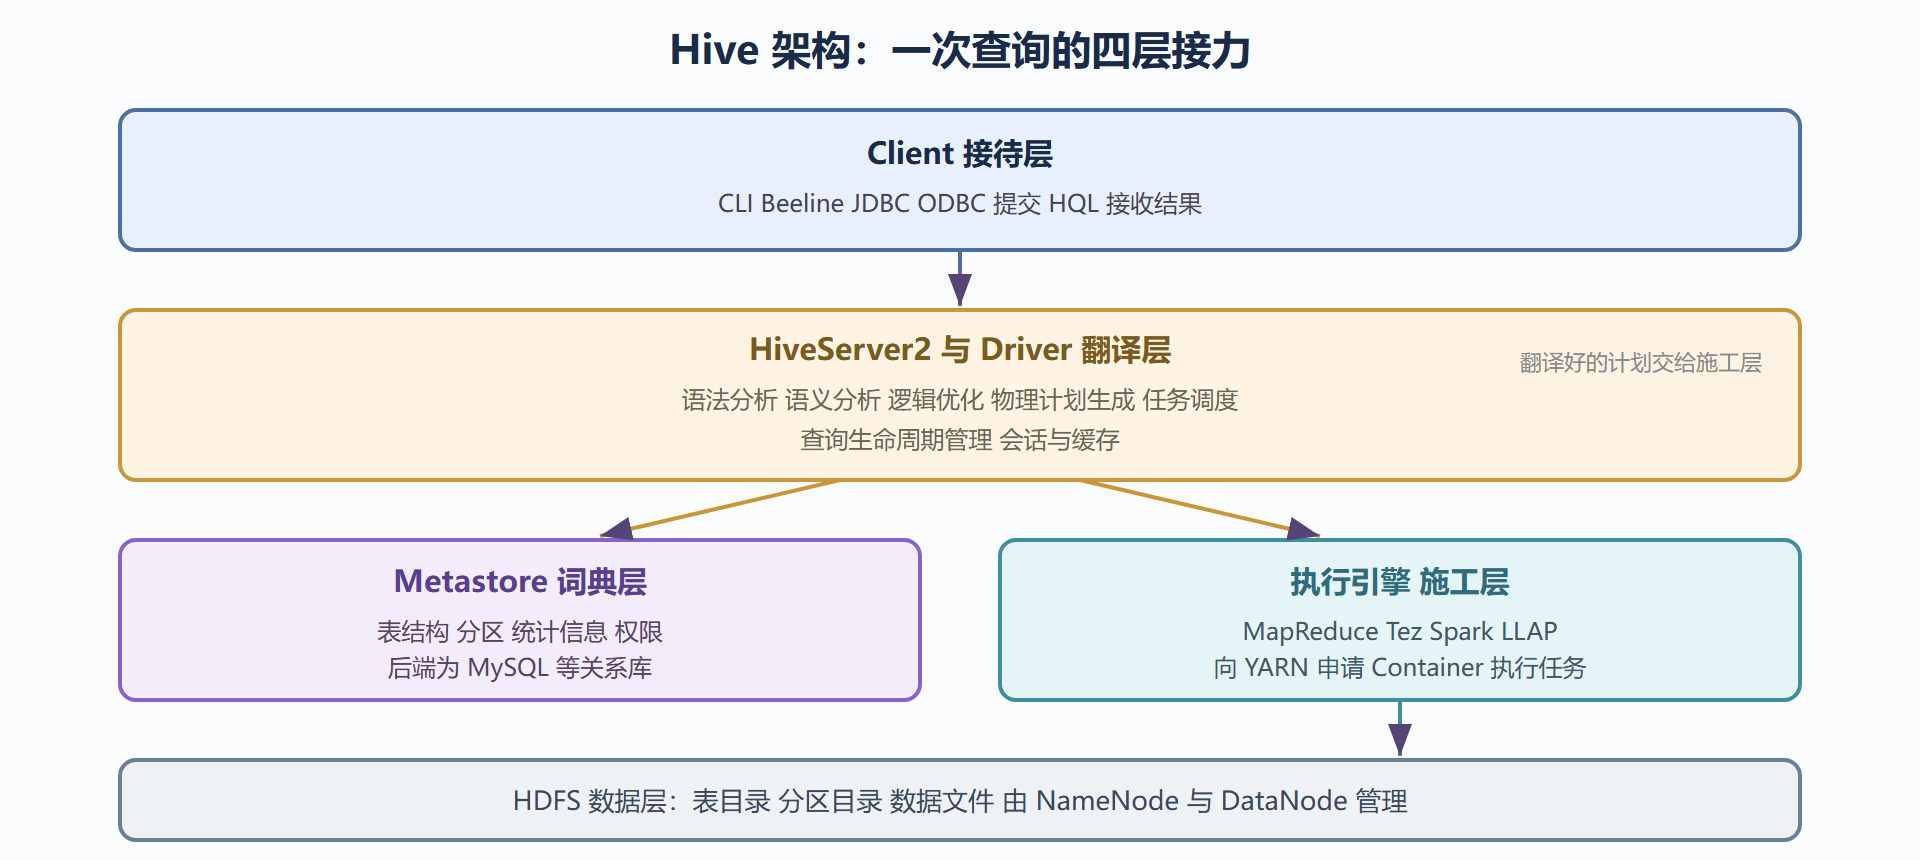
四个部门各自的 KPI
Client:只管递稿取件
Client 是所有提交入口的统称:老式 hive 命令行的 CLI、生产标准的 Beeline、以及一切走 JDBC 或 ODBC 的程序。Beeline 与 CLI 的关键区别在于连接对象:CLI 直接在本地起一个 Driver,进程退出会话即失;Beeline 连接的是独立的 HiveServer2 服务,多个客户端共享同一服务、支持并发会话与代理认证(Kerberos 场景下绑定 LDAP)。生产上一律用 Beeline,CLI 只留给单机试验。
对翻译官主线来说,Client 不参与翻译,但有一个影响体验的细节:HiveServer2 会为每个会话维护配置(SET 命令设置的参数)与临时函数,会话断开即失效——这也是为什么调优参数要么写进脚本每次设置,要么进服务器级配置。
Driver:翻译与调度一体
Driver 是 HiveServer2 里真正干活的核心对象,职责覆盖整条编译流水线:语法分析产出 AST、语义分析生成查询块、逻辑计划优化、物理计划切分 Stage、最后按依赖顺序把任务交给执行引擎并跟踪状态。第 2 章会把这条流水线逐段拆开。
这里先建立一个排错直觉:SQL 报错发生在哪个阶段,错误信息长得完全不同。语法错误(少个括号、关键字拼错)在 parse 阶段抛出,报错带行号与 token 位置;语义错误(列不存在、类型不兼容)在语义分析抛出,报错形如 Invalid table 或 SemanticException;逻辑与物理阶段的错误少见,多半是优化规则与某些语法组合的兼容问题。看报错先分类,能省一半排错时间。
Metastore:词典与户籍科
Metastore 保存库、表、分区、列、统计信息、存储格式描述符(SerDe)等全部元数据,物理上是一个关系型数据库加一层 Thrift 服务。它解决的问题是:HDFS 只认识文件与目录,"sales 表的第三列叫 price、类型 decimal"这件事必须有人记着,否则每次查询都得让用户重新声明表结构。
Metastore 有三种部署形态,各有适用场景:
| 形态 | 工作方式 | 适用场景 | 主要风险 |
|---|---|---|---|
| 内嵌模式 | Metastore 服务嵌在 HiveServer2 进程内,后端 Derby | 单机试验 | Derby 不支持并发,一个会话锁全库 |
| 本地模式 | Metastore 服务与 HiveServer2 同进程,后端 MySQL | 小规模部署 | HiveServer2 重启即元数据服务中断 |
| 远程模式 | 独立 Metastore 进程,多个 HiveServer2 连它 | 生产标准 | 需单独做高可用与备份 |
远程模式是生产标配,原因很直接:Spark、Presto、Impala 等引擎都要读同一份元数据,必须有一个进程外的统一词典;而且 Metastore 一旦损坏,所有表定义全灭,HDFS 上的数据虽然还在,却变成"没有户口的黑户",恢复要靠备份或 msck 重建分区。第 8 章运维一节会回到这个话题。
执行引擎:外协施工队
Driver 交付的是物理计划(一组 Stage),执行引擎负责把它们变成 YARN 上真实运行的任务。Hive 历史上支持过三种主引擎,加上加速层 LLAP 共四类:
- MapReduce:最老的引擎,把每个 Stage 编译成标准 MR 作业,Stage 之间靠 HDFS 中间文件衔接。稳定性最好,代价是每步落盘、任务启动慢;
- Tez:把多个 Stage 组织成一个 DAG 一次性提交,中间结果走内存或本地盘,省掉大量 HDFS 往返,是 Hive 2.x 起的默认推荐;
- Spark:以 Spark 作业形式执行 Hive 计划,适合已经在跑 Spark 的团队统一技术栈;
- LLAP:Live Long And Process,常驻守护进程加内存缓存,配合 Tez 做交互级加速。
引擎切换只需一个参数(第 3 章细讲),这背后是架构上的关键设计:编译层与执行层解耦,Driver 产出的是抽象任务描述,由各引擎的翻译适配层落地。同一个 SQL,MR 与 Tez 的逻辑算子完全一致,只是 Stage 组织方式不同——这也是为什么第 2 章讲的编译原理不会因为换引擎而过时。
组件视角的排错地图
把四大件串起来后,常见故障就有了定位坐标系:
- 提交就报
Connection refused:HiveServer2 没起或端口不通,Client 层问题; SemanticException类报错:多半是 Metastore 不可达,或表定义与实际数据不符;- 任务卡在
Accepted状态不动:YARN 资源不足,执行引擎层排队; - 任务频繁失败、日志里有
Too many fetch failures:数据节点或网络问题,HDFS 层; - 查询能跑但奇慢:不在架构层,在计划与数据布局层——正是后面六章的主场。
本节要点回顾
- 四层接力:Client 提交、Driver 编译、Metastore 供词典、执行引擎施工,数据实体始终在 HDFS;
- Driver 是翻译主体:语法、语义、优化、物理计划、调度全在 Driver 内完成,报错信息可按阶段分类定位;
- Metastore 是唯一词典:元数据与数据分离是 Hive 的根本设计,生产用远程模式并严格备份;
- 执行引擎可插拔:MR、Tez、Spark 共享同一套编译产物,切引擎不换 SQL;
- 排错先分层:连接问题看 Client 与 HiveServer2,语义问题看 Metastore,卡队列看 YARN,跑得慢看执行计划。
组件分工清楚了,下一节动手把环境搭起来,并打出你人生第一条 EXPLAIN 输出。