4.2 分区:一个目录值一次裁剪
4.2 分区:一个目录值一次裁剪
本节摘要:分区把表按某个键的值拆成 HDFS 子目录,查询命中分区条件时,扫描范围从"全表所有文件"收缩为"目标目录里的文件",代价近乎为零。本节讲分区的目录本质、静态与动态分区写入、多级分区设计、分区数治理的红线,以及让裁剪失效的五种反模式。
为什么一个目录能省一次全表扫描
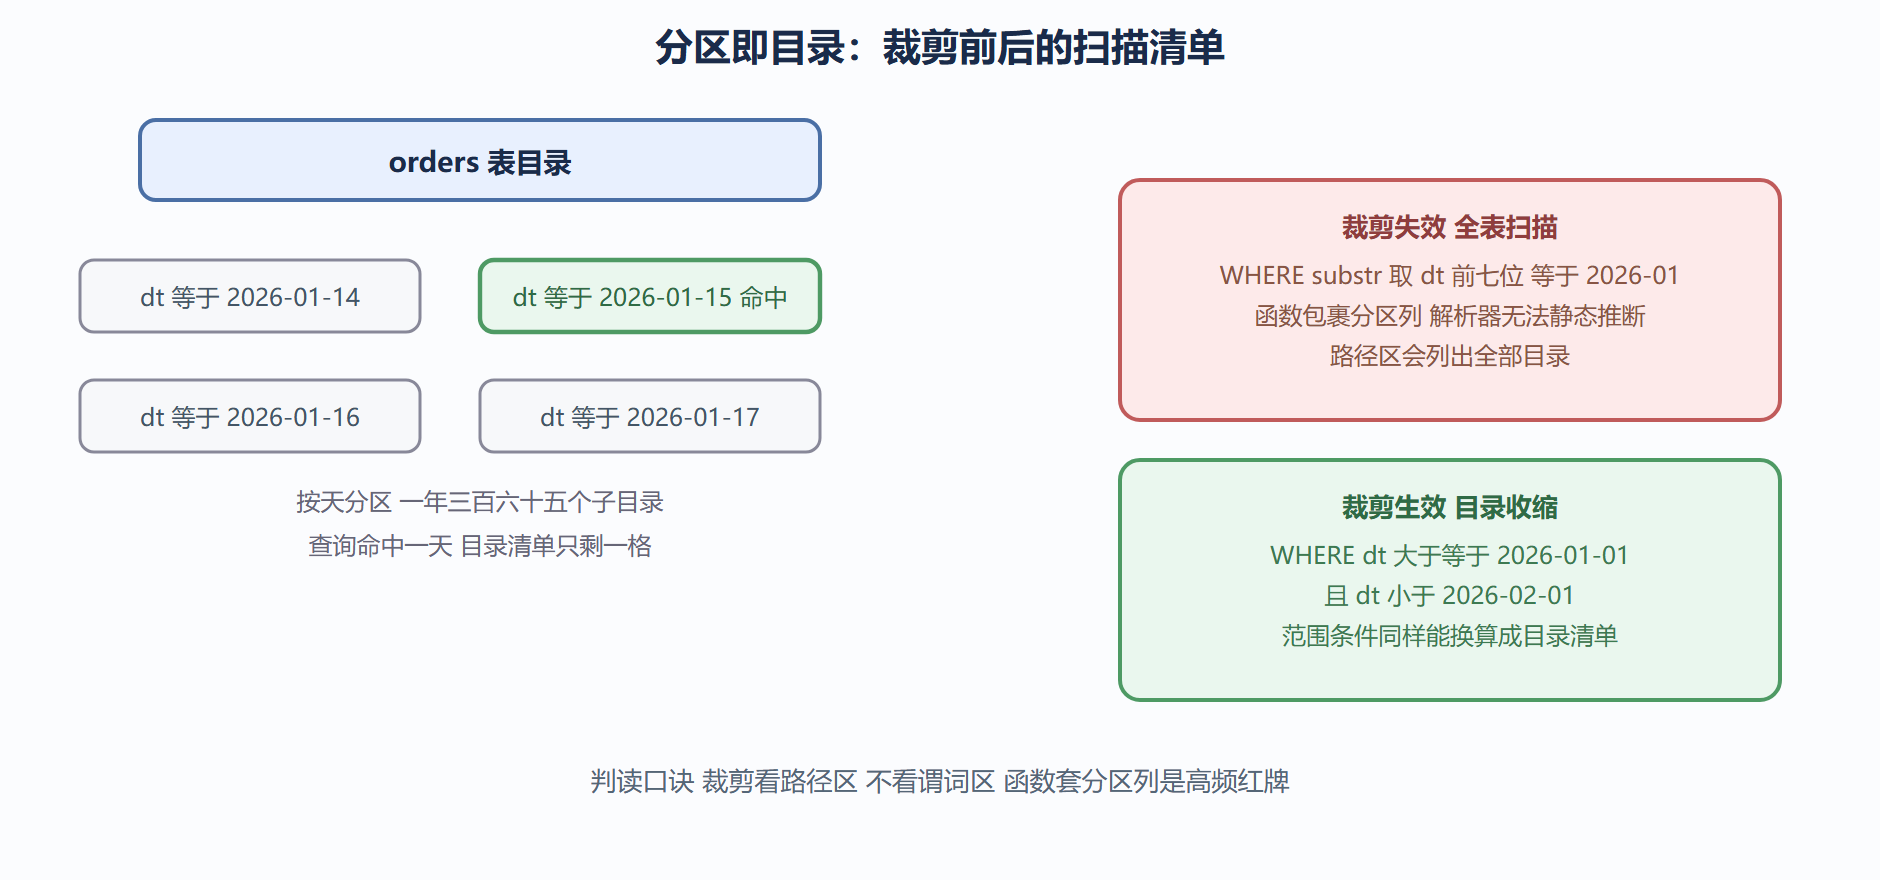
回顾第 2 章:分区裁剪发生在语义分析阶段,Driver 拿着 WHERE 里的分区条件去 Metastore 换一份目录清单,TableScan 只打开清单里的目录。裁剪的收益不来自过滤数据,而来自根本不打开不相干的文件——这是它与 Filter 算子的本质区别,也是它在 EXPLAIN 里不留谓词、只留路径的原因。
分区的物理结构先看清楚。对这张表:
CREATE TABLE mall.orders ( order_id BIGINT, customer_id STRING, amount DECIMAL(10,2) ) PARTITIONED BY (dt STRING) STORED AS ORC;
HDFS 上的布局是"表目录下按分区值建子目录",每个子目录里的文件只含该日期的数据。查询 WHERE dt 等于 2026-01-15 时,扫描清单里只有一个子目录。
分区目录树与裁剪效果
静态分区与动态分区写入
往分区表灌数有两条路。静态分区:分区值由你写死,一次写一个分区:
INSERT INTO TABLE mall.orders PARTITION (dt = '2026-01-16') SELECT order_id, customer_id, amount FROM staging.orders_new;
动态分区:分区值由查询结果里的列提供,一条语句写多个分区:
SET hive.exec.dynamic.partition = true; SET hive.exec.dynamic.partition.mode = nonstrict; INSERT OVERWRITE TABLE mall.orders PARTITION (dt) SELECT order_id, customer_id, amount, dt FROM staging.orders_full;
三个工程细节值得展开。第一,动态分区的分区列必须放在 SELECT 列表最后,与 PARTITION 子句声明的顺序对应——这是"值从数据里来"的语法体现。第二,mode 默认 strict 要求至少一个静态分区列,防止一条语句炸出几千个分区;nonstrict 放开限制,配合最大分区数参数(hive.exec.max.dynamic.partitions)兜底。第三,动态分区可能产出大量小文件:每个 Reduce 任务都会给碰到的每个分区写一个文件,任务数乘分区数就是文件数上限,小文件问题与治理留在第 8 章运维话题里展开。
分区还能挂在 ALTER 上手工管理:ADD PARTITION 建目录、DROP PARTITION 删目录、LOCATION 重定向。外部表配合手工分区挂载,能把"已经在 HDFS 上的历史目录"零拷贝地登记进表——这是外部表加手工分区的经典组合拳,迁移旧数据时不搬一个字节。
多级分区:层级怎么定
分区可以多级,目录随之嵌套:
CREATE TABLE mall.events ( event_id BIGINT, user_id STRING, payload STRING ) PARTITIONED BY (dt STRING, hour STRING) STORED AS ORC;
层级设计的权衡只有一句话:层级越深裁剪越准,但目录越多治理越难。定层级的三个依据:
- 查询模式:日报查询命中天、实时看板命中小时,就按天加小时两级;只看月度汇总的场景,天级都嫌细;
- 数据分布:均匀的时间维度是好分区键;取值仅三五种的低基数字段(渠道、地区)可以做二级分区,但别做一级;
- 分区总量红线:单表分区数建议控制在万级以内。分区是 Metastore 里的记录,也是编译期要遍历的清单——百万分区表的查询,光语义分析取分区清单就可能分钟级,还会把 Metastore 数据库拖下水。
反例警示:把 user_id 这类高基数列做分区键,一天就能造出百万目录,业内称为"分区爆炸"。治理手段是把高基数列交给分桶(下一节)或干脆靠排序与索引型格式。
让裁剪失效的五种反模式
分区建好了,查询却全表扫,问题几乎总出在谓词写法上。五种高频反模式与修法:
| 反模式 | 写法样子 | 为什么失效 | 修法 |
|---|---|---|---|
| 函数包裹分区列 | substr 取 dt 前七位等于某月 | 无法静态换算成目录清单 | 改写成范围条件 |
| 隐式类型转换 | dt 是 STRING 却与数字比较 | 比较前字段被转成 DOUBLE | 字面量写成字符串 |
| 谓词在子查询内侧错过下推 | 分区条件写在深层嵌套里某些写法下 | 优化器推不动 | 条件尽量写在外层 |
| JOIN 之后才过滤 | 分区条件依赖连接结果列 | 只能 Join 后过滤 | 能单侧过滤的先过滤 |
| 分区值大小写或格式漂移 | 目录是 20260115 查询写 2026-01-15 | 等值不命中 | 统一分区值生成规范 |
验证手段只有一个:EXPLAIN 看路径区。第 3 章的五步检查法第二步在这里就是全部——目录清单对不对,一眼定案。
分区与统计信息
分区还影响统计信息的粒度。表级统计(总行数)与分区级统计(每分区行数)分开存放,ANALYZE 语句可以只刷单个分区:
ANALYZE TABLE mall.orders PARTITION (dt = '2026-01-16') COMPUTE STATISTICS;
新分区写入后统计为空,CBO 对它的行数估算是"按文件大小猜",误差大。夜间批处理后顺手刷当日分区统计,是第 7 章 CBO 章节会再次强调的运维纪律。
本节要点回顾
- 本质:分区即子目录,裁剪即目录清单收缩,零过滤成本,EXPLAIN 证据在路径区;
- 两条写入路:静态分区写死值,动态分区值从数据来,分区列放 SELECT 最后;
- 小文件预警:动态分区的文件数上限是任务数乘分区数,nonstrict 模式要配兜底参数;
- 层级设计:按查询模式定层级,单表分区数守住万级红线,高基数列不做分区键;
- 五种裁剪失效反模式:函数包裹、隐式转换、下推丢失、连接后过滤、值格式漂移;
- 分区级统计:新分区要刷统计,否则 CBO 猜数。