4.3 分桶:哈希路由与桶内排序
4.3 分桶:哈希路由与桶内排序
本节摘要:分桶把每个分区内的数据按桶键哈希分成固定数量的文件,同键数据永远落入同编号桶,配合桶内排序形成"文件级的预 Shuffle"。本节讲哈希路由的机制、桶数怎么定、灌数的参数要求、TABLESAMPLE 高效抽样,以及分桶最值钱的产出——SortMergeBucket Join 的触发条件。
分区之后再分文件
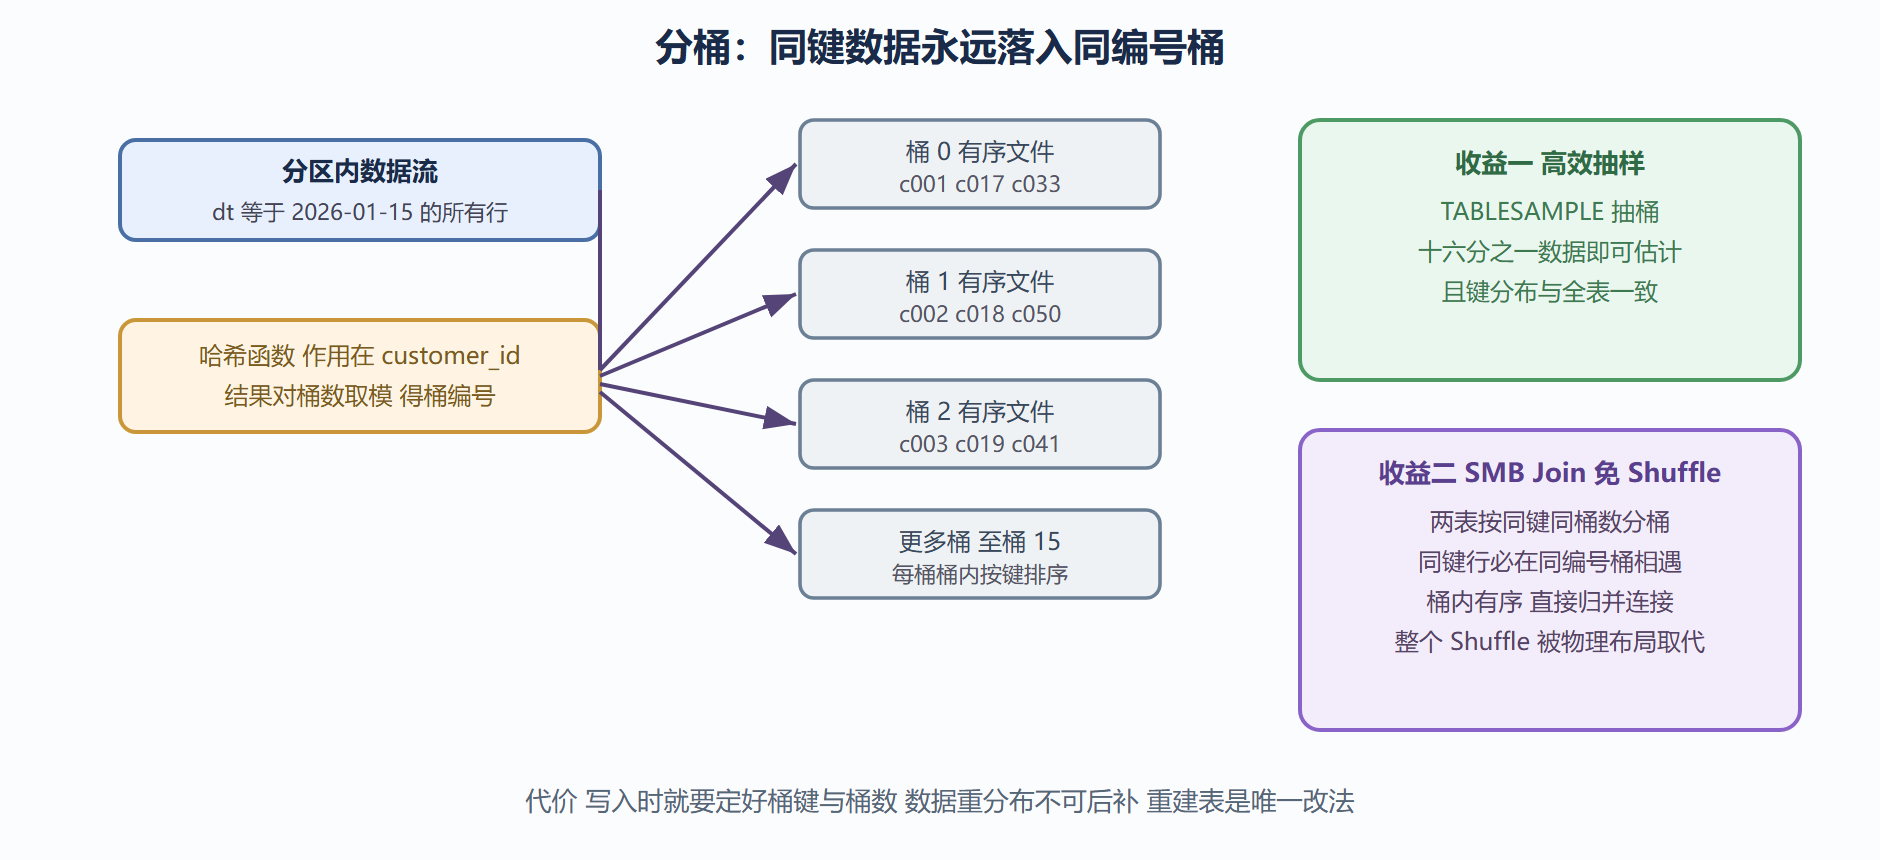
分区解决"按目录裁剪",但每个分区目录里的文件内部是无序的:同一天的订单在文件间随机分布。分桶再加一层组织:分区目录内,按桶键哈希取模,把行分派到固定编号的桶文件里。
CREATE TABLE mall.orders_bucketed ( order_id BIGINT, customer_id STRING, amount DECIMAL(10,2) ) PARTITIONED BY (dt STRING) CLUSTERED BY (customer_id) SORTED BY (customer_id) INTO 16 BUCKETS STORED AS ORC;
三个子句各司其职:CLUSTERED BY 声明桶键(哈希分派的依据),SORTED BY 声明桶内排序键(每只桶文件内部按此有序),INTO 16 BUCKETS 声明桶数。写入时,每行按 customer_id 哈希取模决定去哪只桶。
哈希路由到桶文件
桶数怎么定
桶数是分桶设计里唯一要拍板的数字,依据三条:
按目标文件大小定。每只桶就是一个文件(每个写入任务一只),经验值是每桶几百 MB 到 1GB 区间(ORC 压缩后)。总量 100GB 的分区想拆成约 128 只桶;10GB 拆 8 到 16 只。
按连接场景定。如果这张表将来要和另一张表做 SMB Join,两表桶数必须成倍数关系(最好相等),桶键等于连接键。这是刚性约束,定错就得重建。
按并行度上限定。查询的 Map 任务数与桶文件数相关,桶太少并行度上不去,桶太多小文件成灾。16 到 256 是常见区间。
反模式与分区爆炸同源:桶数拍成几千,每个几 MB,扫描时 NameNode 压力与任务调度开销先于任何收益到来。
灌数的纪律
分桶的收益建立在"数据真的按哈希落桶"之上,而普通 INSERT 不会自动保证这一点(不同版本行为有差异),标准做法是开启强制分桶:
SET hive.enforce.bucketing = true; INSERT OVERWRITE TABLE mall.orders_bucketed PARTITION (dt) SELECT order_id, customer_id, amount, dt FROM staging.orders_full DISTRIBUTE BY customer_id SORT BY customer_id;
DISTRIBUTE BY 决定哪个键进哈希分派,SORT BY 决定桶内排序键,与建表声明一致。LOAD DATA 直接搬文件进分区目录则完全绕过分桶逻辑——文件不会按桶组织,表声明与物理布局脱节,SMB Join 与抽样全部失真。这是分桶最隐蔽的坑:声明在 Metastore,事实在文件里,两者可以对不上。体检方法是抽样验证:
SELECT customer_id, count(*) FROM mall.orders_bucketed TABLESAMPLE (BUCKET 1 OUT OF 16 ON customer_id) GROUP BY customer_id LIMIT 5;
抽出的行若哈希模值与桶编号不符,说明布局已坏,只能重灌。
TABLESAMPLE:抽样即查桶
没分桶的表做 TABLESAMPLE 是按行或按百分比扫全量再截断;分桶表可以直接按桶抽:
SELECT COUNT(DISTINCT customer_id) FROM mall.orders_bucketed TABLESAMPLE (BUCKET 1 OUT OF 32 ON customer_id);
BUCKET 1 OUT OF 32 表示"从 32 桶里抽第 1 桶"——若表是 16 桶,等效抽两只桶的并集。估计基数、验证数据质量、快速探查大表结构时,桶抽样比随机扫描便宜且代表性好(哈希分派保证键分布均匀)。
SMB Join:分桶最值钱的产出
两张大表按同一键连接是 Shuffle 最痛的场景:两边全量过网络。如果两张表都按连接键分桶、桶数成倍数、桶内有序,优化器可以走 SortMergeBucket Join:桶 n 只与桶 n 连接(或与倍数关系的对侧桶组连接),桶内两边都有序,归并式扫过去即完成连接。第 3 章讲的"同键必须物理相遇"被建表时的物理布局提前满足了,运行期 Shuffle 整段消失。
触发条件苛刻(同键、同或成倍数桶数、桶内有序、行数统计齐全),但一旦命中,大表连接性能提升是数量级的。EXPLAIN 里它的指纹是 Join 算子出现在 Map 端算子树里且带 bucket map join 或 merge join 标记、ReduceSink 消失。第 6 章 Join 翻译路径一节会把三条路径放进同一张决策图。
分桶与分区的分工就此清晰:分区对外服务裁剪(查询条件的粒度),分桶对内服务连接与抽样(数据组织的粒度)。时间维度给分区,业务键给分桶,是最常见的组合。
桶数定错了怎么办:一次重建的完整流程
分桶布局没有"改"这个选项——桶数与桶键写进数据文件的物理组织里,ALTER 改不了字节。发现桶数不合理(典型信号:SMB Join 该触发不触发、桶文件普遍只有几兆、或大到拖累单任务),唯一路径是重建。完整流程五步:
-- 第一步 评估新桶数 按当前分区分区的数据量定 目标每桶几百兆 -- 第二步 建新表 新桶数与桶键 CREATE TABLE mall.orders_rebucketed ( order_id BIGINT, customer_id STRING, amount DECIMAL(10,2) ) PARTITIONED BY (dt STRING) CLUSTERED BY (customer_id) SORTED BY (customer_id) INTO 64 BUCKETS STORED AS ORC; -- 第三步 双表并行灌入 开启强制分桶 SET hive.enforce.bucketing = true; INSERT OVERWRITE TABLE mall.orders_rebucketed PARTITION (dt) SELECT order_id, customer_id, amount, dt FROM mall.orders_old DISTRIBUTE BY customer_id SORT BY customer_id; -- 第四步 校验 抽桶验证哈希落位 与行数对账 SELECT COUNT(*) FROM mall.orders_rebucketed TABLESAMPLE (BUCKET 1 OUT OF 64 ON customer_id); SELECT dt, COUNT(*) FROM mall.orders_rebucketed GROUP BY dt; -- 与旧表比对 -- 第五步 切换与清理 下游验证后改名或重建视图指向 旧表择期 DROP
第五步的稳妥做法是建一个视图指向新表(第 4.4 节的兼容层用法),下游 SQL 一行不改完成切换,观察一个周期后再退役旧表。重建成本提醒我们把第 4.3 节的"定桶数三依据"前置到位:分桶是设计期决策,返工要付全量重写的代价,宁可先用抽样数据估算单分区体量再拍板。
本节要点回顾
- 机制:桶键哈希取模定文件,SORTED BY 保证桶内有序,物理布局成为"预 Shuffle";
- 定桶数三依据:目标文件大小、连接场景的倍数约束、并行度区间;
- 灌数纪律:enforce.bucketing 加 DISTRIBUTE BY,LOAD DATA 会绕过分桶造成声明与事实脱节;
- 桶抽样:TABLESAMPLE 按桶抽,便宜且有键分布代表性,也用于验证布局;
- SMB Join:同键同倍数桶数桶内有序,运行期 Shuffle 整段消失,是分桶最大回报;
- 分工口诀:分区管裁剪分桶管连接,时间给分区业务键给分桶。