3.2 Tez与执行引擎选择
3.2 Tez 与执行引擎选择
本节摘要:MR 引擎把多段查询编译成多个顺序执行的作业,每段之间靠 HDFS 中间文件衔接,落盘税被反复征收。Tez 把整条查询组织成一个 DAG 一次提交,顶点之间数据流直连,中间结果不再写 HDFS。本节讲清这笔账怎么算、切换怎么做,以及 MR、Tez、Spark 三个引擎的选型逻辑。
MR 链式执行的隐形税单
一条真实业务查询很少只有一个 Shuffle。典型例子:先 JOIN 两张表,再 GROUP BY,再 JOIN 一张维表,最后 ORDER BY 输出。逻辑计划里出现多次 ReduceSink,物理上就是多段边界。
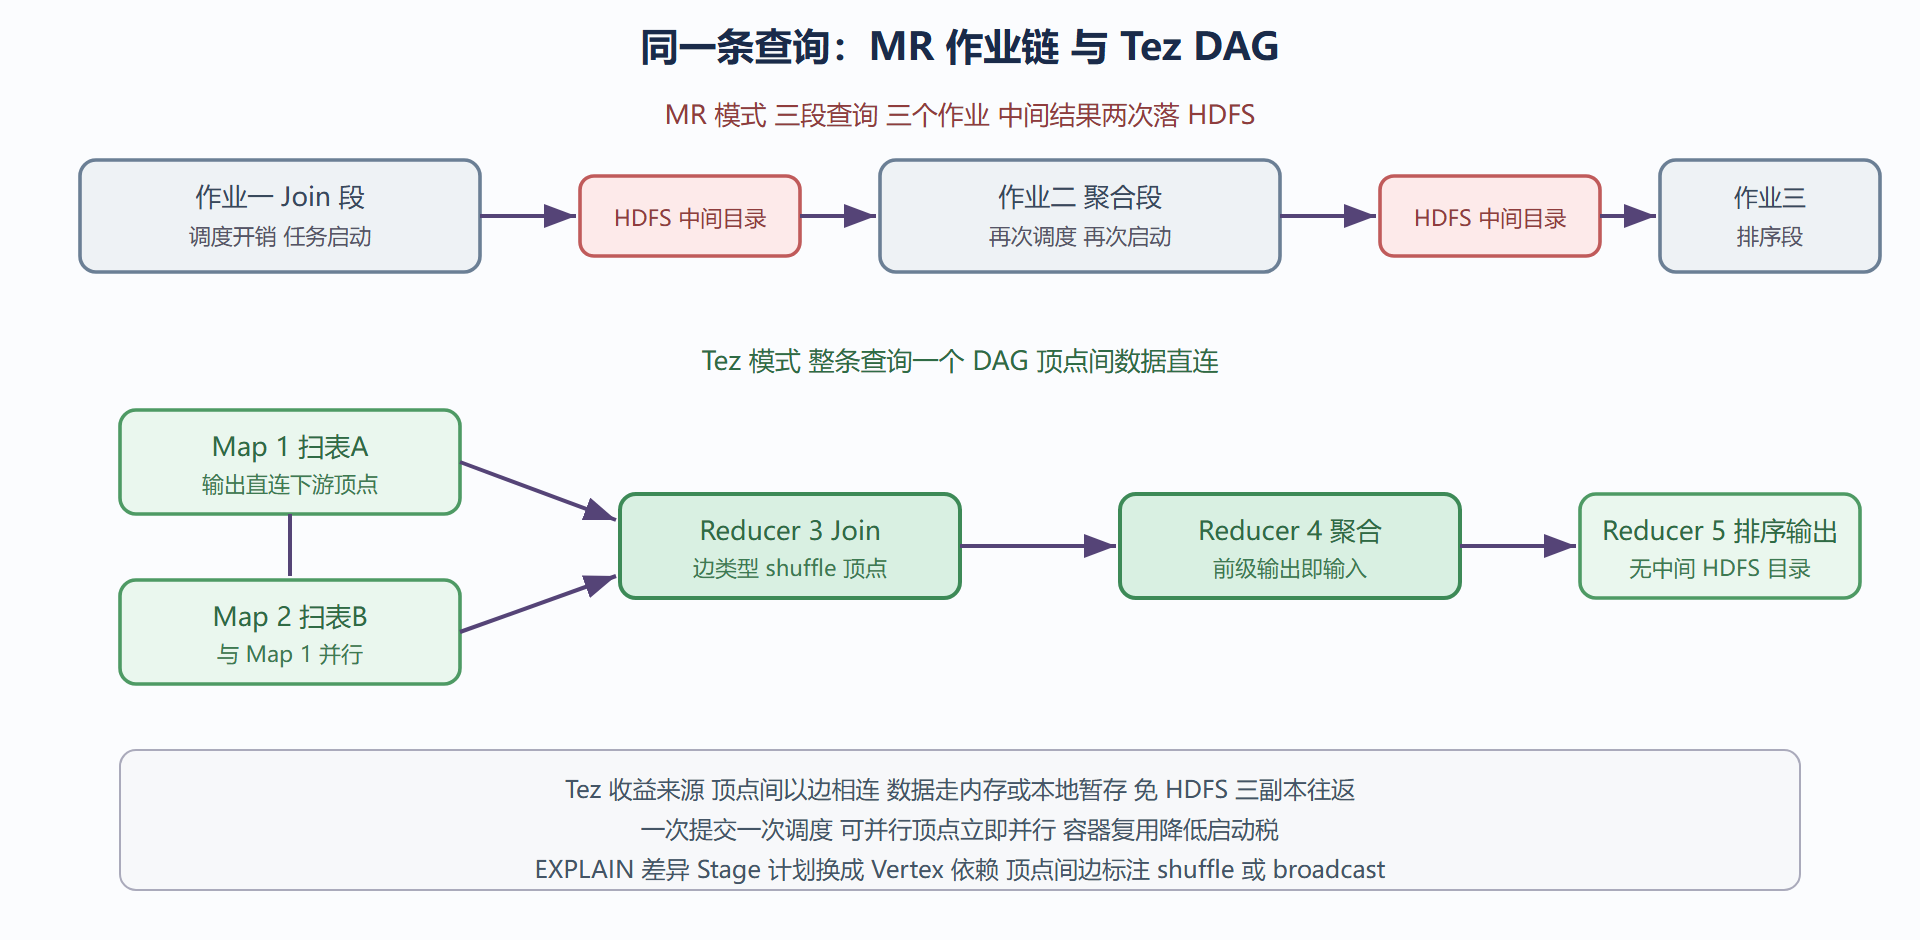
MR 引擎的处理方式是"切段成作业":每段编译成一个独立的 MapReduce 作业,段与段之间用 HDFS 上的临时目录衔接——上一段的输出文件,是下一段的输入。这个设计极其稳健(任何一段失败重跑即可,中间结果就在那),但税单也很直白:
- 中间结果落盘 HDFS:数据写三副本、再读回来,段的数量越多,往返越夸张;
- 每段一套任务调度:向 YARN 重新申请 Container、重启 JVM,任务启动开销按段数倍增;
- 段间无法并行重叠:依赖关系是文件级别的,下一段必须等上一段完全写完才能开扫。
四段查询在 MR 下的时间线大致是"跑、等落盘、调度、跑、等落盘、调度、跑……",纯计算时间可能只占总时长的一半。
MR 链与 Tez DAG 的对比
Tez 的三个机制
DAG(有向无环图)是 Tez 的组织形式:查询里每个"任务角色"成为图上的一个顶点,顶点之间的边声明数据如何流动。支撑它跑得快的机制有三个:
边路由替代文件衔接。MR 模式里段间靠"写 HDFS、读 HDFS"交接;Tez 里上游顶点的输出直接按边路由给下游顶点,可以走内存管道,必要时才溢写本地盘。中间数据不再进三副本的 HDFS,这一项就省下大量磁盘与网络。
容器复用。Tez 的 AM(应用主控)在会话内持有 Container,顶点完成后容器不释放,直接承接下一个顶点的任务。JVM 重启与预热的开销被摊薄,小任务尤其实惠。
顶点内动态并行度调整。Tez 支持按上游实际输出规模动态决定下游顶点任务数(配合 hive.tez.auto.reducer.framework 等参数),比 MR 固定 reduce 数更贴近数据实情。
代价也要说清楚:Tez 的 AM 是长生命周期组件,集群上的 Tez 会话占用内存;DAG 内部某顶点失败时恢复机制比 MR 的"重跑一个作业"复杂;排障时要看 Tez 视图(YARN 的 application 日志加 Tez AM 日志),不熟悉的话定位成本高于 MR。性能与复杂度始终在交易。
切换引擎
切换是一个参数的事,会话级即可验证:
SET hive.execution.engine=mr; SET hive.execution.engine=tez; SET hive.execution.engine=spark;
EXPLAIN 输出会立刻换面孔:mr 模式给 STAGE DEPENDENCIES 与 Map Reduce 段;tez 模式给 Vertex dependency 与 Map 1、Reducer 2 命名的顶点树。逻辑算子部分(Filter、Select、GroupBy 的谓词与 mode)两种引擎完全一致——再次验证第 1 章的论断:引擎换的是物理组织方式,不动翻译语义。
三引擎选型
选型不是"谁快选谁",而是匹配集群现状与团队栈:
| 维度 | MapReduce | Tez | Spark |
| --- | --- |
| 组织方式 | 每段一个作业,HDFS 衔接 | 全查询一个 DAG | 以 Spark 作业执行计划 |
| 中间结果 | HDFS 落盘 | 内存或本地盘直连 | 内存为主,溢写兜底 |
| 启动开销 | 按段重复,最重 | 一次调度加容器复用,轻 | 依赖 Spark 常驻服务 |
| 稳定性 | 最稳,排查简单 | 好,恢复机制较复杂 | 受 Hive on Spark 适配版本约束 |
| 生态匹配 | 老集群、兼容优先 | Hive 默认推荐,批处理主力 | 团队已有 Spark 栈,统一计算层 |
| 适用场景 | 深夜批任务、极端稳定要求 | 日常 ETL 与即席查询的折中 | 与 Spark 流批一体架构合流 |
经验法则:新部署直接 Tez 起步;历史 MR 集群按队列灰度切换;重度 Spark 团队评估 Hive on Spark 或干脆把 SQL 迁到 Spark SQL。另外 LLAP 是 Tez 的加速插件(常驻守护进程加缓存),适合报表场景的重复查询加速,第 7 章与向量化一起讲。
一个对照实验
同一查询在两种引擎下的时长对比值得亲手做一次:
SET hive.execution.engine=mr; EXPLAIN SELECT c.region, COUNT(*) FROM orders o JOIN customers c ON o.customer_id = c.customer_id GROUP BY c.region; -- 记下 Stage 数量 SET hive.execution.engine=tez; EXPLAIN SELECT c.region, COUNT(*) FROM orders o JOIN customers c ON o.customer_id = c.customer_id GROUP BY c.region; -- 记下 Vertex 数量与边类型
两份计划并排看:算子一致、组织不同。再分别执行计时(小数据集差异不大,段数多的查询差异才明显),你对"引擎税"的体会会从概念变成体感。面试里被问"Tez 为什么比 MR 快",标准答案的三点——DAG 免中间 HDFS 落盘、容器复用、动态并行度——你都能拿自己的实验佐证。
本节要点回顾
- MR 的税单:段间 HDFS 中转、按段重复调度、段间无法重叠执行;
- Tez 的解法:DAG 一次提交、边路由直连数据、容器复用、动态并行度;
- 代价对价:Tez 排障复杂度与 AM 内存占用高于 MR;
- 切换成本极低:一个参数、SQL 与逻辑算子完全不变,EXPLAIN 换的只是物理描述;
- 选型逻辑:稳定与兼容选 MR,默认推荐 Tez,团队栈统一选 Spark,报表加速再叠 LLAP。