3.1 MapReduce执行模型:Shuffle全过程
3.1 MapReduce 执行模型:Shuffle 全过程
本节摘要:物理计划的最小执行单元是 Map 与 Reduce 任务,两者之间隔着整个大数据体系里最贵的一段路——Shuffle。本节从 Map 端环形缓冲区出发,走完溢写、分区、排序、归并、HTTP 拷贝、Reduce 归并的全过程,再把 GroupBy 与 Join 两种典型算子放到这套骨架上,说明它们为什么必须付这段网络税。
一切物理代价都来自"按键重分布"
第 2 章结尾说过:逻辑计划里出现 ReduceSink 算子,物理上就多一段任务边界。ReduceSink 的语义是"按某组键把数据重新分布"。GROUP BY customer_id 要求同键的行落到同一个 Reduce 任务;JOIN 要求连接键相同的行相遇。"相同键必须物理相遇"是分布式 SQL 的一条铁律,而让数据物理相遇的唯一办法,就是把它们搬运到同一台机器——这段搬运就是 Shuffle。
理解 Hive 性能,一半的功力在理解 Shuffle 的每一步开销。整个过程分 Map 端与 Reduce 端两半:
Shuffle 全景:从 Map 输出到 Reduce 输入
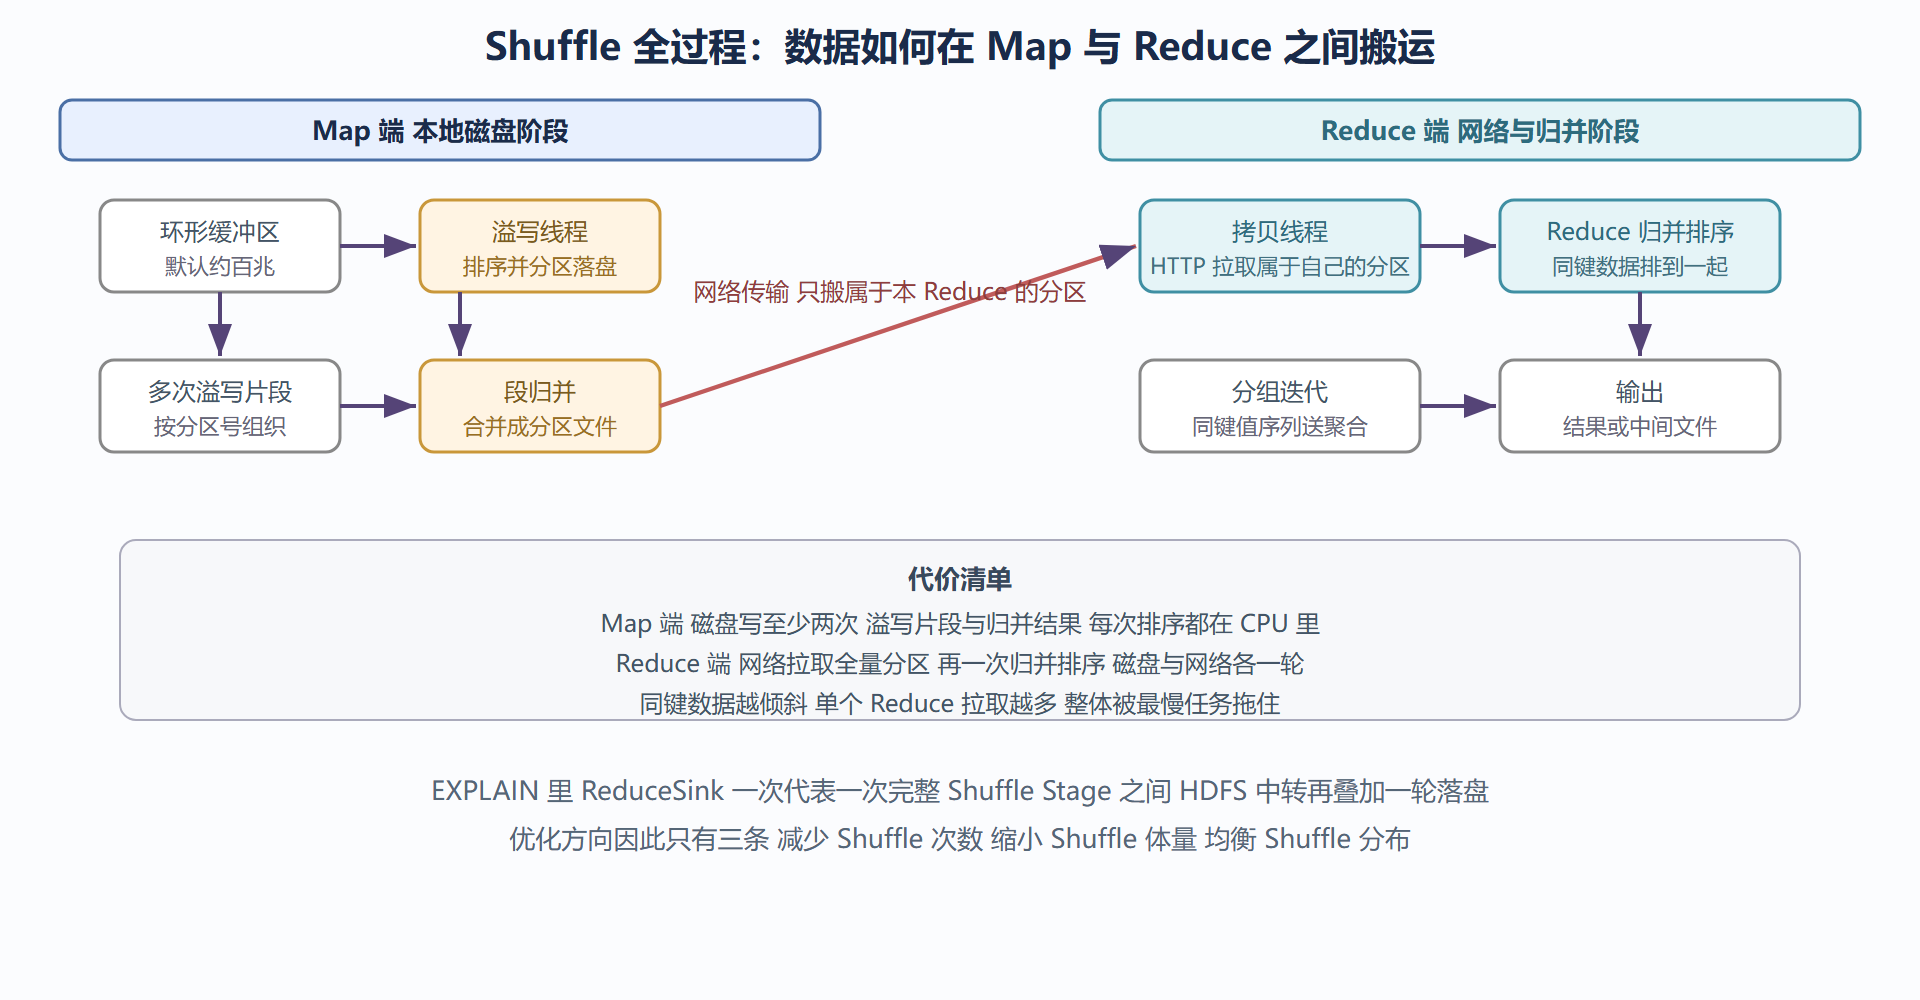
逐步展开:
Map 端。每条输出记录先写进内存里的环形缓冲区(默认约 100MB,阈值 80% 触发溢写)。溢写线程把缓冲区内容按"分区号、排序键"排序后写成磁盘片段——分区号由 Shuffle 分区函数对键哈希取模得到,决定了这条记录将来归属哪个 Reduce 任务。Map 结束前,多个片段归并成一个按分区组织的文件。这一阶段全部发生在 Map 任务本地:一次内存排序、若干次磁盘写。
Reduce 端。每个 Reduce 任务起若干拷贝线程,通过 HTTP 从所有已完成 Map 任务那里拉取属于自己的那个分区。拉完的片段再做一轮归并排序,让相同键的记录物理相邻,然后按键分组迭代,喂给聚合或连接逻辑。
把代价数一遍:Map 端至少两次磁盘写(溢写与归并),Reduce 端一次全量网络拉取加一次磁盘归并。一次 Shuffle,磁盘两三轮、网络一整轮、排序两遍。这就是为什么第 2 章的优化规则(下推、裁剪、Map 端聚合)全部指向同一个目标:让更少的数据走到这段路上。
GroupBy 搭在骨架上
有了物理图景,回头看 GROUP BY 的翻译。SELECT customer_id, SUM(amount) GROUP BY customer_id:
- Map 任务扫各自的数据片,输出键值对(customer_id, amount);
- Shuffle 分区函数按 customer_id 哈希,保证同客户的所有订单进同一个 Reduce;
- Reduce 收到同键的一串 amount,求和输出。
配合第 2 章的 Map 端聚合规则:Map 输出前先在本地把同键的 amount 压成部分和,网络上传的是部分和而不是原始行。两个机制叠加后,Shuffle 体量从"行数"级压到"任务数乘键数"级。
EXPLAIN 里对应的指纹是 ReduceSink 的 key expressions 与 GroupBy 的 mode 标记。看到 mode hash 加 mergepartial 成对出现,就知道两段式聚合已生效;只有 complete 一种模式时,说明原始行直接上了网络,通常意味着 Map 端聚合被关或失效,值得追问原因。
Join 搭在骨架上
Reduce 端 Join(也叫 Common Join 或 Shuffle Join)的翻译稍复杂,因为要拼两张表:
- 两张表的 Map 任务各自输出记录,键是连接键 customer_id,值里带一个"表来源标签";
- Shuffle 按连接键分区,于是"能连上的行"在同一个 Reduce 相遇;
- Reduce 把一边(通常是大表)缓存在内存或溢写结构里当查找表,逐条扫描另一边做拼接。
EXPLAIN 里认它的特征:两个 TableScan 分支汇入同一个 Reduce 端的 Join Operator,且 ReduceSink 出现在两侧 Map 树的末尾。代价结构也清楚了:两张表的全量数据都要过一次 Shuffle。第 6 章会讲三条翻译路径里的另外两条——小表广播的 MapJoin 与排序合并的 SMB Join,本质上都是对"两边都上网络"这个代价结构的反击。
溢写与倾斜:两个高频故障的物理根源
溢写过多。Map 输出很大(例如高基数分组没做预聚合)时,溢写片段数量暴涨,归并轮数增加,任务日志里会出现 Spilled Records 远大于 Map output records 的迹象。对策回到逻辑层:让更多过滤与预聚合发生在 Map 端,或者加大缓冲区、提高溢写线程并行度——但首选永远是缩小输出本身。
单个 Reduce 拖垮全局。键分布倾斜时,某个键占据大比例记录,全部涌向一个 Reduce 任务。进度条上 99% 的任务秒完成、剩一个跑半小时,是倾斜的标准画面。物理根源同样在 Shuffle:分区函数只保证"同键同任务",不保证"任务间均衡"。治理手段(加盐打散、两阶段聚合、MapJoin 绕过)第 6 章专门展开,这里先建立认知:倾斜不是任务慢,是分布设计遭遇了数据分布。
用计数器亲眼看一次 Shuffle
理论说尽,给自己安排一个十分钟的观察实验。挑一张中等大小的分区表,跑一条带 GROUP BY 的查询,任务完成后打开 YARN 应用页面的计数器区(或在任务历史里看 counters),对照下面这张清单读数:
| 计数器 | 含义 | 健康形态 |
|---|---|---|
| Map output records | Map 端输出的逻辑记录数 | 接近过滤后行数为正常 |
| Map output bytes | 进入序列化的字节数 | 与扫描量同量级 |
| Spilled Records | 溢写到磁盘的记录数 | 与 Map output records 同量级为健康 |
| Combine output records | 预聚合后的输出记录数 | 远小于 Map output records 说明聚合有效 |
| Reduce shuffle bytes | 网络上实际搬运的字节数 | 与 Combine output 挂钩 越小说明两段式越赚 |
| Reduce input records | Reduce 端收到的记录数 | 等于各任务 Combine 输出之和 |
三个读数组合出的诊断结论比任何"感觉慢"都有力:Spilled Records 数倍于 Map output records,说明缓冲区不够或输出过大,先看能不能把更多过滤推进 Map 端;Combine output records 几乎等于 Map output records,说明分组键基数极高、预聚合没压到东西(第 6 章的高基数场景);Reduce shuffle bytes 与扫描量同量级,说明网络税接近全额征收,查询设计有大刀阔斧的空间。
再做一个对照实验:同一条查询把 SELECT 列表从两列改成十列,重跑一次看 Map output bytes 与 shuffle bytes 的涨幅——你会直观看到列裁剪被破坏后的网络代价,这个数字比任何文档里的"建议显式列清单"都有说服力。把两次实验的计数器读数存进个人笔记,它们是你日后判断"这条查询的 Shuffle 是否健康"的第一组基线。
顺带把 Reduce 数量的物理直觉补全:Reduce 任务数并非由 Shuffle 决定,而是由提交时的配置推算(第 7 章参数节细讲),Shuffle 只决定"每个 Reduce 该拿哪些数据"。于是并行度与均衡是两件事:任务数给足了,键分布倾斜照样长尾;键分布均匀,任务数不够照样慢。理解这层分离,第 6 章的倾斜治理(治分布)与第 7 章的参数调优(治并行度)才不会张冠李戴。
本节要点回顾
- 铁律:相同键必须物理相遇,Shuffle 是实现手段,也是主要物理代价;
- 五步走:缓冲、溢写(排序加分区)、段归并、网络拷贝、Reduce 归并分组;
- 代价结构:一次 Shuffle 约等于磁盘两三轮、网络一整轮、排序两遍;
- GroupBy 翻译:分组键即分区键,两段式聚合压网络体量;
- Join 翻译:连接键即分区键,表来源标签解决两边数据拼对,两边全量过网络;
- 两大故障根源:溢写过多源于 Map 输出过大,长尾任务源于键分布倾斜,对策都在缩小与均衡 Shuffle。