7.1 文件格式与压缩:TextFile到ORC
7.1 文件格式与压缩:TextFile 到 ORC
本节摘要:STORED AS 子句决定数据文件的字节组织方式。行存(TextFile、SequenceFile)按行连续存放,列存(ORC、Parquet)按列连续存放并内建轻量索引。本节画清两种物理图景、拆开 ORC 文件的三层结构、给出压缩算法取舍表与格式迁移实操,并用一个对照实验量化列存的扫描收益。
同一条 SELECT,两种物理代价
第 6 章反复说"列裁剪让没用的列不被读",这句话在 TextFile 与 ORC 上的兑现程度完全不同。先看物理:
行存的账。TextFile 里一行是一段连续字节,八十列的表每行都是"八十列连排"。查询只要两列时,扫描器仍要读完每一行的全部字节才能挑出那两列——列裁剪省的是解析与传输,省不了磁盘读取。行存的价值在通用:可读、可 cat、一切工具都能处理、装载零转换。
列存的账。ORC 与 Parquet 把同一列的值连续存放:amount 列的所有值挤在一起,customer_id 列的所有值挤在一起。查询两列时,其他七十八列的磁盘块根本不会被请求。列裁剪从"解析层优化"升级成"IO 层免单"。
行存与列存的物理图景
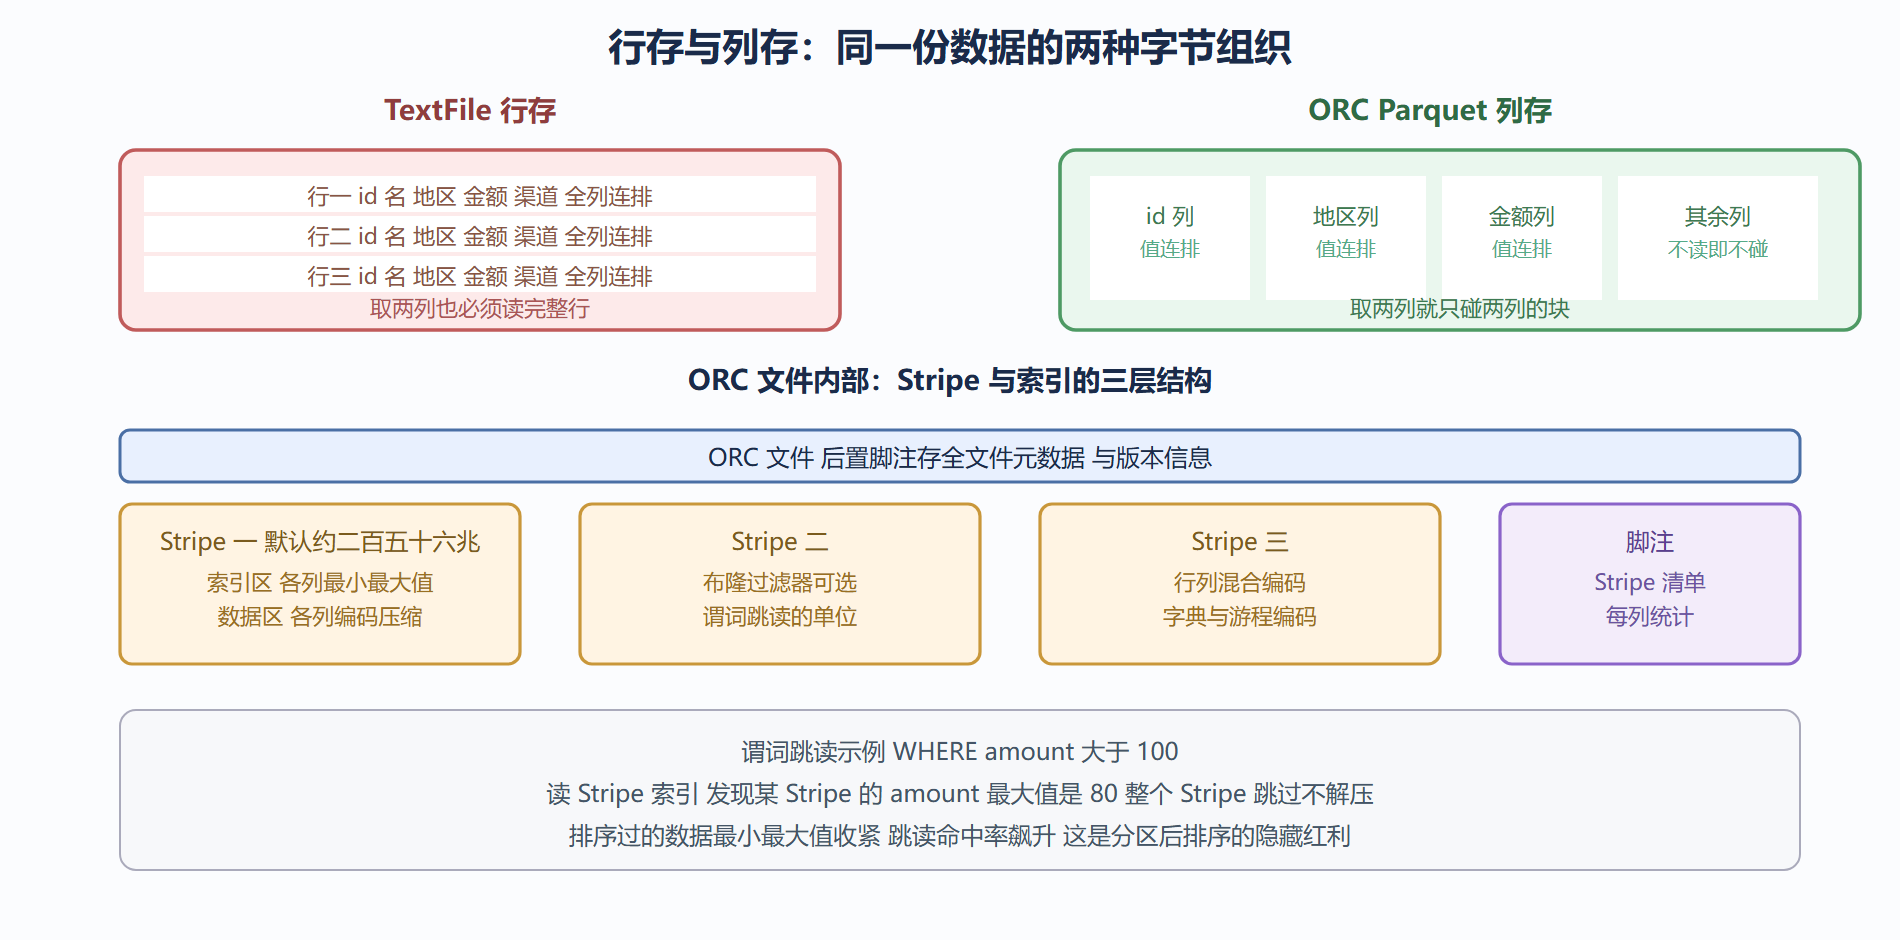
ORC 的三层结构
ORC(Optimized Row Columnar)是 Hive 生态的默认推荐格式,文件由三部分构成:
Stripe(条带):数据的水平切片,默认约 250MB。每个 Stripe 内部按列组织,先索引区后数据区。Stripe 是谓词跳读的基本单位:索引区记录每列(每万个值一组)的最小值、最大值、空值数,查询的 WHERE 条件与区间完全不相交时,该组数据直接跳过,不解压、不计算。
脚注(Footer):文件尾部的全文件元数据——Stripe 清单、每列的类型与统计、压缩参数。读取 ORC 文件先读脚注再按需定位 Stripe,这就是"文件内索引"的实现方式。
可选布隆过滤器:等值查询在高基数列上的加速器(表属性里开启),进一步排除"肯定不含该值"的块。
Parquet 的结构思想同源(行组加列块加页,脚注统计),生态位略有差异:Spark 与计算引擎社区偏 Parquet,Hive 原生工具链偏 ORC。两者在 Hive 里都是一等公民,选型更多看团队既有资产与跨引擎需求,性能差异通常小于设计差异(分区与排序做得对不对)。
一个常被忽略的联动:数据写入时按常用过滤列排序,能让 Stripe 的最小最大值区间高度收紧,跳读命中率飙升。同样的 ORC 表,写入顺序不同,扫描成本差几倍不稀奇。这是"物理布局红利"在文件内部的延续——分区分桶管目录与文件间,排序管文件内。
压缩:磁盘与 CPU 的交易
压缩族谱按强度与速度排:ZSTD 与 ZLIB 压得狠解得慢,LZ4 与 SNAPPY 压得松解得快。选择维度只有两个:读多写少选狠的(存储与 IO 都省),读写均衡或网络敏感选快的(解压快、扫描吞吐高)。
| 算法 | 压缩比 | 解压速度 | 适用 |
|---|---|---|---|
| ZLIB | 高 | 慢 | 冷数据归档 读极少 |
| ZSTD | 高 | 中 | 新冷数据的均衡之选 |
| SNAPPY | 中 | 快 | 热数据扫描 扫描重负载 |
| LZ4 | 中低 | 最快 | 追求扫描吞吐 |
对 ORC 表,压缩参数在建表时声明:
CREATE TABLE mall.orders_orc ( order_id BIGINT, customer_id STRING, amount DECIMAL(10,2) ) PARTITIONED BY (dt STRING) STORED AS ORC TBLPROPERTIES ('orc.compress' = 'SNAPPY', 'orc.create.index' = 'true');
列存与压缩还有一层共生关系:同一列的值类型一致、相近者众,字典编码与游程编码先把重复值压成短码,再上通用压缩——列存的压缩比普遍比行存高出一截,这是格式迁移时"体积掉一半以上"现象的主要来源。
格式迁移实操
存量 TextFile 表迁 ORC,标准动作是 INSERT SELECT 重写:
CREATE TABLE mall.orders_orc (LIKE 原表结构) STORED AS ORC; INSERT OVERWRITE TABLE mall.orders_orc PARTITION (dt) SELECT 全部列, dt FROM mall.orders_text;
三个注意:迁移是全量重写,按分区分批做,控制任务体量;迁移窗口内双表并存,下游切换后再删旧表;迁移时顺手把排序做进新表(写入带 SORT BY),把文件内跳读的红利一起拿走。老表若是外部表且上游继续产 TextFile,就在贴源层与明细层之间加一道常驻转换作业,贴源层保持行存(上游兼容),明细层起转列存(分析加速)——这正是第 8 章分层架构里 ODS 与 DWD 的典型分工。
对照实验:量化列存收益
环境里准备同一份数据的两种格式,跑同一条查询:
-- 两表数据一致 仅格式不同 SELECT customer_id, SUM(amount) FROM mall.orders_text WHERE dt = '2026-01-16' GROUP BY customer_id; SELECT customer_id, SUM(amount) FROM mall.orders_orc WHERE dt = '2026-01-16' GROUP BY customer_id;
EXPLAIN 两份计划的算子结构完全一致(格式不影响翻译骨架),差异全在 TableScan 的读取成本上:执行耗时上 ORC 版本通常数倍领先,且表的列数越多、查询取的列越少,差距越大。把两个版本各跑三次取中位数,这个数字会成为你说服团队迁移的最硬证据。
本节要点回顾
- 物理决定收益量级:列裁剪在行存省解析、在列存直接免 IO;
- ORC 三层结构:Stripe 是跳读单位、脚注是文件索引、布隆是等值加速器;
- 排序红利:写入时按过滤列排序,收紧最值区间,跳读命中率飙升;
- 压缩交易:冷数据 ZSTD 或 ZLIB,热数据 SNAPPY 或 LZ4,列存压缩比天然更高;
- 迁移是重写:分批做、双表过渡、顺手带排序;贴源行存明细列存是标准分层姿势;
- 算子不变介质变:EXPLAIN 骨架一致、耗时差异全在扫描层——格式是给 TableScan 买的加速器。