7.2 CBO、向量化与LLAP
7.2 CBO、向量化与 LLAP
本节摘要:规则优化器只会"能推就推",成本优化器 CBO 会算账:借助统计信息估算每种候选计划的代价,挑便宜的执行。本节讲 CBO 的估算流程、统计信息采集纪律与典型翻车现场;向量化执行把逐行处理改成逐批处理;LLAP 用常驻守护进程与缓存压缩任务启动与重复扫描的成本。
从"能推就推"到"算账再走"
第 2 章结尾留的问题在这里接上:三表连接的顺序选择,规则优化器只能按书写顺序编。CBO(Cost-Based Optimizer,Hive 2.0 起默认启用,底层是 Apache Calcite 框架)换一种决策方式:
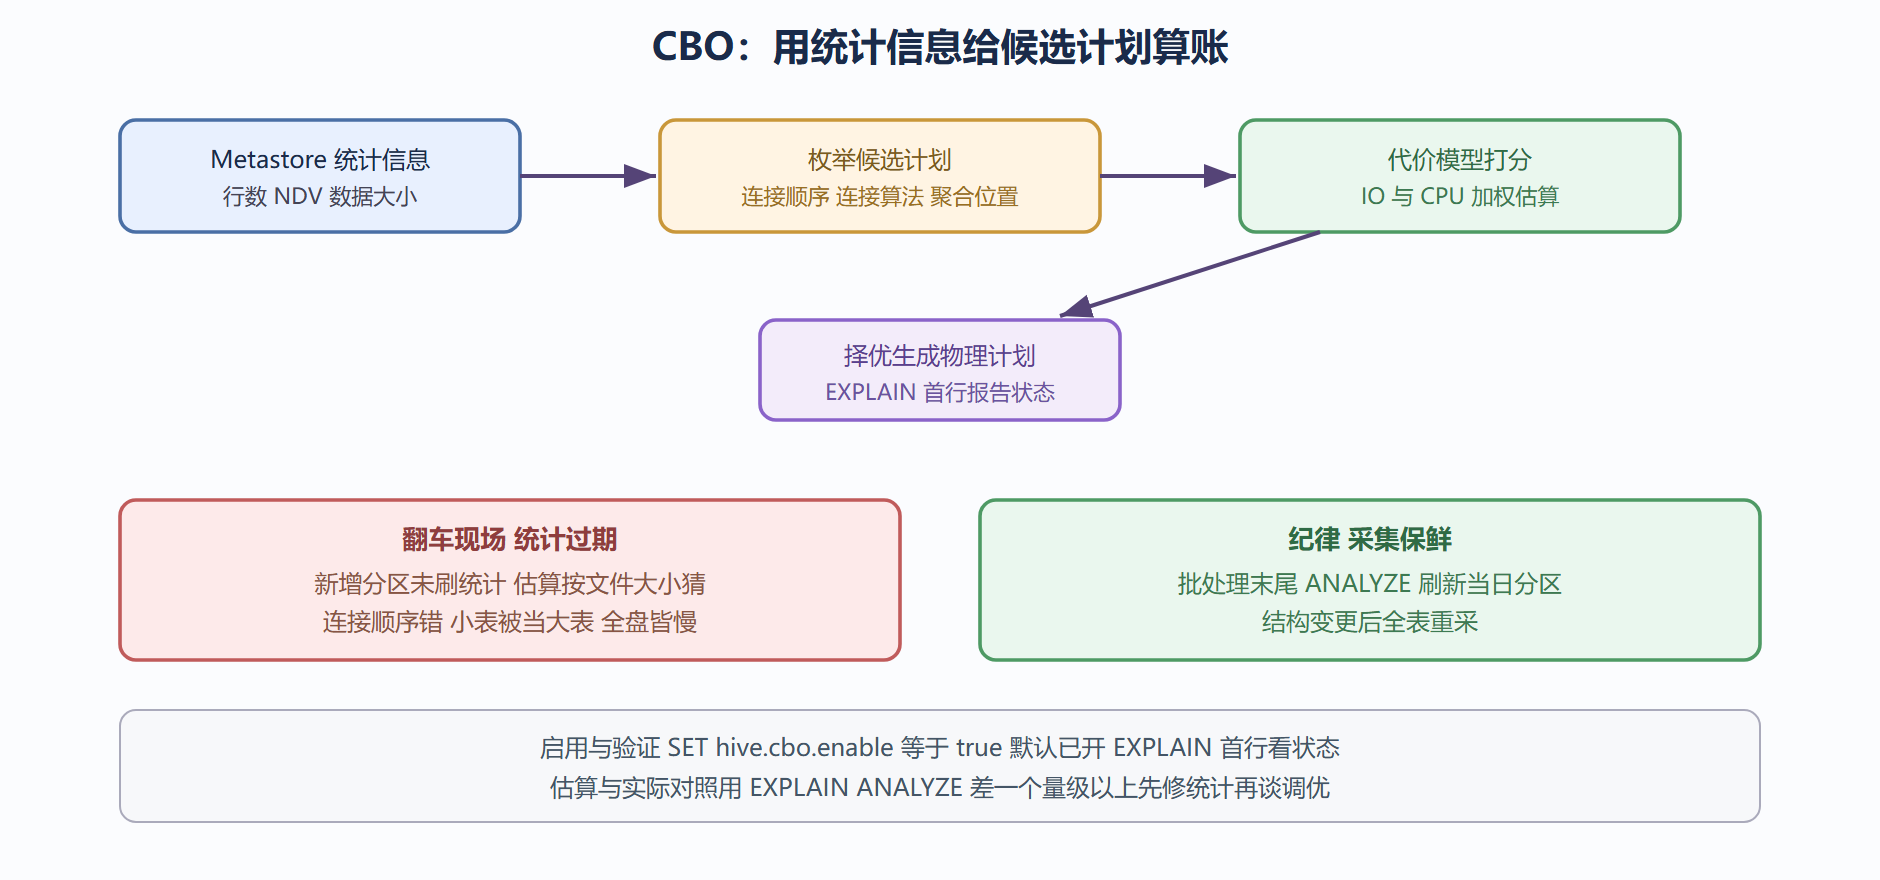
第一步,收集事实。从 Metastore 取各表的行数、平均行大小、列的 NDV(不同值个数)、空值率,配合分区裁剪后的分区清单,估算每个输入的实际规模。
第二步,枚举与估算。对连接顺序、连接算法(MapJoin 还是 Shuffle Join)、聚合位置等决策点枚举候选组合,用代价模型(行数乘以 IO 与 CPU 的权重)给每个候选打分。
第三步,选优执行。分数最低的计划胜出,翻译成物理执行单元。
EXPLAIN 输出的第一行直接告诉你 CBO 是否参与:Plan optimized by CBO(或类似字样)说明走了成本优化;反之 Plan not optimized by CBO 则是规则优化器的产物。这一行是读计划时的新增检查点。
CBO 决策流程
统计信息的采集纪律
CBO 的智商完全等于统计信息的新鲜度。采集命令族:
-- 表级与分区级基础统计 ANALYZE TABLE mall.orders COMPUTE STATISTICS; ANALYZE TABLE mall.orders PARTITION (dt = '2026-01-16') COMPUTE STATISTICS; -- 列级统计 NDV 等 CBO 决策连接顺序的关键输入 ANALYZE TABLE mall.orders COMPUTE STATISTICS FOR COLUMNS customer_id, region;
纪律清单:新分区写入后立即刷分区统计(挂进批处理尾部,零成本习惯);表结构变更(加列、改分桶)后全表重采;列统计至少覆盖连接键与高频过滤键;对"重要但未采"的表建立巡检(DESCRIBE FORMATTED 里的统计时间戳可以看出多久没采)。
翻车现场复盘:某查询白天正常、夜间批处理后变慢——新分区统计为空,CBO 按文件大小猜测行数,把大表当小表广播,MapJoin 内存溢出降级重试。修法不是调参,是批处理末尾补一行 ANALYZE。看到"该 MapJoin 没 MapJoin"或"不该广播却广播",第一反应永远是查统计,EXPLAIN ANALYZE 的估算与实际行数对照是定案证据。
向量化:从逐行到逐批
传统执行器一次处理一行:读一行、算一行、写一行,虚函数调用与分支判断按行支付。向量化执行(Hive 0.13 引入,持续增强)改成一次处理一批(默认 1024 行):
- 数据按列成块读入,算子对整批做同样的操作,CPU 的 SIMD 指令与流水线 prefetch 都吃得饱;
- 虚调用与对象分配按批摊薄,JVM 的对象开销骤减;
- 配合列存格式(ORC 天然按列供数)收益最大,TextFile 需要额外转换。
启用是两个参数的事(对 ORC 表生效):
SET hive.vectorized.execution.enabled = true; SET hive.vectorized.execution.reduce.enabled = true;
EXPLAIN 里向量化的指纹是算子旁的 VectorGroupBy、VectorFilter 之类前缀。适用边界也要知道:部分表达式(某些 UDF、复杂嵌套类型操作)未向量化,遇到时该算子回退行式,批内混跑收益打折——生产上把向量化当"无脑默认开、个别查询观察"的全局项。
LLAP:把"常驻"还给批处理引擎
Hive 的经典短板是任务启动税:每个查询冷启动容器、冷读文件。LLAP(Live Long and Process)在 Tez 之外加一层常驻守护进程:
- 常驻执行器:一小簇长期存活的容器内嵌执行逻辑,查询到来直接复用,免去冷启动;
- 智能缓存:热数据(维表、高频分区)缓存在守护进程内存,重复查询免读盘;
- 预取与下推 IO:与 ORC 的异步 prefetch 联动,扫描与计算重叠。
适用画像非常清晰:报表与 BI 场景——查询模式固定、并发高、重复扫描多。夜间大规模 ETL 不受益(数据只扫一遍,缓存白搭),反而要避免守护进程与批任务抢资源。启用形态与版本强相关(通常经 HiveServer2 交互式服务形态提供,参数族以 llap 为前缀),部署复杂度高于普通调优项,一般由平台团队统一管理,业务侧知道"哪些查询该路由到 LLAP 队列"即可。
三种加速的分工表
| 手段 | 加速环节 | 启用成本 | 见效场景 |
|---|---|---|---|
| CBO 加统计 | 计划决策 连接顺序与算法 | 低 默认开 维护统计即可 | 多表连接复杂查询 |
| 向量化 | 单机执行吞吐 | 低 参数即开 | ORC 扫描聚合 |
| LLAP | 启动税与重复 IO | 高 平台级部署 | 高并发报表固定查询 |
三者正交叠加:介质好(第 7.1 节)让 IO 便宜,CBO 让计划聪明,向量化让单机跑得快,LLAP 让重复查询免重复。调优次序感由此定型:先格式与布局、再统计与 CBO、再向量化、最后 LLAP 与参数微调。
本节要点回顾
- CBO 三步:收事实(统计)、枚举打分、择优落地,EXPLAIN 首行报告参与状态;
- 统计纪律:分区写入即刷、变更即重采、连接键必须采列统计;
- 翻车定式:估算与实际差一个量级,先修统计再谈参数;
- 向量化:逐行改逐批,ORC 上默认开,个别未向量化算子自动回退;
- LLAP:常驻执行器加缓存,报表并发场景的专属武器,部署是平台级工程;
- 正交叠加:介质、计划、单机、重复四级加速各管一段,按次序启用。