8.4 故障排除与未来趋势
8.4 故障排除与未来趋势
本节摘要:故障排除是全册知识的综合应用:先分层定位(连接层、编译层、调度层、执行层、存储层),再按层取证,每层都有明确的证据入口。本节给出一套定位决策图与四类高频故障的取证路径,随后展望 Hive 的四个演进方向——云原生存储分离、Serverless 化、实时增量、AI 数据供给——并说明翻译官的定位如何随之变化。
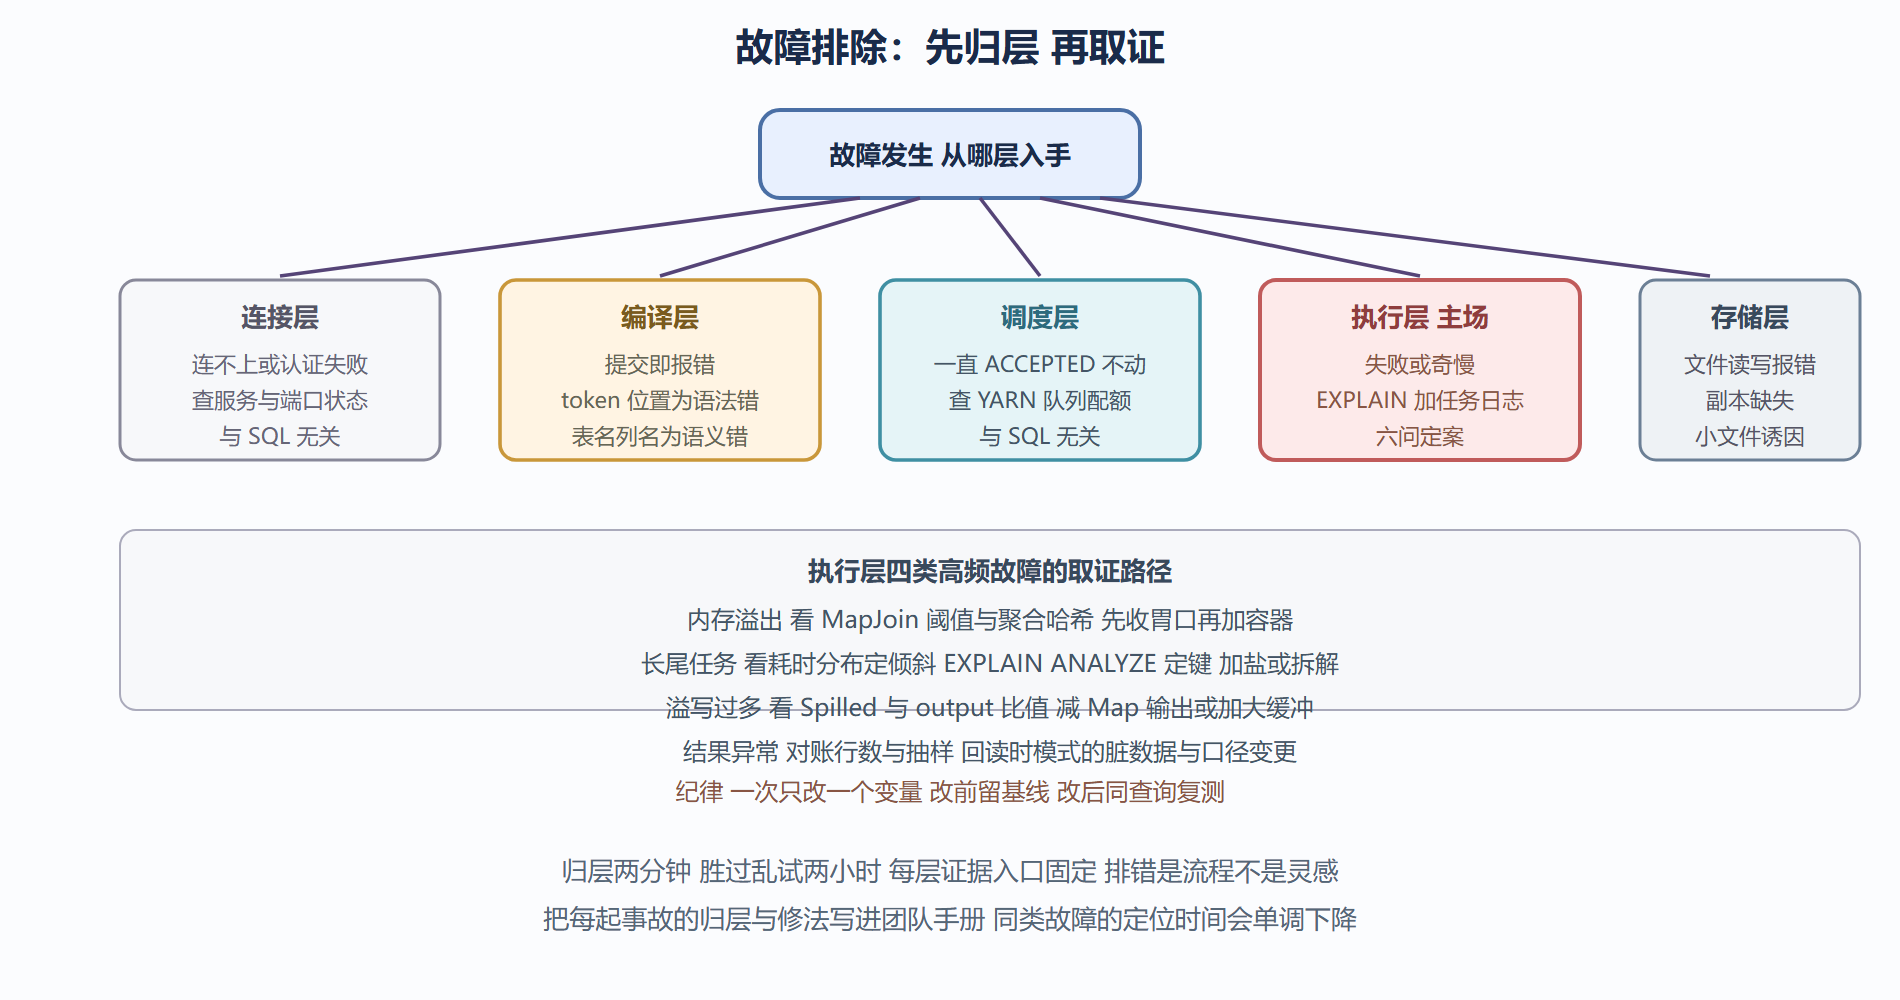
定位先行:故障的五个层
排错最贵的动作是乱试。先花两分钟把故障归层,取证路径就定了:
连接层:Beeline 连不上、认证失败——问题在 HiveServer2 或 Kerberos,看服务状态与端口,与 SQL 和数据无关。
编译层:提交即报错(语法、语义、Metastore 超时)。第 2 章的报错分类法在这里兑现:带 token 位置的是语法关,带表名列名的是语义关,Metastore 超时看元服务与分区规模。
调度层:任务提交了但一直是 ACCEPTED 状态——YARN 队列资源不足或队列配额用尽,看资源管理器页面,不是 SQL 的问题。
执行层:任务跑起来失败或奇慢——进入本教程的主场,EXPLAIN 与任务日志并读。
存储层:任务读写文件报错(副本缺失、文件不存在、NameNode 压力)——HDFS 层问题,但诱因常来自 Hive 侧(小文件过多、分区过碎)。
故障分层定位决策图
四类高频故障的完整复盘
内存溢出(Container 出 OOM)。先定位要内存的段:任务日志的栈里出现 HashTableSink 或 MapJoin 字样是广播表太大;出现聚合相关栈是 Map 端聚合哈希超限。修法按第 7.3 节顺序:收紧广播阈值、降低聚合哈希比例、最后加大容器。直接加内存是最后手段,因为它治标且挤占集群资源。
长尾与倾斜。YARN 页面看 Reduce 耗时分布,中位数与最大值差一个量级即倾斜;EXPLAIN ANALYZE 找出超大 actual rows 的键;第 6 章的治理表按类型选招(加盐两阶段、参数 skewjoin、头部键拆解走 MapJoin)。修完用同样的分布图验证。
小文件连锁。症状常伪装成"集群整体变慢":NameNode RPC 队列变长、任务启动变慢、扫描任务数暴涨。取证看表目录的文件数与平均大小(一条 HDFS 命令或 DESCRIBE 的统计),确认后按第 7.3 节两线治理:写入合并参数加存量重写。
结果不对(比慢更危险)。行数对不上、金额差一截、昨天的数今天变了。取证三步:先核对口径(是不是有人改了 DWS 的加工 SQL——查任务版本);再对账(源表与目标表按分区 COUNT 比对、抽样逐列比对);最后查脏数据(读时模式下,类型转换失败静默落 NULL,聚合时悄悄改变结果)。数据质量问题的修法多半不是技术而是流程:口径变更走评审、加工脚本进版本库、关键分层表挂行数对账任务。
趋势一:云原生与存储分离
Hive 的数据与计算本来就分离(HDFS 与 YARN),云原生只是把两者换成托管服务:存储换成对象存储(容量弹性、按量付费),计算换成容器化集群(按需扩缩)。变化里有得有失:对象存储的目录重命名不是原子操作,传统依赖"写临时目录再改名"的提交协议需要新机制(提交器适配)来保证写入库的正确性;延迟更高让小文件问题加倍致命;但存的成本曲线与算的弹性是实打实的收益。
趋势二:Serverless 化
云厂商把"Hive 兼容 SQL 加对象存储"做成按查询付费的服务:没有集群要管、没有容量要估,提交 SQL 按扫描量计费。这类服务的内核仍是 Hive 系的翻译器(或兼容方言的近亲),第 2 章到第 3 章的编译流水线知识原样适用——你优化 SQL 的方式不变(少扫数据、选好格式、分区裁剪),只是账单从集群成本变成了扫描字节数。格式与分区的决策在按量计费模式下更值钱:同样的查询,ORC 加分区能比 TextFile 全表扫便宜一个数量级。
趋势三:实时化与 ACID 增量
经典 Hive 的批处理基因(全量分区覆盖写)在实时性要求前显得笨重。演进分两支:一支是 Hive 自身的 ACID 能力(事务表支持行级更新删除、增量 INSERT,配合 compaction 机制维持读性能),让"小时级到分钟级"的增量加工成为可能;另一支是流批一体(Flink 写入、Hive 批读,或直接把表格式升级到 Iceberg 这类支持增量消费的湖格式)。判断哪支适合自己,标准仍是老三样:延迟要求、变更频率、团队栈。
趋势四:AI 训练的数据供给
大模型与机器学习平台需要海量结构化训练数据与特征,Hive 数仓天然是特征仓库:DWD 与特征表成为训练管道的输入端。工程重心从"人写 SQL"部分转向"特征管道自动化",但底层不变——特征表也是表,也要分区分桶选格式,训练取数也是扫描,第 7 章的优化逻辑照用。有趣的是,AI 反过来也在改变 SQL 的生产方式(自然语言生成 HQL),生成结果的质量校验反而更依赖本册的方法论:EXPLAIN 是机器生成的 SQL 的第一道安检。
翻译官的未来
技术演进很快,但本书讲的这条主线——SQL 进入 Driver,被翻译成分布式执行计划——在可见的演进里始终未变:引擎在换(MR 到 Tez 到云上托管),介质在换(HDFS 到对象存储到湖格式),但"写法决定计划、计划决定代价"的因果链不变。掌握读计划的能力,比记住任何一组参数都长寿。这是全册的最后一句话,也是第一句。
版本升级:另一种"故障"的预防
升级不是故障,但处理不当会制造全仓故障,值得在排错方法论里占一段。升级的工程要点压缩成四条:兼容清单先行——列出新版本移除的语法与默认值变化(例如独立索引语法的移除、默认执行引擎与默认参数的调整),扫描存量脚本逐项比对;灰度并行——新旧版本双跑一段时间,同一批任务两边各跑一次,结果表行数与关键指标对账;元数据库 schema 升级单独做——Hive 大版本常要求 Metastore schema 升级,先备份再执行升级脚本,失败可回滚;回退预案——明确哪个时间点之后不可回退(schema 升级并投产之后),之前如何切回。升级事故的第一原因从来不是新版本有缺陷,而是"没对账就全量切换"。
本节要点回顾
- 五层定位法:连接、编译、调度、执行、存储,先归层再取证,每层证据入口固定;
- 执行层四案:OOM 先定位内存段再收胃口、倾斜看分布定键、小文件看文件数与均值、结果不对先核口径再对账;
- 修法纪律:一次一个变量、改前留基线、事故复盘进手册;
- 云原生:存储分离红利与对象存储语义代价并存,提交协议与小文件是两大新课题;
- Serverless:翻译器逻辑不变,账单从集群成本变扫描字节,格式与分区决策更值钱;
- 实时与 AI:ACID 增量与流批一体解决时效,数仓成为特征仓库,EXPLAIN 成为机器生成 SQL 的安检口。