8.3 Metastore管理、监控与权限安全
8.3 Metastore 管理、监控与权限安全
本节摘要:Metastore 是整个生态的事实源,它的可用性决定数据资产的可访问性。本节对比三种部署形态的拓扑与适用场景、给出元数据备份的最低要求与分区治理命令、列出监控清单;安全侧讲认证(Kerberos 解决"你是谁")与授权(库表列级权限解决"你能干什么")的分层职责,以及脱敏与审计的工程做法。
从一次事故说起
一个真实感很强的场景:某团队 HiveServer2 重启后再也起不来,日志里 Metastore 连接超时。排查发现元数据库(MySQL)磁盘满了——一张大分区表的历史分区登记膨胀了几百万行,把元数据库撑爆。期间所有查询(哪怕不碰那张表)全部编译失败:语义分析要访问 Metastore,词典打不开,翻译官集体罢工。
这个事故说明 Metastore 运维的三个特点:故障全局性(不是单表不可用,是全仓不可用)、膨胀隐蔽性(数据在 HDFS 上没涨多少,元数据先炸)、恢复依赖备份(元数据库坏了,HDFS 上的数据就变成没有户口的黑户)。相应地,治理抓三件事:部署形态、备份恢复、容量监控。
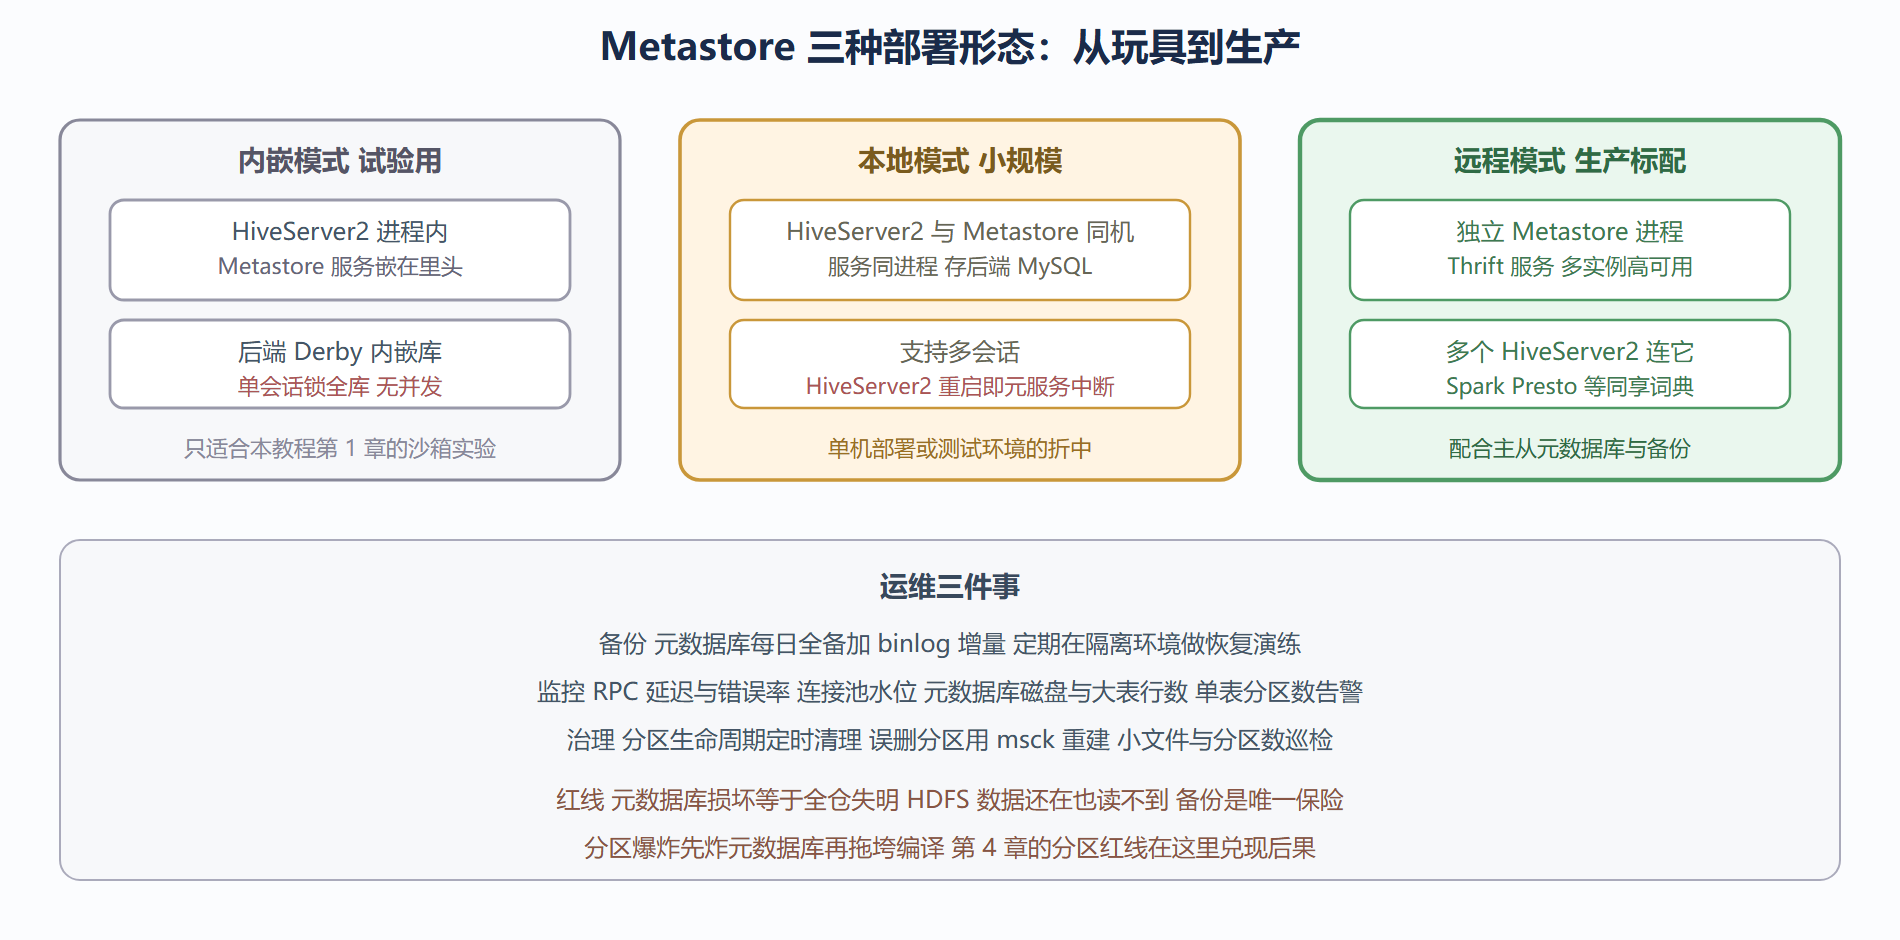
Metastore 三种部署形态对比
元数据的备份与修复
备份对象是元数据库(MySQL 等),手段是数据库层的老办法:每日全量 dump 加 binlog 增量,异地存放。比数据库备份更细的粒度是导出建表语句清单(SHOW CREATE TABLE 批量化脚本)存进版本库——日常巡检与灾后比对都方便。
恢复演练是备份的组成部分:季度性在隔离环境恢复一份数据库,IMPORT 几张表验证。没演练过的备份在文档上存在、在物理上存疑。
分区修复的两个高频命令:
-- 目录已存在但登记缺失时 扫描表目录重建分区登记 MSCK REPAIR TABLE mall.orders; -- 手工登记个别分区 ALTER TABLE mall.orders ADD PARTITION (dt = '2026-01-16');
MSCK 对大分区表很重(全目录扫描),分区多的时候按分区段手工登记或用上层数据湖工具做。反过来"登记在、目录没了"(数据被误删)MSCK 治不了,要回数据备份。
分区生命周期治理:过期分区定时 DROP(配合数据保留策略),一张表几万个历史分区不仅拖编译,还让元数据库膨胀——第 4 章的"分区数红线"在这里看到后果。归档策略常见的做法是热分区留在表内、冷分区 EXPORT 到归档存储后 DROP。
监控清单
按层列最值得盯的指标:
- 服务层:Metastore RPC 的延迟与错误率(对大分区表的 getPartitions 调用最重)、活跃连接数与线程池水位;
- 元数据库层:磁盘使用、慢查询、核心表(分区表、列统计表)行数增速;
- 对象层:单表分区数(超阈值告警)、表总数增速、无统计信息的表占比(CBO 健康度);
- 编译层:HiveServer2 日志里编译耗时分布(语义分析阶段异常拉长通常指向分区清单过大)。
这套清单不复杂,难的是把它接进告警并坚持响应。开篇那个元数据库磁盘打满的事故,任何一个"分区表行数增速"告警都能提前几周发现苗头。
安全:认证与授权分工
Hive 安全体系容易混淆的是两层职责,分开记:
认证(Authentication)回答"你是谁"。集群标准是 Kerberos:用户拿着票据证明身份,HiveServer2 与 Metastore 校验票据, impersonation(代理模式)让服务以真实用户身份向下传递(否则所有人到了 HDFS 层都变成同一个服务账号,存储层权限形同虚设)。没上 Kerberos 的内网环境,退化为用户名声明加操作系统层隔离,安全性有限但至少保住审计能力。
授权(Authorization)回答"你能干什么"。三套体系按演进排:
- 基于存储的授权(Storage Based Authorization):权限跟着 HDFS 目录走——目录能读写,表就能读写。实现简单,但只有库表粒度,列级管不了;
- SQL 标准授权(SQL Standard Based Authorization):GRANT 与 REVOKE 语法族,库表列粒度,贴近数据库习惯,但要防用户绕过 HiveServer2 直连,约束较多;
- Ranger 类集中式插件:策略中心统一管理(Hive 之外的 HDFS、YARN 一起管),支持行级过滤与列级脱敏(手机号对分析师只露后四位,对风控组全量可见),审计日志内置。生产大集群的主流选择。
-- SQL 标准授权的样子 GRANT SELECT ON TABLE dwd.order_detail TO ROLE analyst; REVOKE ALL ON TABLE ods.orders_log FROM ROLE analyst;
最小权限的落地版本就是第 8.1 节分层纪律的安全翻版:分析师角色对 ODS 无权限、对 DWD 只读、对 ADS 只读,写入权限只给调度账号。分层管住了"应该查哪层数据",授权管住了"能查哪层数据",两套纪律互相补台。
审计是安全的最后一块:谁在什么时候对哪张表执行了什么(尤其 DROP、ALTER 这类破坏性操作)。Ranger 类方案内置审计;轻量做法是开启 HiveServer2 的操作日志并集中收集,配合第 2 章提过的 AST 解析做高危语句告警(未带 WHERE 的全表 OVERWRITE、非白名单的 DROP TABLE)。
本节要点回顾
- 故障全局性:Metastore 不可用等于全仓失明,元数据库备份是数据资产的最后保险;
- 三形态递进:内嵌试验、本地小规模、远程生产标配加高可用与多引擎共享;
- 监控盯四层:RPC 健康、元数据库容量、对象规模(分区红线)、编译耗时;
- 修复两命令:MSCK 重建分区登记、手工 ADD PARTITION,登记与目录的两种脱节各有各的治法;
- 认证授权分工:Kerberos 管"你是谁",存储授权到 Ranger 类插件管"你能干什么",impersonation 保权限传导不失真;
- 分层即权限:ODS 封闭、DWD 只读、ADS 消费,最小权限与取数分层是同一套纪律的两面。