8.1 ODS到ADS:数仓分层建模实战
8.1 ODS 到 ADS:数仓分层建模实战
本节摘要:数仓分层把数据加工组织成职责清晰的流水线:贴源层保真、明细层规范、汇总层复用、应用层面向消费。本节用一套电商订单数据把四层表从建表语句到加工 SQL 完整走一遍,每一步都标注它用到了前面哪一章的决策,最后说明分层的收益边界与常见的"伪分层"反模式。
为什么需要分层
不分层的数仓长这样:三百张表各自为政,同一张原始日志被一百个需求各自清洗一遍;"活跃用户"有七种口径散落在不同脚本;某个上游字段改名,下游二十个任务一起报错。分层治的就是这三件事:重复加工、口径分裂、变更传导。
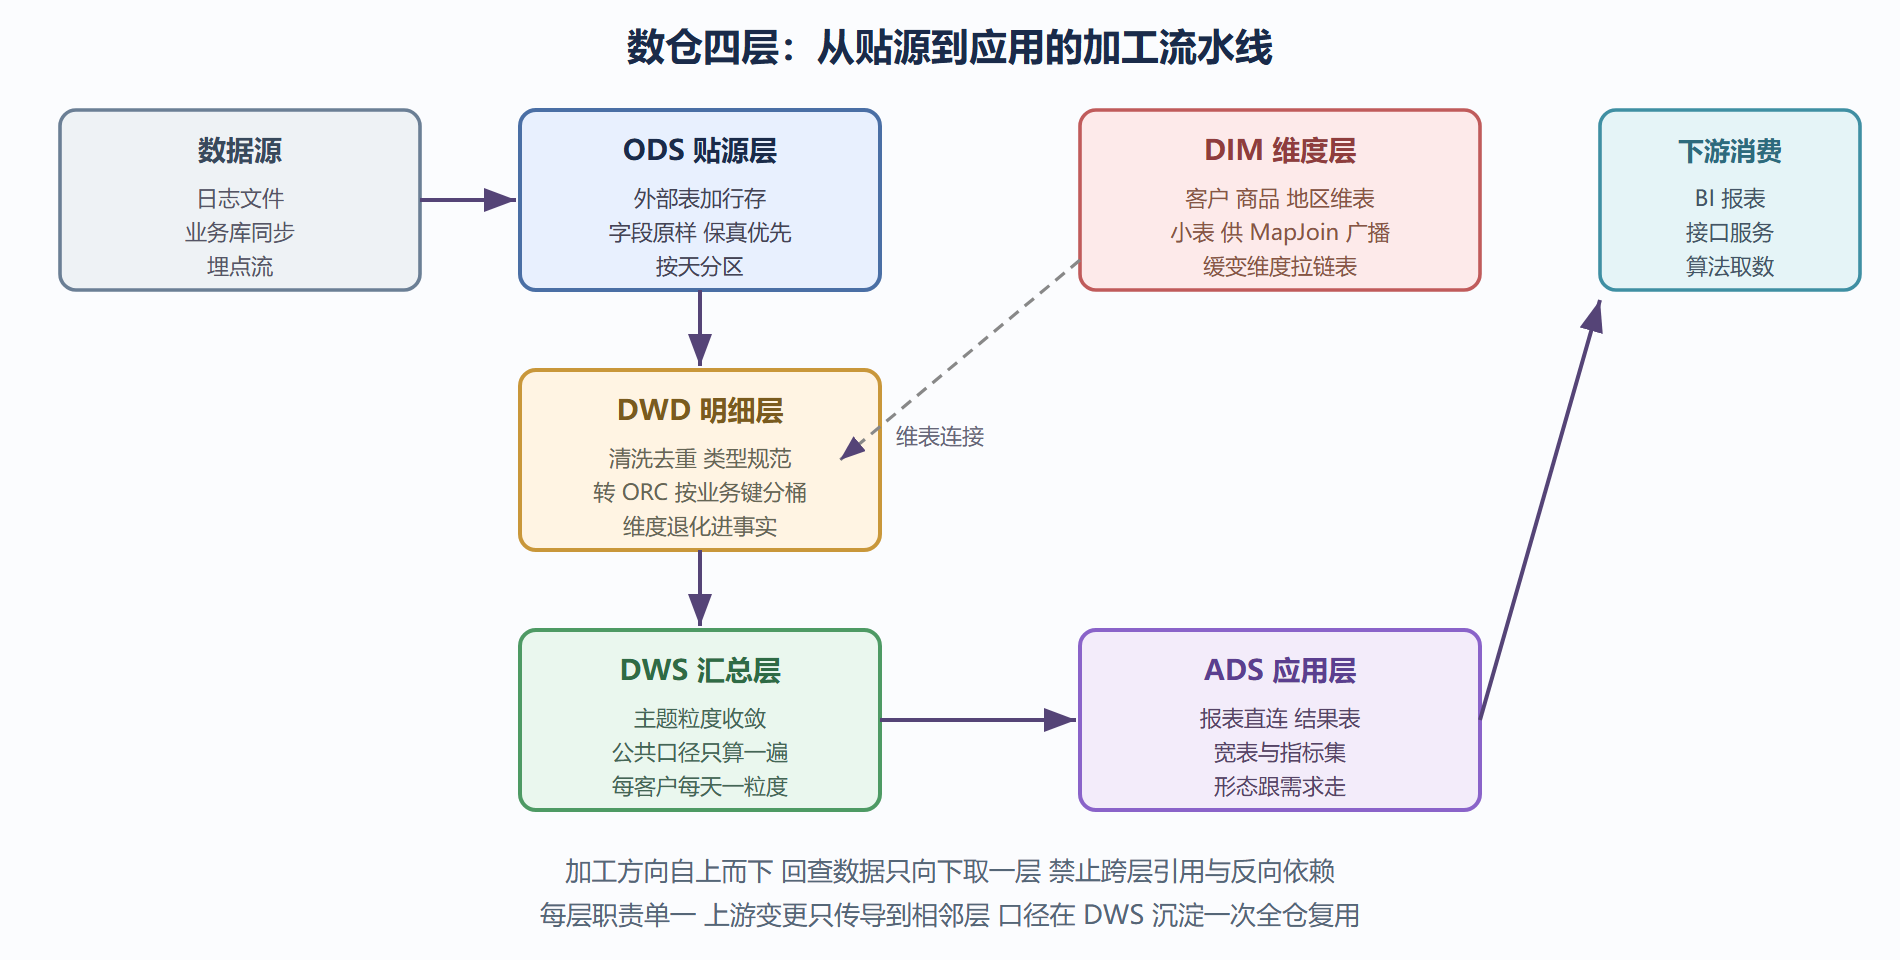
分层的标准四层与各自职责:
- ODS(贴源层):外部数据的原样落地,字段名与上游一致,不做业务加工;
- DWD(明细层):清洗、规范化、维度补齐后的明细事实,全仓统一口径的最细粒度;
- DWS(汇总层):按主题做的轻度汇总,沉淀公共口径(活跃用户、GMV 只算一遍);
- ADS(应用层):直接面向报表与接口的结果表,形态跟着需求走。
数仓四层架构与数据流转
把四层表建出来:电商订单实例
ODS:外部表,行存,贴源。
CREATE EXTERNAL TABLE ods.orders_log ( line STRING -- 整行先按 STRING 收 ) PARTITIONED BY (dt STRING) ROW FORMAT DELIMITED STORED AS TEXTFILE LOCATION '/data/raw/orders';
三个决策都有出处:EXTERNAL 因为数据由采集流程拥有(第 4.1 节所有权);TEXTFILE 因为上游就是文本、贴源不做转换(第 7.1 节"贴源行存明细列存");整行 STRING 因为脏数据要等 DWD 层再清洗(读时模式的纪律:可疑列先 STRING)。
DWD:清洗规范,ORC,按业务键分桶。
CREATE TABLE dwd.order_detail ( order_id BIGINT, customer_id STRING, region STRING, amount DECIMAL(12,2), pay_status TINYINT, created_at TIMESTAMP ) PARTITIONED BY (dt STRING) CLUSTERED BY (customer_id) SORTED BY (customer_id) INTO 32 BUCKETS STORED AS ORC TBLPROPERTIES ('orc.compress' = 'SNAPPY'); INSERT OVERWRITE TABLE dwd.order_detail PARTITION (dt) SELECT CAST(json_tuple(line, 'order_id') AS BIGINT) AS order_id, json_tuple(line, 'customer_id', 'amount') ... -- 解析与清洗展开 FROM ods.orders_log WHERE dt = '2026-01-16' AND line IS NOT NULL;
DWD 的工程要点:类型在这里定型(CAST 到目标类型,转换失败落 NULL 并记质量指标);重复数据在这里去重(按业务主键取最新);维度信息按"退化维度"策略带进事实(region 直接冗余存储,报表不必每次连维表);分桶键选最高频连接键 customer_id,为下游 SMB 与 MapJoin 铺路。
DWS:公共口径,主题汇总。
CREATE TABLE dws.customer_order_1d ( customer_id STRING, order_cnt BIGINT, pay_amt DECIMAL(14,2), last_pay_time TIMESTAMP ) PARTITIONED BY (dt STRING) STORED AS ORC; INSERT OVERWRITE TABLE dws.customer_order_1d PARTITION (dt = '2026-01-16') SELECT customer_id, COUNT(*) AS order_cnt, SUM(amount) AS pay_amt, MAX(created_at) FROM dwd.order_detail WHERE dt = '2026-01-16' AND pay_status = 1 GROUP BY customer_id;
"支付口径"(pay_status 等于 1)在这一层定义一次,全仓的 GMV、客单价都从这张表出发——口径分裂在源头终结。粒度选择是 DWS 的核心设计:每客户每天一行是通用甜点,再细回 DWD 取数,再粗(每月)可在 ADS 现算。
ADS:面向消费的最终形态。
CREATE TABLE ads.region_gmv_daily ( region STRING, gmv DECIMAL(16,2), buyers BIGINT, arpu DECIMAL(10,2) ) PARTITIONED BY (dt STRING) STORED AS ORC; INSERT OVERWRITE TABLE ads.region_gmv_daily PARTITION (dt = '2026-01-16') SELECT region, SUM(pay_amt) AS gmv, COUNT(*) AS buyers, SUM(pay_amt) / COUNT(*) AS arpu FROM dws.customer_order_1d a JOIN dim.region_dim b ON a.region_code = b.region_code WHERE a.dt = '2026-01-16' GROUP BY b.region;
ADS 表的形态跟着消费端走:BI 直连就做宽表,接口服务就做窄结果。加工 SQL 全部从相邻层取数——这条"只向下取一层"的纪律是分层的灵魂。
分层的收益边界与伪分层反模式
分层的收益是组织性的,不是性能性的——层数多了总计算量只增不减(每层都要读写一遍)。它换到的是口径统一、变更隔离、任务可复用。识别伪分层的三个特征:层名齐全但 ODS 直连 ADS(跨层引用,中间层形同虚设);DWS 每张表都为单个报表服务(汇总层没有沉淀公共口径,只是把 ADS 改了名);各层建表参数完全随缘(分层没有跟存储决策联动,格式分区分桶各层一样或完全无规律)。
健康的分层在元数据上一眼可辨:每层表的格式分区分桶呈现规律(ODS 外部行存、DWD 列存分桶、DWS 列存轻汇总),任务依赖图是干净的自上而下。
维度建模:事实表与维表的骨架
分层解决"数据放哪",维度建模解决"表内长什么样"。经典方法论一句话:事实表记事件,维表记描述。订单是一次事件,金额数量是事实度量;客户、商品、地区、时间是描述这次事件的维度。两种表的建表取向完全不同——事实表大而窄(行多列少、按天分区),维表小而宽(行少列多、全量或拉链存储)。
事实表按粒度选型:事务事实表一行一次原子事件(订单支付成功一行),周期快照事实表一行一个周期末状态(每客户每天余额一行),累积快照事实表一行一个流程的多个里程碑时间(下单、支付、发货、签收四个时间点在一行)。选错粒度是明细层最常见的返工原因:用事务表答"每个客户每天的累计消费"要窗口函数现场算,而周期快照一行就有答案。
维度的经典难题是缓慢变化维:客户从北方搬到南方,历史订单该算哪个地区?三种方案:直接覆盖(丢失历史,报表口径漂移)、加新行(历史保留但维表膨胀)、拉链表(每行带生效与失效时间区间,任意历史时点的维度状态可还原):
CREATE TABLE dim.customer_zipper ( customer_id STRING, region STRING, vip_level TINYINT, start_dt STRING, -- 生效日 end_dt STRING -- 失效日 当前行用极大值占位 ) STORED AS ORC; -- 事实表按事件日期关联正确时点的维度状态 SELECT o.order_id, z.region FROM dwd.order_detail o JOIN dim.customer_zipper z ON o.customer_id = z.customer_id AND o.dt >= z.start_dt AND o.dt < z.end_dt WHERE o.dt = '2026-01-16';
拉链表的区间连接写法正好用到第 6 章的知识:不等值条件推不动下推,关联前先按 customer_id 收窄。这也是"建模决策影响查询写法、查询写法影响执行计划"的又一个例证——数仓工程里,三层因果始终环环相扣。
一天的数据旅程:分层时间线
把静态分层放到一天的时间轴上看更有体感。凌晨零点过后:采集层把昨天的日志与同步数据落进 ODS 目录,调度系统检测到分区就绪触发校验任务(行数与昨天同量级、关键字段空值率);一点整:DWD 清洗任务按分区 OVERWRITE 写入,尾部追加 ANALYZE 刷新分区统计;两点半:DWS 主题汇总跑批,公共口径表先落,依赖它的专题表随后;四点:ADS 各报表结果表就绪,BI 的定时刷新把数据抽走;早九点:分析师上班,在 DWS 上做即席查询,BI 用户看 ADS 报表;白天:新到的小批量数据留在暂存区,等下一个批处理窗口。分层的本质是把一天的数据加工切成有依赖顺序的接力,每一棒的输入输出与口径都有据可查。
本节要点回顾
- 分层治什么:重复加工、口径分裂、变更传导——组织性收益而非性能收益;
- 四层职责:贴源保真、明细定型、汇总沉淀口径、应用面向消费;
- 决策联动:ODS 外部表行存、DWD ORC 加分桶、DWS 粒度收敛、ADS 形态随需求——每层选择都来自前几章的工程决策;
- 退化维度:高频维度信息冗余进事实,报表免连维表;
- 只向下取一层:依赖纪律是分层灵魂,跨层引用是伪分层的第一特征;
- 口径在 DWS 沉淀:公共指标只算一遍,GMV 与活跃用户不再各自为政。