8.2 与Hadoop生态及BI工具集成
8.2 与 Hadoop 生态及 BI 工具集成
本节摘要:Hive 很少单独作战。数据从采集组件(Flume、Kafka、Sqoop 或 DataX 类工具)进入 HDFS,经 Hive 加工成数仓,被 Spark、Presto 类引擎与 BI 工具消费,由调度系统串联成管道。本节画清这张生态地图,讲 HiveServer2 对 BI 的 JDBC 服务模式、跨引擎共享 Metastore 的意义与边界。
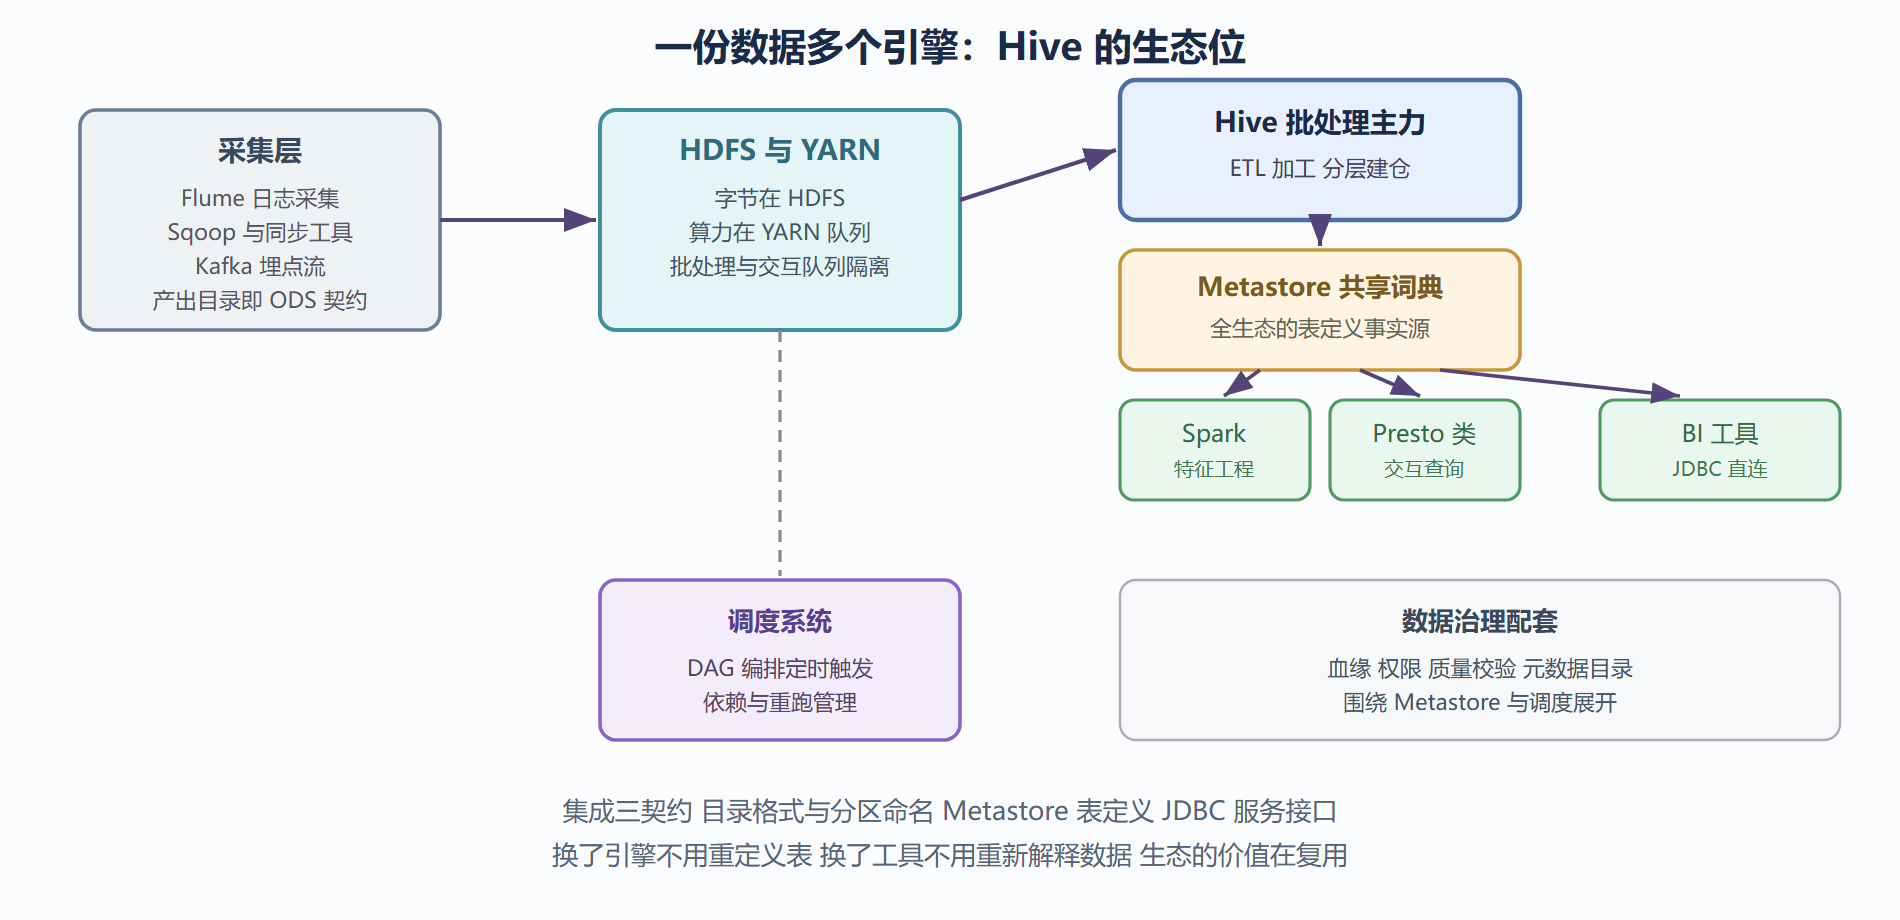
一张生态地图
把第 8.1 节的分层放到组件层面看,一条数据的完整旅程大致经过四段:
采集段:Flume 把日志 tail 进 HDFS 目录;Sqoop 或 DataX 类工具在业务库与 HDFS 之间搬运;Kafka 承接埋点流再由消费者落盘(或直接对接流式入库)。这一段对 Hive 是"上游供应商"——ODS 外部表的 LOCATION 指向它们产出的目录,Hive 与采集层的契约就是目录格式与分区命名。
存储与资源段:HDFS 存字节、YARN 管算力,这是第 1 章讲过的地基。要补充的是队列治理:Hive 的批处理作业、交互式查询、AdHoc 探索应该进不同 YARN 队列,配额隔离防止一个失控查询把全集群资源占满——平台侧的基础纪律。
计算段:Hive 是主力批处理引擎,但不是唯一消费者。Spark 读同一份 Hive 表做机器学习特征工程;Presto 或 Trino 类引擎对同一份 Metastore 做交互式查询;Flink 处理流的部分与 Hive 批处理形成流批协同。同一份数据、同一份元数据、多个计算引擎——这是 Hadoop 生态相对单体数据库的根本差异。
消费段:BI 工具(Tableau、FineBI、Superset 等任意 JDBC 客户端)连 HiveServer2 取数出报表;接口服务从 ADS 层读结果;算法团队从特征表取训练数据。
Hive 在生态中的位置
Metastore 共享:生态的合同本
第 1 章说过 Metastore 是 Hive 的词典,生态视角下它的地位更高:它是全生态的表定义事实源。Spark 的 spark.sql 模式、Presto 的 Hive connector,都通过连接同一个 Metastore 识别"Hive 里有哪些表、什么格式、怎么读"。一份表定义、多个执行引擎,这才有了"用 Hive 建仓、用 Presto 查询、用 Spark 炼特征"的分工组合,而不必为每个引擎复制一份数据。
共享也带来纪律:Metastore 的可用性从"Hive 的单点"升级成"全生态的单点"(下一节的高可用与备份因此更关键);元数据变更(改表、加分区)要考虑所有消费引擎的兼容性;表格式选择要照顾最弱的读者(比如某引擎对复杂嵌套类型支持不全,DWD 建表就少用 MAP 套 STRUCT)。
BI 集成:JDBC 服务模式与取数分层
BI 工具连 Hive 的标准通道是 HiveServer2 的 JDBC 端口,与第 1 章的架构呼应:BI 工具就是一个普通 Client。工程要点四条:
连接隔离:BI 并发查询与批处理 ETL 走不同的 HiveServer2 实例或至少不同 YARN 队列,防止白天看报表与夜间跑批互相践踏。
取数分层:BI 直连 ODS 或 DWD 是性能事故的常见源头——报表查询动辄扫明细层几亿行。规范是 BI 只允许连 ADS(必要时 DWS),明细探查走受控的 AdHoc 队列。这把第 8.1 节的分层纪律从"任务依赖"延伸到了"消费权限"。
交互延迟管理:传统 MR 引擎下首屏几十秒的报表体验很差;Tez 加 LLAP(或 Presto 类引擎前置)是标准解法——第 7.2 节的 LLAP 队列正是为 BI 场景准备的。BI 查询路由到 LLAP 队列、批处理留在普通队列,是平台层的常见配置。
结果集与缓存:BI 工具侧的抽取缓存(把 ADS 结果抽到工具自己的内存或加速库)与 Hive 侧的物化视图(第 4.4 节)都能削峰,选哪层做缓存看团队能力:平台强就 Hive 侧统一做,工具自治就 BI 侧各自做。
调度与管道:把分层串成流水线
第 8.1 节的层间加工不会自己跑,调度系统(DolphinScheduler、Airflow 类)负责按依赖编排:ODS 分区就绪触发 DWD 任务,DWD 完成触发 DWS,依此到 ADS。与 Hive 相关的三个工程点:任务用 Beeline 提交 SQL 脚本,脚本头部带 SET 参数块(第 7.3 节的脚本级参数);幂等设计靠 INSERT OVERWRITE 加分区粒度重跑(第 5.1 节);失败告警与重跑策略围绕分区依赖展开,数据回补时按分区倒序重放。
血缘是调度的伴生品:任务依赖图加 SQL 解析(第 2 章讲过 AST 遍历是血缘工具的底层)合成表级与列级血缘,变更影响分析(改这张表,哪些下游要跟着动)就从拍脑袋变成查图。
集成决策速查
| 需求 | 方案 | 注意 |
|---|---|---|
| 日志进仓 | Flume 或同步工具落目录 ODS 外部表挂 LOCATION | 目录命名与分区规范是契约 |
| 报表查询 | BI 连 HiveServer2 走 ADS 层 | 队列隔离 延迟敏感上 LLAP |
| 交互式即席查询 | Presto 类引擎共享 Metastore | 引擎方言差异 小心上推行为不同 |
| 机器学习特征 | Spark 读 DWD 或特征表 | 特征表单独分层管理回溯 |
| 管道编排 | 调度系统按分区依赖触发 | OVERWRITE 幂等 血缘登记 |
跨引擎协作的方言陷阱
多个引擎读同一份 Metastore 很美好,但 SQL 方言并不因为共享元数据就自动统一。跨引擎混用时的三类高频差异要在心里有数:
语法差异。各引擎的窗口函数、日期函数、字符串函数命名与参数不完全一致(Hive 的日期加减与 Presto 类引擎的写法就不同);隐式类型转换规则也有出入——同一条 SQL 在两个引擎里一个正常一个报错,先查方言表再怀疑数据。团队约定"加工层用哪个引擎就统一用哪个",消费端查询才允许混合。
优化器行为差异。同一查询在不同引擎的谓词下推、分区裁剪实现程度不同,Hive 里验证过的优化写法(比如分区列裸列比较)换引擎后仍有效,但涉及函数包裹的写法可能在一边被推下去另一边推不下去。跨引擎的关键查询,两边各跑一次 EXPLAIN 对比路径,是稳妥习惯。
事务与格式支持差异。Hive 的 ACID 事务表只有 Hive 自家生态读写顺畅,其他引擎读它会受限;ORC 的某些表属性(如布隆过滤器列)各引擎利用程度不同。表格式是跨引擎的最大公约数——选 ORC 或 Parquet 这类开放格式、少用引擎私有特性,生态混用的自由度就大。
这三条差异共同指向同一个工程结论:共享的是数据与元数据,不是行为。把"哪些层用哪个引擎、哪些写法允许混用"写成团队规范,比依赖每个开发者的自觉可靠得多。
本节要点回顾
- 四段旅程:采集落目录、HDFS 存字节、多引擎计算、BI 与服务消费,Hive 是批处理主力不是唯一角色;
- Metastore 是合同本:一份表定义多个引擎复用,可用性与变更兼容升级为生态级问题;
- BI 纪律:只连 ADS 或 DWS、与批处理队列隔离、延迟敏感路由 LLAP;
- 调度三件套:脚本级参数块、OVERWRITE 幂等重跑、分区依赖触发;
- 血缘来自 AST:依赖图加 SQL 解析,变更影响分析从拍脑袋变查图;
- 集成本质是契约:目录规范、表定义、JDBC 接口三样稳,生态就稳。