2.1 列表与元组:可变与不可变
2.1 列表与元组:可变与不可变
本节摘要:list 是可变序列,tuple 是不可变序列。本节从 CPython 的内存布局讲两者的真实差异:list 的过度分配策略让 append 均摊 O(1)、但始终比 tuple 更占内存;tuple 因不可变而可哈希、可作字典键、可被解释器常量化。选型从此有据可依。
一个成本问题开场
同一万个元素,装进 list 和装进 tuple,谁更省内存?空口无凭,直接测:
>>> import sys >>> lst = [i for i in range(1000)] >>> tup = tuple(range(1000)) >>> sys.getsizeof(lst), sys.getsizeof(tup) (8056, 8040)
数量级差别不大,但再看看"追加一千次"与"一次建好"的对比,以及空容器:
>>> grown = [] >>> for i in range(1000): grown.append(i) >>> sys.getsizeof(grown) 9016 # 追加式增长,多花了约 12% >>> sys.getsizeof([]), sys.getsizeof(()) (56, 40)
空 tuple 比 list 少 16 字节。这 16 字节是什么?是 list 对象头里多出来的两个字段:当前长度与分配容量。这个差异直指两种容器的本质分歧。
list 的内存布局:过度分配
list 底层是一个指针数组(回忆 1.2 节:元素是指向各自 PyObject 的指针,而非值本身)。append 时若容量已满,CPython 按"增长序列"重新申请更大的数组,并故意多要一点,摊薄后续 append 的搬连性能:
>>> data = [] >>> sizes = [] >>> for i in range(12): ... data.append(i) ... sizes.append(sys.getsizeof(data)) >>> sizes [88, 88, 88, 88, 88, 120, 120, 120, 152, 152, 184, 184]
观察容量跳变的节奏:不是每次翻倍,而是按约 1.125 倍的渐进序列增长。这就是"均摊 O(1)"的来源——偶发的扩容搬运转嫁给平时的小额冗余。
列表内存布局与扩容
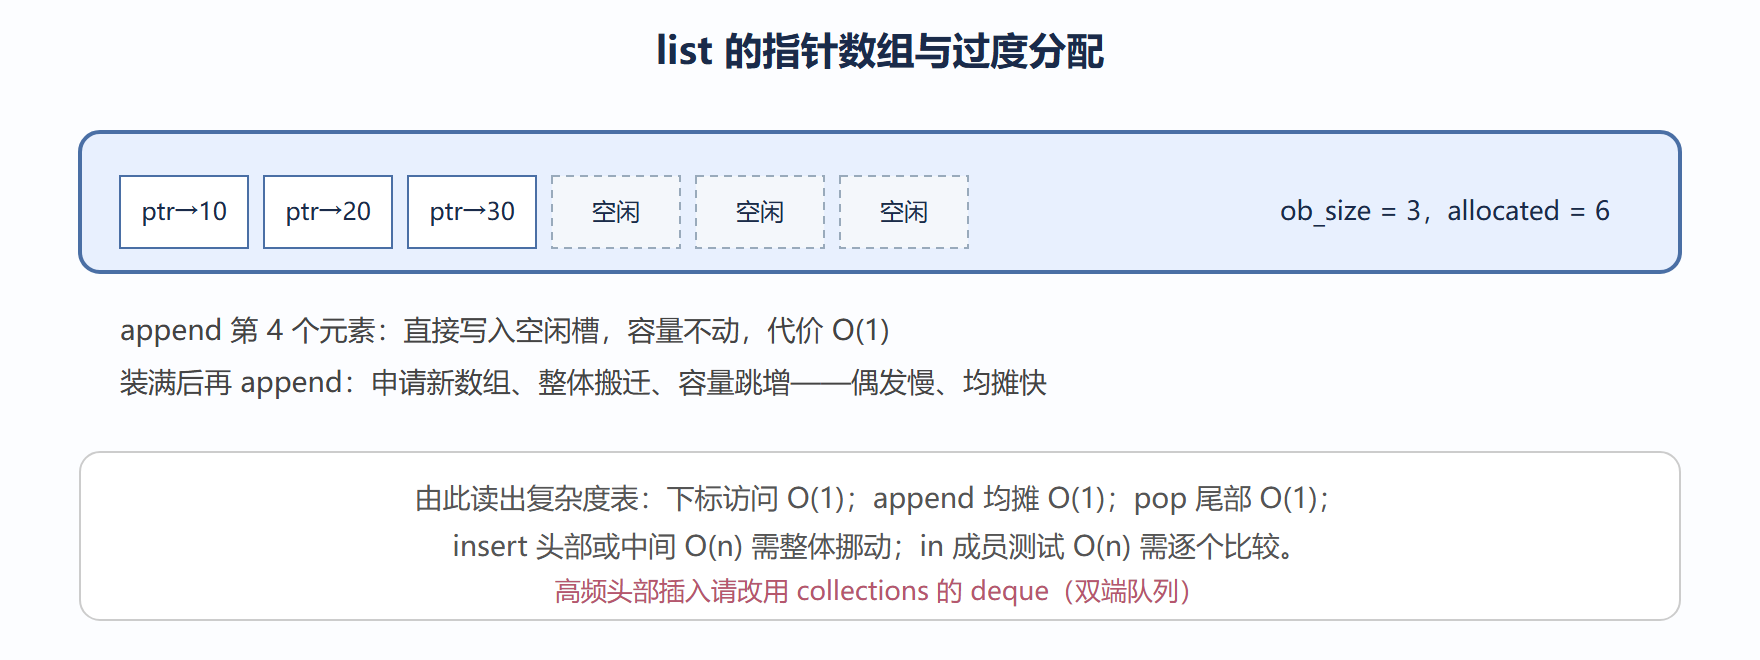
对应到操作选型上:
| 操作 | list | 说明 |
|---|---|---|
x[i] 取值 |
O(1) | 指针数组直接寻址 |
x.append(v) |
均摊 O(1) | 靠过度分配 |
x.insert(0, v) |
O(n) | 全体后移 |
v in x |
O(n) | 线性扫描,没有索引可走 |
sorted(x) |
O(n log n) | 混合排序(Timsort) |
在百万级 list 上做 in 测试,你会明显感到吃力——那是第 2.2 节集合与字典登场的前奏。
tuple:不可变不是缺德,是承诺
tuple 省掉的容量字段从何而来?因为它永不改变长度,无需扩容策略。但"不可变"要精确理解——是 tuple 的结构不可变,不是元素对象不可变:
>>> t = (1, [2, 3]) >>> t[1].append(4) # 完全合法!改的是内层 list 对象 >>> t (1, [2, 3, 4]) >>> t[0] = 9 # 这才被禁止 Traceback (most recent call last): File "<stdin>", line 1, in <module> TypeError: 'tuple' object does not support item assignment
包含 list 的 tuple 因此不可哈希:
>>> hash(t) TypeError: unhashable type: 'list'
哈希的要求是"内容不变则哈希不变"。tuple 只保证自己对直接元素的身份不变;若元素本身可变,哈希就失去意义,解释器诚实地拒绝。要当字典键,用全不可变的 tuple(或 frozenset)。
tuple 的两个隐藏红利:
- 常量折叠:全由常量组成的 tuple 会被编译期整体缓存,
dis里可见;list 则每次运行时重建。 - 放心共享:不可变对象可以无脑到处传,不用担心谁改了它——这就是函数返回多个值用 tuple 的深层理由(表层语法只是逗号)。
>>> def min_max(nums): ... return min(nums), max(nums) # 打包成 tuple >>> lo, hi = min_max([3, 1, 4, 1, 5]) # 解包 >>> lo, hi (1, 5)
解包还支持星号收集:first, *rest = nums——第 3 章会看到它的函数参数版本。
什么时候用谁
我的经验法则:默认 list,只在"表达固定结构"时用 tuple。典型场景:
- 函数多返回值、多变量交换
a, b = b, a; - 字典键(坐标、日期三件套这类复合键);
- 想向调用方传递"这组数据不该被改"的意图(软约束,内层可变对象仍需自己保证)。
反过来,把"恰好不用修改"的普通数据序列写成 tuple 并没有性能红利——遍历与下标访问两者同价,差异只在创建与内存冗余。为了"快"而用 tuple 多半是误传。
⚠️ 常见坑三连:其一,单元素 tuple 必须带逗号
(1,),(1)只是个括号表达式;其二,tuple(x)与x[:]都是浅拷贝,嵌套结构照旧共享;其三,循环中用+=拼接 list 是 O(n²) 反模式,改成收集后extend或用推导式。
💡 关键直觉:list 是"正在施工的数组",tuple 是"浇筑完成的记录"。选哪个,取决于你希望这段数据是过程还是事实。
深挖:sort 与 sorted 的稳定性
排序值得多看两眼。内置的 sorted 函数与列表的 sort 方法都采用 Timsort——一种混合归并排序,最坏 O(n log n)、最好 O(n)(对近乎有序的序列线性扫过),并且稳定:相等元素的相对次序保持不变。稳定性不是学术洁癖,它是多级排序的实现基石。想先按部门再按薪资排,只需反过来排序两次:先按薪资排,再按部门排稳定排序,同部门内部的薪资次序就自动保留了下来。另一个常被忽略的参数是 key:它对每个元素只调用一次(不像 cmp 风格的接口每次比较都回调),传函数比传 lambda 略快,而 operator 模块的 itemgetter 与 attrgetter 又比手写 lambda 更快更省——这些微优化在万级以上列表里能看出差别,小数据则无所谓。反转排序用 reverse=True 而不是先排再切片倒置,前者省一次完整拷贝。
本节要点回顾
- 内存差异实证:
sys.getsizeof显示 list 比 tuple 多出容量字段;append 式增长再多付一成冗余。 - 过度分配:容量按约 1.125 倍渐进扩张,append 均摊 O(1)。
- 复杂度速查:下标 O(1)、头部插入 O(n)、
inO(n);高频成员测试留给 set。 - 不可变的准确含义:tuple 结构不可变;内含可变对象时既不能防修改、也不可哈希。
- tuple 红利:常量折叠缓存、可作字典键、共享无风险。
- 选型法则:过程用 list,事实用 tuple;为性能而 tuple 是迷信。
下一节把"可哈希"这条线索变成主角——dict 如何用一次哈希把查找做到常数级。