2.2 字典与集合:哈希的力量
2.2 字典与集合:哈希的力量
本节摘要:dict 是 Python 最重要的数据结构——连对象属性、模块命名空间、函数默认值都存在 dict 里。本节拆开它的开放寻址哈希表,解释键为什么必须可哈希、扩容何时发生、3.7 之后插入有序的由来;set 则是"只存键的 dict"。读完你能解释 dict 查找为何是 O(1)。
先感受一次量级差
十万个整数,判断一个数在不在里面。list 与 set 的对比:
>>> import timeit >>> setup = "data = list(range(100_000)); s = set(data); import random; x = random.randrange(100_000)" >>> timeit.timeit("x in data", setup, number=10_000) 1.83 # list:线性扫描 >>> timeit.timeit("x in s", setup, number=10_000) 0.0021 # set:哈希直达,快了近千倍
千倍差距不是算法玄学,而是结构使然:list 只能挨个问,set 走一次哈希。dict 的键查找同理。能用 dict/set 的成员测试,永远别用 list 的 in——这是 Python 性能优化里性价比最高的一条。
开放寻址:一次查找的旅程
dict 底层是一张稀疏数组,学名叫哈希表。查找 d[key] 的完整旅程:
- 对 key 调用
hash(key),得到一个大整数; - 取模(实际是取低位掩码)定位到数组的某个槽位;
- 若该槽的键与目标相等(先比哈希、再比
==),命中; - 若不等,按探测序列找下一个槽,直到命中或遇到空槽(不存在)。
哈希表结构示意
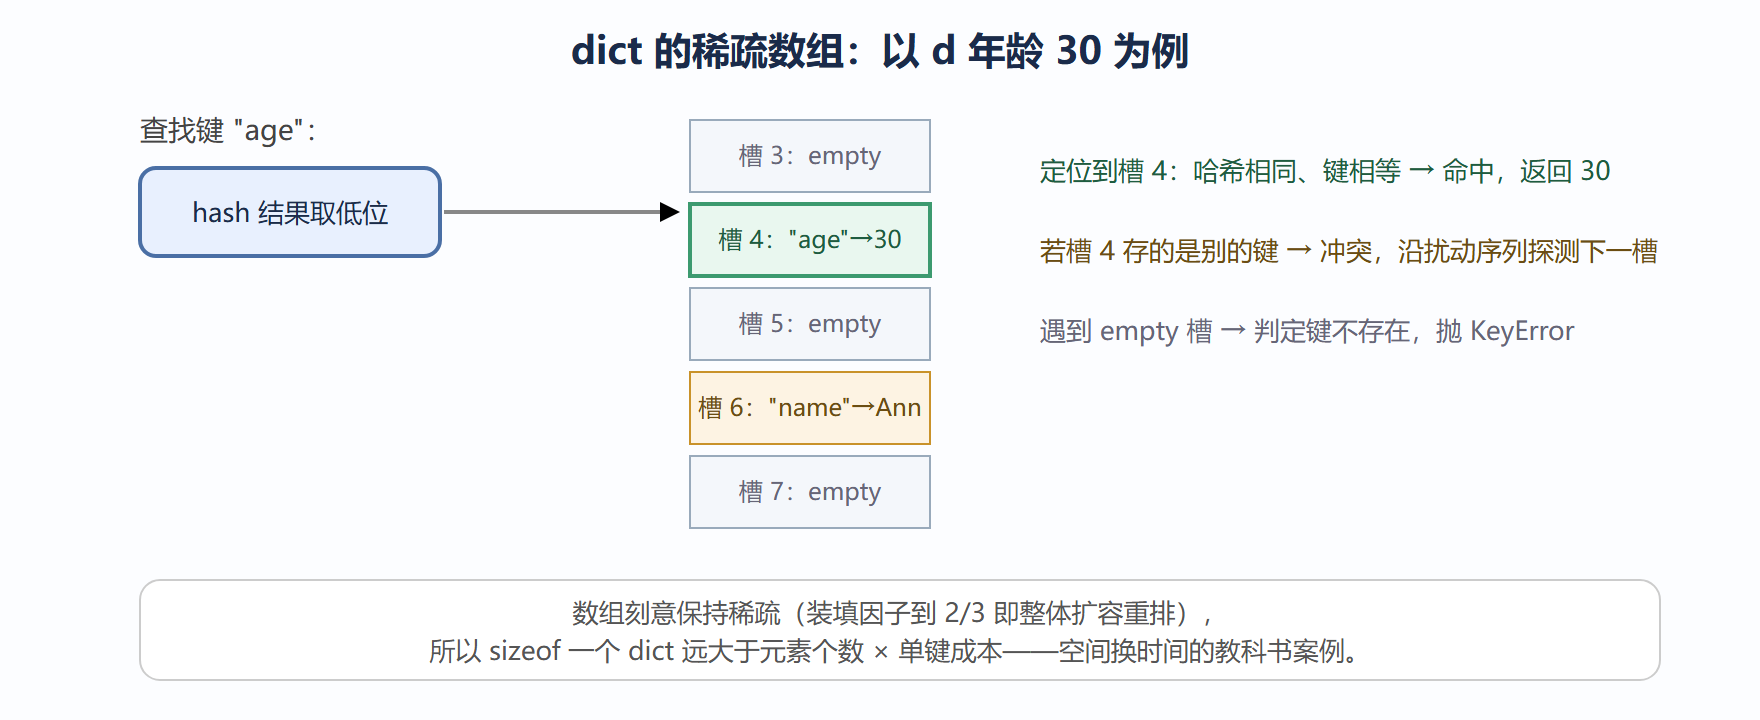
扩容时机可以实证。dict 装到三分之二满时触发重新分配:
>>> d = {} >>> marks = [] >>> for i in range(6): ... d[i] = i ... marks.append(sys.getsizeof(d)) >>> marks [64, 64, 184, 184, 184, 184] # 第 3 个元素触发扩容跳变
键的两条铁律
规则一:键必须可哈希。即类型实现了 __hash__ 且哈希在生命周期内不变。str、int、float、bool、tuple(全不可变元素)、frozenset 天然合格;list、dict、set 被明确禁用:
>>> {[1, 2]: "x"} TypeError: unhashable type: 'list'
规则二:相等的对象哈希必须相等。这是 1 == 1.0 == True 导致它们在 dict 里挤占同一个键的根源:
>>> d = {1: "int", True: "bool"} # True 与 1 相等,覆盖了 >>> d {1: 'bool'} >>> len(d) 1
自定义类默认可哈希(按身份),一旦你重写了 __eq__ 而不重写 __hash__,解释器会把 __hash__ 置为 None——类的实例立刻不可哈希。想让"值相等的两个实例"在 dict 中算同一个键,需要同时实现这两个方法,第 4 章会给出完整例子。
插入有序:一个被"转正"的实现细节
Python 3.7 起,dict 保证按插入顺序迭代。这不是新增排序逻辑,而是 3.6 重构哈希表的副产品:键值对本身存进紧凑的有序数组,稀疏数组里只放索引。红利是内存省了 20%–25%,顺序也自然保留:
>>> d = {} >>> for k in ["zebra", "apple", "mango"]: ... d[k] = k.upper() >>> list(d) ['zebra', 'apple', 'mango'] # 插入序,不是字母序
注意"有序"指插入序,与排序无关;要排序输出用 sorted(d) 或 dict(sorted(d.items()))。
set:只有键的 dict,外加集合代数
set 的底层与 dict 的键表同构,因此查找同样 O(1)、元素同样必须可哈希、同样无序(set 的插入序没有保证,3.7 的承诺只给了 dict)。它真正的加分项是集合运算:
>>> admins = {"ann", "bob", "cy"} >>> online = {"bob", "cy", "dee", "eve"} >>> admins & online # 交集:在线的管理员 {'bob', 'cy'} >>> online - admins # 差集:在线的普通用户 {'dee', 'eve'} >>> admins | online # 并集 {'ann', 'bob', 'cy', 'dee', 'eve'} >>> admins ^ online # 对称差:恰好在一方 {'ann', 'dee', 'eve'}
两个实战习惯值得固化:去重保序用 dict.fromkeys(纯 set 去重会丢顺序);海量成员测试一律先转 set:
>>> tags = ["py", "web", "py", "ai", "web"] >>> list(dict.fromkeys(tags)) # 去重且保留首现顺序 ['py', 'web', 'ai']
还有个易被忽略的细节:空集合只能写 set(),因为 {} 造的是空 dict。frozenset 则是不可变版本,可哈希、可作字典键或放进另一个 set——配置表、常量组常用它。
容器选型速查
| 需求 | 用什么 | 理由 |
|---|---|---|
| 按下标随机访问、动态增删尾 | list | 指针数组 + 过度分配 |
| 固定结构记录、复合键 | tuple | 不可变、可哈希、轻 |
| 键值映射、属性表 | dict | O(1) 查找、插入有序 |
| 去重、成员测试、集合关系 | set | 哈希直达 + 集合代数 |
| 键值对不允许被改 | MappingProxyType 包装 | 只读视图 |
⚠️ 常见坑:遍历 dict/set 时原地增删元素会抛
RuntimeError: dictionary changed size during iteration——先收集再改(for k in list(d): ...),或用推导式造新容器。另一个坑是拿浮点数当键:计算误差让 0.1+0.2 与 0.3 不相等,键就对不上。
💡 关键直觉:dict/set 的 O(1) 不是免费的——代价是稀疏数组的空间、键的哈希约束、和无序(set)。当数据小到几十个元素时,list 的简单直接反而更快;哈希结构的收益在千级以上才显著。
深挖:dict 的视图对象与成员关系
字典的 keys、values、items 三个方法返回的不是拷贝,而是视图对象——窗口式地照着底层哈希表,字典变了视图跟着变。验证它只要两行:先取一个键视图,随后向字典添加新键,视图的长度自动更新。视图还各自带技能:键视图与项视图是类集合的,支持交并差运算,两个字典找共同键可以 d1.keys() & d2.keys() 一步完成,不必物化成 set。值的视图没有这个待遇——值可能重复、可能不可哈希,集合运算无从谈起。成员测试 k in d 直接查哈希表,是 O(1) 操作;v in d.values() 则要线性扫描,两者性能差着数量级。日常重构里有一个用好视图的模式:删除满足条件的键时,先收集再删(比如用推导式过滤键视图造出新字典替换旧的),比边遍历边删安全得多——第 3 章讲过的迭代期变更问题,在字典上同样成立。
本节要点回顾
- 查找旅程:hash → 取位定槽 → 相等判定 → 冲突沿扰动序列探测。
- 两条铁律:键必须可哈希;相等对象哈希必须相等(1/True 同键的根源)。
- 扩容时机:装填到 2/3 触发跳变,
getsizeof可实证。 - 插入有序:3.7 起的正式承诺,源自 3.6 紧凑数组的副产品。
- set 三件套:与 dict 键表同构、集合代数运算、无序但可去重(保序用
dict.fromkeys)。 - 选型口诀:映射用 dict、判存在用 set、顺序结构用序列、常量组用 frozenset。
下一节讲最后一种内置容器——字符串:它为什么坚持不可变,以及 f-string 背后的格式化全景。