3.3 数据类型与 XML Schema
3.3 数据类型与 XML Schema
本节摘要:XPath 1.0 只有四种数据类型:节点集、布尔、数字、字符串。2.0 引入原子类型体系,并可在有 XML Schema 时把
price当成 xs:decimal 而不是文本。没有 Schema 的文档,比较价格仍要number()。本节合并原文 3.4 与 3.5,动手结论优先:先问文档有没有类型注解,再决定表达式怎么写。
你能学到什么
阅读完本节,你应当能够:
- 说出 1.0 四类型以及隐式转换何时发生
- 列举 2.0 常用原子类型:字符串、小数、日期、布尔
- 说明 Schema 如何让元素「带着类型」进入数据模型
- 在无 Schema 时继续用第 2 章的 number/string 纪律
一、同一句 price>35,有无 Schema 两套故事
无 Schema、1.0:price 是元素节点,比较时取字符串值再试着转数。成功则比,失败则假。
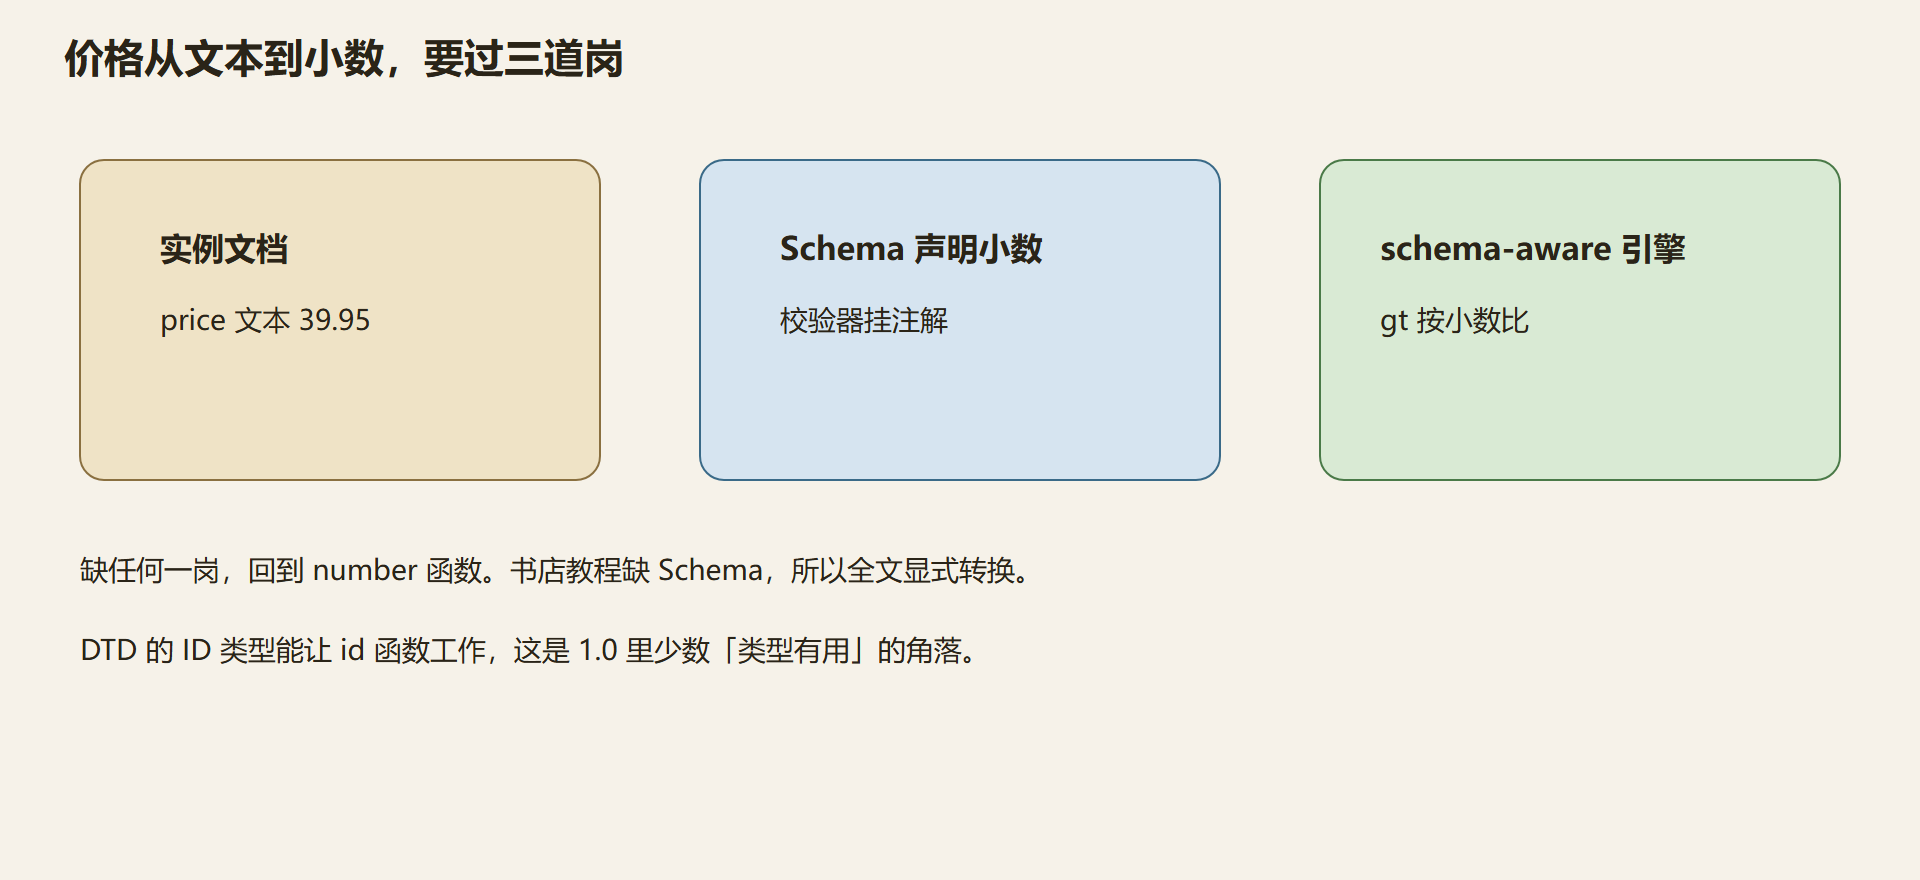
有 Schema 把 price 声明为 xs:decimal,2.0 数据模型里该元素的类型注解就是小数,price gt 35 按数值比,不必 number()。这是 Schema 对 XPath 最直接的好处:少一次「这到底是不是数」的心智税。
书店样本贯穿全文都没有 Schema。所以本教程正文比较一律写 number(price)。你若维护已校验的行业 XML(发票、药监),查 Schema 里字段类型,再决定能否丢掉 number。
二、1.0 四类型 vs 2.0 原子类型
| 场景 | 无 Schema 1.0 | 有 Schema 2.0 |
|---|---|---|
| 价格比较 | number(price)>35 |
price gt 35 若注解为小数 |
| 日期比较 | 当字符串或拆年 | xs:date 比较 |
| 布尔字段 | 非空串即真 | xs:boolean |
| 求和 | sum(price) 转数 |
按类型求和,脏值更早失败 |
| 错误表现 | NaN 静默 | 类型错误可显式 |
原文集 3.4 把 2.0 类型树铺得很开:xs:string、xs:boolean、xs:decimal、xs:float、xs:double、xs:dateTime 等,还有 untypedAtomic——无 Schema 时节点拍扁后的类型,比较规则接近 1.0 的宽松转换。
Schema 本身不是 XPath 的一部分。它是一份描述「什么元素能出现、类型是什么」的文档。校验器先按 Schema 检查实例,再把类型注解挂到树上。XPath 2.0 引擎若开启 schema-aware,才能看见这些注解。很多轻量引擎不 schema-aware,即使你有 Schema 文件,路径里仍然全是 untypedAtomic。
⚠️ 常见坑:以为放了 Schema 文件在旁边,lxml 的 xpath 就会按小数比较。lxml 不走这条链路。Schema 文件对它主要是校验,不是 XPath 类型注解。
💡 关键直觉:类型是引擎给节点贴的第二张标签。没贴,你就自己 number();贴了,才能少写转换。
图:三层,谁给价格贴类型
三、和 XPath 相关的 Schema 点
Schema 能定义 ID 类型属性,于是 id() 可用。也能定义枚举,校验阶段拦住非法 category,XPath 就不必写一长串 or。把「合法值」放 Schema,「查询切片」放 XPath,比把枚举写进每一条谓词干净。
cast as、treat as、instance of 是 2.0 运算符。instance of xs:decimal 可在谓词里分流。1.0 没有。遇到未知函数或语法错误,先看是不是抄了 2.0 类型语法进 1.0 引擎。
无类型比较的著名坑:字符串 '10' > '9' 为假,因为字典序 '1' 小于 '9'。number 之后 10>9 为真。Schema 把字段标成数字,就是为了从根上拆掉这类比较。在无 Schema 项目里,number 是你自己贴的临时类型。
问题:JSON 有 Schema 吗?
XPath 3.1 能查 JSON 的 map/array,类型是另一套。JSON Schema 不会自动变成 XPath 注解。别把 XML Schema 经验直接搬到 JSON 查询。
问题:校验失败的文档还能查吗?
很多流水线仍会解析出树,只是没有可靠类型注解,甚至结构残缺。XPath 对残缺树仍尽量返回空或局部命中。不要用「能查出节点」证明文档合法。合法是 Schema 的活。
四、untypedAtomic、字符串比数字、以及 Schema 不自动生效
没有 Schema 时,2.0 仍可能把拍扁后的值标成 untypedAtomic,比较规则接近 1.0 的宽松转换。不要看见「我在用 2.0 引擎」就删掉 number。问的是节点有没有类型注解,不是引擎版本号。schema-aware 开启且实例校验通过,price 才能按小数比。lxml 不走这条链路:旁边放着 Schema 文件,xpath 方法仍然把价格当文本。Schema 对它主要是校验入口,不是 XPath 类型来源。
字符串比较数字的经典事故:'10'>'9' 为假,因为字典序看第一个字符。number 之后 10 大于 9 为真。无 Schema 项目里,number 就是你自己贴的临时类型。漏贴一次,报表排序会按字典走,看起来像随机。代码评审看见价格、数量、年份和大于号在一起,强制问有没有 number 或类型注解。
DTD 的 ID 类型是 1.0 里少数「类型有用」的角落,id 函数靠它工作。HTML 的 id 属性通常不是这种类型。枚举放 Schema 能在校验阶段拦住非法 category,XPath 就不必写一长串或。把合法值放 Schema,把切片放 XPath,比把枚举复制进每一条谓词干净。校验失败的文档仍可能被解析成树,XPath 查出节点不证明文档合法。合法是 Schema 的活,查询是切片的活,两本账。
cast as、instance of 是 2.0 运算符。抄进 1.0 会语法错误。报错时先看是不是类型语法混进了 1.0 引擎,再看路径。JSON Schema 不会自动变成 XPath 3.1 的 map 类型注解。XML Schema 经验不能直接搬到 JSON 查询。字段格式先约定,再选函数族。year 写成 2005 和写成日期字面是两种模型,混比没有自动对齐。
书店教程全文没有 Schema,所以比较一律显式转换。你维护的行业 XML 若已校验,查字段类型,能丢掉 number 再丢。不要反过来:看见教程写 number 就以为有 Schema 的项目也必须写——那是教程迁就 1.0 现实,不是永远的最佳形态。
五、无 Schema 时 number 就是你贴的类型
书店 price 是文本。'10'>'9' 字典序为假,number 之后为真。漏写 number,排序和过滤会按字典走,报表像随机。有 Schema 且引擎 schema-aware 时,price 注解为小数,gt 按数值比,可以丢掉 number。lxml 不走这条链路,旁边的 Schema 文件不会改变 xpath 结果。问的是注解在不在树上,不是磁盘上有没有 Schema 文件。
untypedAtomic 是 2.0 对无类型值的标签,比较仍宽松。不要看见 2.0 引擎就删转换。ID 类型让 id 函数工作,HTML 的 id 通常不是。枚举放 Schema,切片放 XPath。校验失败仍可能查出节点,那不证明合法。cast as 抄进 1.0 会语法错误。JSON Schema 不会变成 map 注解。year 数字和日期字面不要混比。
练习:用字符串比较 '10' 和 '9',再 number 比较,记下真假。把这组结果贴到代码评审清单:「价格旁边的大于号有没有 number」。再确认项目用的是不是 lxml——是的话,讨论 Schema 类型就是跑题,继续显式转换。行业 XML 已校验且 Saxon schema-aware,再评估能否丢掉 number。两条路都合法,混用会让同事以为类型「有时灵」。
六、类型是树上的第二张标签不是磁盘上的说明书
没有类型注解时价格是文本,字符串比大小按字典,十会小于九。转换函数是你自己贴的临时标签。说明书放在旁边,轻量库也不会因此按小数比较,它主要用来校验实例。能看见注解的是开启感知并且校验通过的引擎。无类型原子在高版本里仍然比较宽松,看见高版本号就删转换会翻车。标识类型让标识函数工作,超文本的标识常常不是那种类型。合法值放说明书,切片放路径。查出节点不证明文档合法。类型语法抄进一点零会直接语法错。年份数字和日历字面不要混比。书店教程没有说明书,所以比较一律显式转换;行业报文若已校验且引擎吃注解,再评估能否丢掉转换。两条路都合法,混用会让同事以为类型有时灵。
用字符串比较十和九,字典序为假;转成数再比,为真。把这组真假贴到评审清单:价格旁边的大于号有没有转换。轻量库旁边放着说明书也不会按小数比较,说明书对它主要是校验。能看见注解的是开启感知并且校验通过的引擎。看见高版本号就删转换会翻车,因为无类型原子仍然比较宽松。标识类型让标识函数工作,页面标识常常不是那种类型。合法值放说明书,切片放路径。查出节点不证明合法。类型语法抄进低版本会语法错。年份数字和日历字面不要混比。书店教程没有说明书所以显式转换;行业报文若已校验且引擎吃注解,再评估能否丢掉转换。两条路都合法,混用会让同事以为类型有时灵。
原文集把高版本类型树铺开:字符串、布尔、小数、浮点、双精度、日期时间,还有无类型原子。无说明书时节点拍扁后接近无类型原子,比较规则接近低版本的宽松转换。说明书本身不是路径语言的一部分,它描述什么元素能出现、类型是什么。校验器先检查实例再把注解挂到树上,路径引擎若开启感知才能看见。很多轻量引擎不感知,即使有说明书文件,路径里仍然全是无类型。说明书能定义标识类型让标识函数可用,也能定义枚举在校验阶段拦住非法分类。把合法值放说明书,把切片放路径,比把枚举写进每一条筛选干净。转换与视为、是否某类型是高版本运算符,抄进低版本会语法错。
用字符串比较十和九得假,转成数再比得真,把这组结果贴到评审清单。再确认项目用的是不是轻量库,是的话讨论说明书类型就是跑题,继续显式转换。行业报文已校验且引擎吃注解,再评估能否丢掉转换。两条路都合法,混用会让同事以为类型有时灵。无说明书时价格是文本。轻量库旁边放着说明书也不会按小数比较。能看见注解的是开启感知并且校验通过的引擎。看见高版本号就删转换会翻车。标识类型让标识函数工作,页面标识常常不是。合法值放说明书,切片放路径。查出节点不证明合法。类型语法抄进低版本会语法错。年份数字和日历字面不要混比。对象记法说明书不会自动变成映射注解。
十和九的字典序与数值序相反,评审看见价格和大于号就问有没有转换。轻量库不吃旁边的说明书当注解。感知开启且校验通过才看见小数。高版本号不等于已贴注解。页面标识常常不是标识类型。枚举放说明书切片放路径。查出节点不证明合法。类型语法不要抄进低版本。年份和日历不要混比。对象记法说明书不会变成映射注解。无类型原子比较仍宽松。书店教程没有说明书所以显式转换。
十大于九在字典序里是假,在数值序里是真。轻量库不靠旁边的说明书改比较规则,没有注解就继续显式转换。
动手验收用字符串比较十和九得假、转成数再比得真,把这组真假贴到评审清单:看见价格旁边的大于号就问有没有转换。轻量库旁边即使放着说明书也不会按小数比较,说明书对它主要是校验实例。查出节点不证明文档合法,合法值放说明书,切片仍放路径。
本章回顾
- 1.0 四类型:节点集、布尔、数字、字符串
- 书店样本无 Schema:比较继续 number
- Schema 注解要 schema-aware 引擎才看见
- lxml 不靠旁边的 Schema 文件改 XPath 类型
- 字符串比数字会翻车:'10'>'9' 为假
- 枚举放 Schema,切片放 XPath
下一章把已经能写对的表达式接到 Python、Java、浏览器和抓取工具上,并处理
//的性能账单。