- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:XPath 是在 XML 和 HTML 树里用路径选出节点的查询语言。本教程动手优先:先写出能命中节点的表达式,再补轴、谓词、函数和版本差异,学完能在代码和浏览器里把数据抠出来。
这个教程解决什么问题
你手头有一份书店 XML,或者浏览器里一页商品列表。需求很具体:把所有 book 的书名拿出来;只要 category 是 web 的那几本;价格大于 35 的标题;带命名空间前缀的节点为什么怎么写都是空。很多人先去背「七种节点」「十三种轴」,背完还是写不出第一条能跑的路径。本教程反过来:第一条路径先写出来,空结果再回头查轴和谓词。
XPath 不是独立程序。它嵌在 Python 的 lxml、Java 的 XPath 工厂、浏览器的 document.evaluate、XSLT 的 select、抓取工具的字段规则里。表达式写对了, mandarin 数据就出来;写错了,引擎安静地返回空节点集,不会像 SQL 那样报「列不存在」。所以本教程把「空结果怎么排」当成一等技能。
贯穿全文的样本是同一棵书店树:根元素 bookstore,下面若干 book,每本有 category 属性、title、author、year、price。你在脑子里把这棵树当书架,路径就是编目号。
适合谁读
- 要解析 XML 接口、配置文件或 RSS 的后端与测试工程师
- 写页面抓取、UI 自动化,需要稳定选中元素的人
- 维护 XSLT 样式表或 XQuery 脚本,想把路径部分写扎实的人
- 会一点 CSS 选择器,但碰到属性、文本、命名空间就卡住的人
学完你能做什么
- 写出绝对路径、相对路径和双斜杠三种选法,并说清各自何时会扫整棵树
- 用轴从当前节点往上、往下、往旁边走,用谓词按位置、属性、数值过滤
- 在谓词里调用
count、contains、number、not等常用函数 - 给带命名空间的文档绑前缀,而不是对着空结果干瞪眼
- 在 Python、Java、浏览器里跑同一条表达式,并避开
//滥用带来的性能坑 - 判断当前引擎是 1.0 还是 2.0/3.1,避免把
let、箭头运算符写进只支持 1.0 的库
学习路线
第 1 章只做一件事:让表达式命中节点。第 2 章把函数当扳手,塞进谓词里。第 3 章处理真实文档里最常翻车的命名空间,以及 2.0 的变量和类型。第 4 章把同一条路径接到语言和工具上。第 5 章分清 XPath、XQuery、XSLT,以及 1.0 到 3.1 该跟哪套引擎走。
图:五章怎么叠在同一棵树上
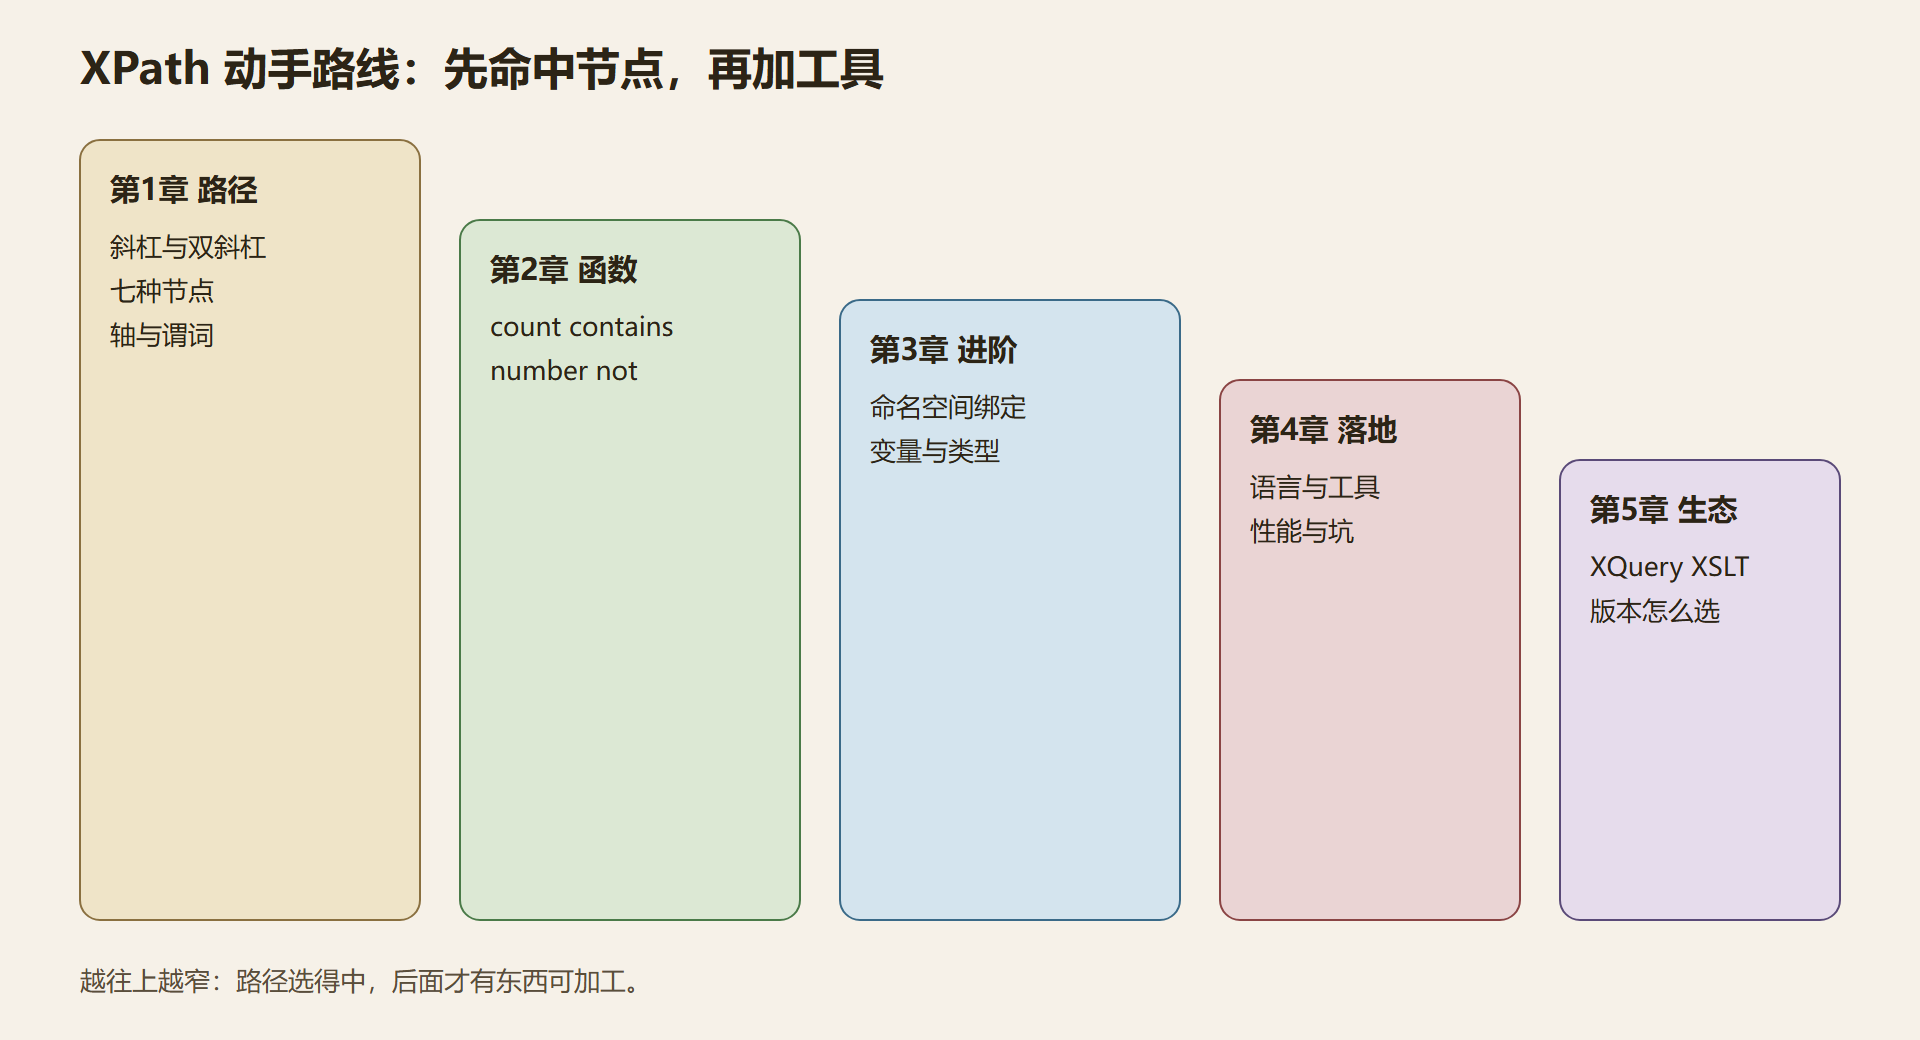
贯穿样本与阅读对照
全文反复使用同一棵书店树,避免每节换文档导致「这条路径到底命中谁」对不上号。根元素叫 bookstore,下面是 book,每本带 category 属性,孩子是 title、author、year、price。三本版本用来讲绝对路径、属性过滤和价格比较;四本版本多出 XQuery Kick Start 及其两个作者,用来讲位置谓词和兄弟轴。你不必把样本背下来,但要能指着树说出「第三本的第一个作者」对应哪一步。
| 章 | 你要亲手写出的东西 | 常见空结果原因 | 预计耗时 |
|---|---|---|---|
| 第1章 | 三条路径、换轴、方括号过滤 | 上下文错、属性写成了子元素 | 最长,建议一次读完 |
| 第2章 | 把函数塞进谓词 | string 只拍扁第一项、价格没转数字 | 可当手册翻 |
| 第3章 | 给默认命名空间绑前缀 | 只给最后一步加了前缀 | 必须动手绑一次 |
| 第4章 | 同一条路径接到语言和工具 | 返回类型拿成单个字符串 | 对照你正在用的语言 |
| 第5章 | 分清定位、查询、变换和版本 | 把 3.0 箭头抄进 1.0 引擎 | 按需,不必一次学完 |
和 SQL 的类比只在「都是声明式查询」这一层成立。SQL 面对表和列,写错列名通常会报错;XPath 面对树,写错元素名往往安静返回空节点集。所以本教程把「空了怎么办」写进第 1 章和第 4 章,而不是附录。CSS 选择器在 HTML 上更短,但没有父轴、文本谓词也弱,需要那些能力时才请 XPath 上场——第 4 章会明确分工,避免你把两种选择器揉成一锅。
怎么用这个教程
每节开头都有一条对着书店样本能直接跑的表达式。先在脑子里预测命中哪些节点,再看正文核对。不要跳过第 1 章去抄第 2 章的函数——函数是写在已经选中的节点集上的。读节的时候把表达式抄进你的求值器,改一个谓词看 count 怎么变,比只看表格记得牢。
环境不强制。Python 用 lxml 最省事,它基于 libxml2,XPath 1.0 完整,2.0 只覆盖一部分。浏览器开发者工具也能试简单路径。Java 走工厂类编译再求值。教程里的示例写成纯文本表达式,不写成可点击链接,也不给保存成某某文件的指令;把 XML 片段贴进你正在用的求值器即可。平台会把方括号路径误当成超链接,所以正文一律用代码块包起来。
预计第 1 章最耗时间,后面函数表可以当手册翻。第 3 章命名空间建议动手绑一次前缀,纸上记「前缀只是本地别名,真正匹配的是 URI」。若你明天就要抠一份带默认命名空间的接口响应,读完 1.1 和 3.1 再出门,比按目录从前往后刷完更划算。第 5 章的版本阶梯用来防止你把箭头运算符抄进只能跑 1.0 的库。
开读前先在求值器里贴三本版书店树,跑从根到书名的绝对路径,心里应能报出三本书名。报不出就先别翻函数章。空了就把路径从右往左砍,每砍一步数一次节点,定位卡在哪一层。这十分钟比先背轴名更省后面的返工。四本版留到位置谓词和兄弟轴再用,过早混进样本会让「第几本」对不上号。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...