4.1 编程语言里的 XPath
4.1 编程语言里的 XPath
本节摘要:把路径接到宿主时,差的不是斜杠写法,而是解析器、命名空间注册、返回类型。Python 优先 lxml(libxml2,XPath 1.0 完整);标准库 ElementTree 只支持子集。Java 要 compile 再 evaluate,并声明 NODESET 还是 STRING。同一条
//title/text(),返回类型不同,你拿到列表还是一个拼串。
先说结论
阅读完本节,你应当能够:
- 用 lxml 对根求
/bookstore/book[@category='web']/title并取文本 - 说明 ElementTree 的 XPath 子集缺哪些轴和函数
- 阅读 Java 示例:NODESET 遍历 title,STRING 取 web 类书名
- 在 C#、PHP、JS 里认出对应入口,不把文件路径写进教程
一、同一条路径,Python 与 Java
目标路径(纯文本,不要当链接):
//book[@category='web']/title/text()
三本样本期望:Learning XML。四本样本还有 XQuery Kick Start。
lxml 概念调用:解析字符串得到根,root.xpath(那条路径) 得到文本列表。相对路径 book[@category='web']/title 在根就是 bookstore 时同样能用。注册命名空间用 namespaces 字典,见第 3 章。
Java 原文集写过完整流程:DocumentBuilder 解析,XPathFactory 出 XPath,compile("//title/text()"),evaluate(document, NODESET) 得到 NodeList,循环 getNodeValue。第二条 //book[@category='web']/title/text() 用 STRING 返回类型,得到单个字符串——多节点时通常是第一个。要全部 web 书名,必须 NODESET 再循环,不能图 STRING 省事。
# 概念:返回类型决定你拿到什么 NODESET → 多个 title 文本 STRING → 往往只有第一个 BOOLEAN → 是否存在 NUMBER → count 或 number 的结果
二、各语言入口对照
| 语言 | 常用入口 | XPath 版本 | 备注 |
|---|---|---|---|
| Python | lxml | 1.0 完整,2.0 部分 | 首选;基于 libxml2 |
| Python | ElementTree | 子集 | 无复杂谓词、轴残缺 |
| Java | javax.xml.xpath | 1.0 | 返回类型必须显式 |
| Java | Saxon | 2.0/3.1 | 要日期、let 换它 |
| JS 浏览器 | document.evaluate | 1.0 | HTML 空间见 4.2 |
| C# | System.Xml.XPath | 1.0 | Navigator 迭代 |
| PHP | DOMXPath | 1.0 | query 返回 DOMNodeList |
原文集点名:lxml 性能好因为 C 实现;ElementTree 免安装但「简单查询够用」。我的判断:项目里只要出现 @ 谓词、text()、轴,就不要赌 ElementTree,直接 lxml。
不要在正文里写「保存为某某点 py」。把 XML 放进字符串或从已有流解析。平台禁止文件路径教学。
⚠️ 常见坑:Java 的
evaluate默认 STRING。你以为拿到所有 title,其实是第一本 Everyday Italian。编译时写清 NODESET。
💡 关键直觉:路径字符串可复制粘贴;绑定前缀、返回类型、HTML 还是 XML 解析,这三件事每门语言都要单独核。
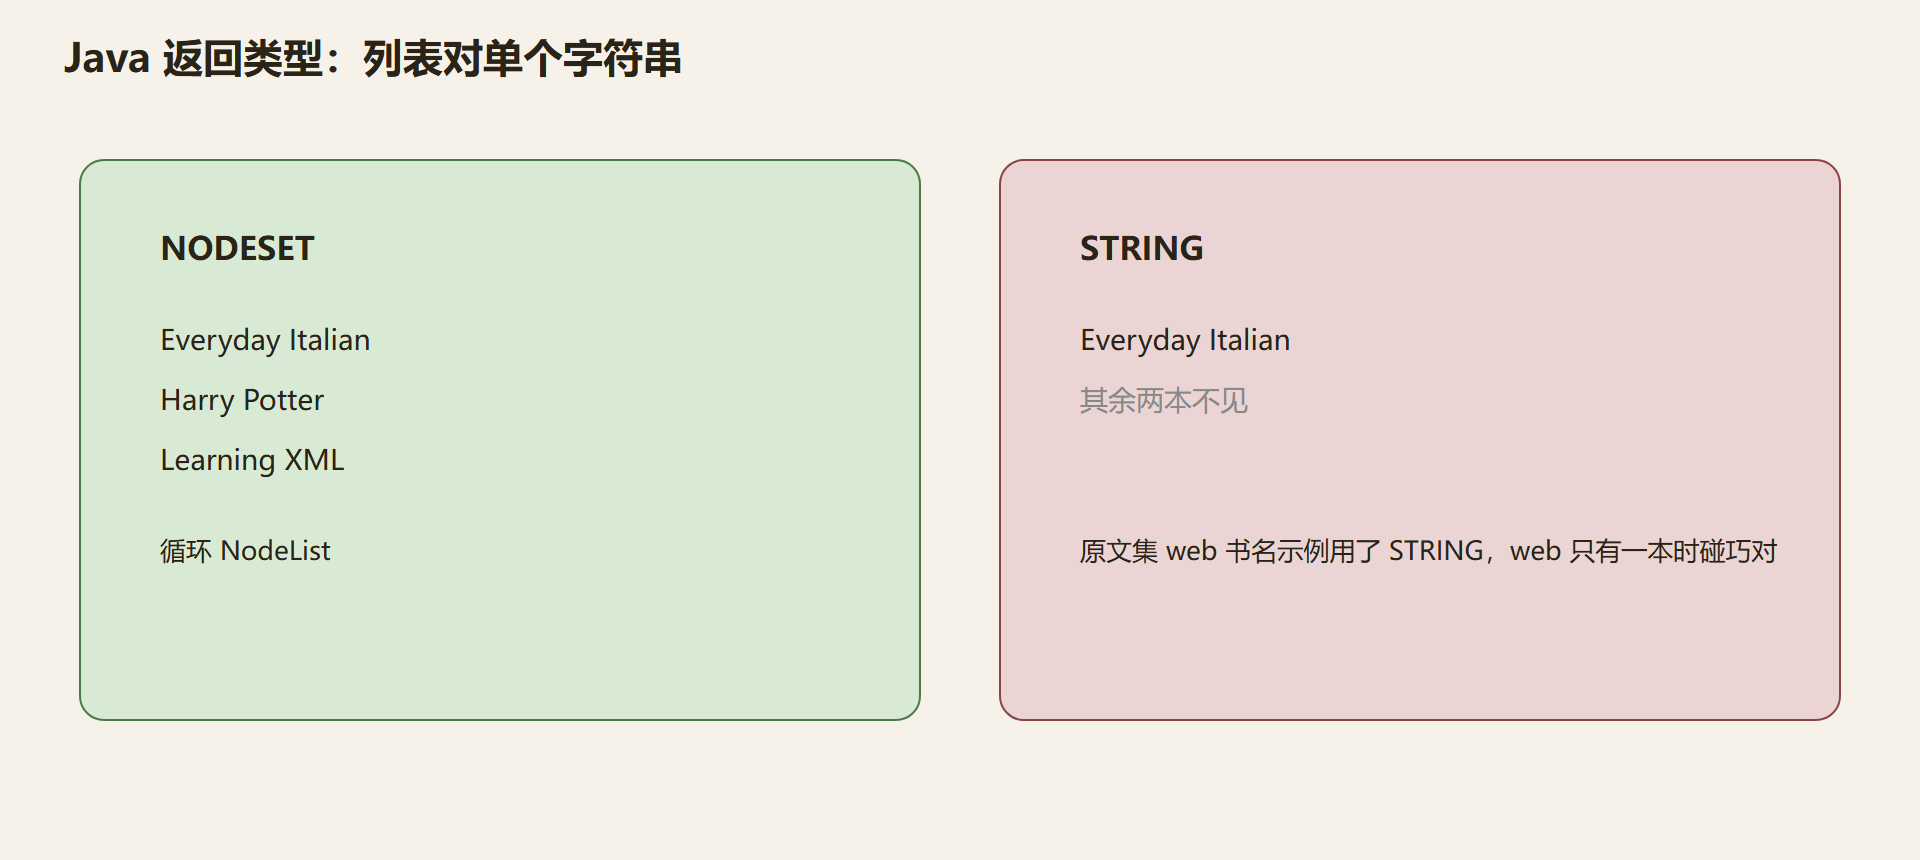
图:STRING 砍成第一本
三、解析选项会改变树
XML 解析器默认可能丢掉注释、合并相邻文本、根据 DTD 展开实体。HTML 解析器会补 <tbody> 一类节点,你按源码缩进写的 /table/tr 可能要改成 /table/tbody/tr。路径对着解析后的树写,不是对着源文件字符写。
编码:声明是 UTF-8 实际是别的,根都解析失败,谈不上 XPath。先保证树建起来。
线程:有的 XPath 对象非线程安全。Java 的 XPath 实例别跨线程共用,可以共用已编译的 XPathExpression,仍要看实现说明。lxml 的树不要在多线程里一边改一边查。
问题:Node.js 怎么办?
浏览器 API 不在。可用 xmldom 加 xpath 包,或把 HTML 当浏览器环境用 JSDOM。版本仍是 1.0 居多。需要 2.0 同样找 Saxon-JS 一类。
问题:能否一次编译、多次对文档求值?
可以,也该这样。Java compile 的成本不可忽略。表达式不变、文档在变的循环里,编译放循环外。这是 4.3 性能的语言侧对应物。
四、解析选项、线程、以及编译放哪
XML 解析器可能丢掉注释、合并相邻文本、按 DTD 展开实体。HTML 解析器会补 tbody,/table/tr 要改成带 tbody 的那一层。路径对着解析后的树写。换解析选项等于换树,测试夹具要固定解析器参数,否则同一条路径今天过明天不过。编码声明与实际字节不一致时,树都建不起来,谈不上 XPath。先保证解析成功。
Java 的 XPath 实例常常非线程安全。不要跨线程共用同一个工厂产物去并行 evaluate。文档树在 lxml 里也不要一边改一边查。只读查询可以在多线程各拿各的表达式对象打同一棵不可变树,仍要看库的说明,不要想当然。
compile 放循环外。表达式不变、文档在变,或文档不变、参数在变,都只编译一次。Java 这条尤其贵。lxml 的 xpath 方法每次传入字符串也会解析,热点路径可以把表达式常量化,避免每次从业务代码临时拼。拼用户输入进路径是注入,参数用绑定或只允许数字。
ElementTree 的 XPath 是子集:复杂谓词、部分轴、部分函数会静默不支持或抛异常,视版本而定。项目里只要出现 at 谓词、text、轴,不要赌标准库,直接 lxml。原文集把两者并列介绍,我的判断更硬:生产选 lxml。C#、PHP、浏览器的入口不同,但返回类型问题同构——要列表就按列表取,要存在性就按布尔取,不要用字符串类型去「顺便拿全部」。
Node.js 没有浏览器 document。可用模拟 DOM 的库加 xpath 包,版本仍是 1.0 居多。需要 2.0 找专门引擎。不要假设「JavaScript 就能用 3.1」。同一条路径字符串跨语言可复制,绑定前缀、返回类型、HTML 还是 XML 解析这三件事每门语言单独核。
五、把 Java 示例的两条查询对着四本书走一遍
第一条 //title/text() 用 NODESET:四个文本节点,Everyday Italian、Harry Potter、XQuery Kick Start、Learning XML。改成 STRING:往往只剩 Everyday Italian。原文集打印全部书名用了 NODESET,这是对的。第二条 web 类书名用 STRING:四本里 web 有两本,STRING 通常只给 Kick Start,Learning XML 丢了。样本若是三本、web 只有一本,STRING 碰巧正确。夹具一换就暴露。生产要全部 web 书名,必须 NODESET 循环。
lxml 的 xpath 方法返回列表,更接近 NODESET。相对路径 book[@category='web']/title 在根是 bookstore 时能用。ElementTree 遇到这个谓词可能直接能力不足,不要在生产赌。命名空间用 namespaces 字典一次注册,不要每条查询现场造不同前缀映射还期望能共用缓存。
解析器把 HTML 补成带 tbody 的表,路径按补完的写。编码错误时树建不起来。compile 放循环外。线程不要共用非安全的 XPath 对象。拼用户输入进路径是注入。Node.js 不是浏览器,1.0 居多。
练习:同一条 web 书名路径,在列表返回和单字符串返回各跑一次,记下条数。四本夹具下条数必须是 2 对 1,才能说明你真懂返回类型。再在 HTML 模式下对一张表写 tr 路径,看要不要 tbody。这两下覆盖 4.1 最贵的两个坑。
六、返回类型才是跨语言最大的坑
同一条书名路径,要列表就按节点集取,按字符串取往往只给第一本。原文示范用字符串取网络类书名,样本里该类只有一本时碰巧对,四本夹具有两本网络类就会丢一本。生产要全部,必须按列表循环。标准库子集不够就不要赌,生产选完整实现。解析器会补表格体、丢注释、按编码失败,路径对着解析后的树写。编译放循环外。线程不要共用非安全对象。禁止把用户字面拼进路径。脚本环境和浏览器不是同一套文档对象。路径字符串可复制,绑定护照、返回类型、超文本还是标记语言解析,这三件事每种语言单独核。练习用四本夹具对照列表与字符串两条返回,条数必须能对上二对一。
同一条网络类书名,按列表取和按字符串取各跑一次。四本夹具下列表应是两本,字符串往往是一本。条数对上二对一,返回类型课才算过关。原文示范用字符串取网络类书名,样本里该类只有一本时碰巧对。生产要全部必须按列表循环。标准库子集不够就不要赌。解析器会补表格身体、丢注释、按编码失败,路径对着解析后的树写。编译放循环外。线程不要共用非安全对象。禁止把用户字面拼进路径。脚本环境和浏览器不是同一套文档对象。路径字符串可复制,绑定护照、返回类型、超文本还是标记语言解析,这三件事每种语言单独核。
原文集点名某种库基于底层引擎所以性能好,标准库免安装但简单查询才够用。我的判断更硬:只要出现盖章筛选、文字节点、方向,生产不要赌标准库。另一种语言要先编译再求值,并声明想要节点集还是字符串,同一条取全部书名文字,返回类型不同你拿到列表还是拼起来的第一个字符串。编码声明与实际字节不一致时树都建不起来。有的求值对象非线程安全。表达式不变文档在变的循环里,编译放循环外。节点环境没有浏览器那套文档对象,版本仍是低版本居多。不要假设某种脚本语言就能用最高版本。
同一条网络类书名路径,在列表返回和单字符串返回各跑一次,记下条数。四本夹具下条数必须是二对一,才能说明你真懂返回类型。再在超文本模式下对一张表写行路径,看要不要补上的身体层。这两下覆盖最贵的两个坑。标准库子集不够就不要赌,生产选完整实现。解析器会丢注释、合并相邻文字、按编码失败,路径对着解析后的树写。编译放循环外。线程不要共用非安全对象。禁止把用户字面拼进路径。脚本环境没有浏览器那套文档对象,版本仍是低版本居多。不要假设某种脚本语言就能用最高版本。路径字符串可复制,绑定护照、返回类型、超文本还是标记语言解析,这三件事每种语言单独核。原文示范用字符串取网络类书名,样本里该类只有一本时碰巧对,夹具一换就丢书。
二对一的条数对照是返回类型课的金标。碰巧对的示例发生在网络类只有一本时。超文本补身体让行路径要多写一层。标准库不够就换完整实现。编译放循环外。禁止拼用户输入。线程不要共用非安全对象。脚本环境不是浏览器文档对象。三种语言各自核护照注册、返回类型、解析模式。路径字符串可复制不表示求值器可假定。编码失败时没有树。注释可能被解析器丢掉,路径对着留下的树写。
同一条路径换返回类型会换答案,夹具要用四本才能揭穿碰巧。解析选项换了等于换树,测试要固定解析器参数,否则今天过明天不过。
编译一次循环多次,是语言侧最便宜的加速。表达式不变文档在变,或文档不变参数在变,都只编译一次。把编译放进循环,等于每次问路都先重新画地图。
返回类型写错时程序往往不崩溃,只是少给几本书名,这种静默比报错更危险。四本夹具里网络类必须是两本,少一本就是类型砍过。
树不要边改边查。只读查询可以并行,仍以库说明为准,不要想当然共用一个求值对象。
动手验收把同一条选出网络类书名的路径用节点集和字符串两种返回类型各跑一次。四本夹具里网络类必须是两本:节点集应打出两行书名,字符串往往只留下第一本。少一本不要先改路径,先改返回类型声明。
温故知新
- lxml 是 Python 首选:ElementTree 只适合玩具路径
- Java 必须声明返回类型:STRING 会藏节点
- 原文集 web 书名用 STRING:多本时要改 NODESET
- 解析器决定树形状:HTML 补 tbody
- 命名空间用各语言自己的注册表
- 不要把路径写成可点击链接
下一节走出 IDE:浏览器、抓取器、编辑器里怎么试路径,以及 CSS 够用时别上 XPath。