4.3 性能优化与最佳实践
4.3 性能优化与最佳实践
本节摘要:XPath 变慢,多半是在扫不该扫的节点。原文集把瓶颈归为文档复杂度、表达式复杂度、引擎实现、硬件。动手上能立刻改的是:用 child 链代替
//,谓词尽早砍枝,编译一次循环多次,命名空间只注册一次。本节合并 4.4 与 4.5:性能和纪律是同一份清单。
本节地图
阅读完本节,你应当能够:
- 把
//title收成/bookstore/book/title并说明少扫了什么 - 把能确定的属性谓词写在靠前的步
- 在循环里复用已编译表达式
- 用空结果三步法区分「没有数据」和「路径写错」
一、先改这一条
慢:
//book[number(price)>35]//title
快且更准:
/bookstore/book[number(price)>35]/title
// 展开 descendant-or-self,书店只有三层时看不出差别;HTML 上万节点时,每条字段查询扫整棵树,抓取器开始喘。原文集优化目标写得很清楚:减少不必要遍历,降低表达式计算复杂度。硬件是最后才该买的。
能写绝对或从已知上下文走 child,就不要从文档任意位置搜。// 留给「深度真的未知」的稀有情况,并接受账单。
二、清单:快与稳
| 做法 | 为什么 | 反例 |
|---|---|---|
child 链代替 // |
不扫无关分支 | 整页 //span |
| 谓词靠前 | 后面步的输入变小 | 先 descendant 再过滤 |
| 属性比文本便宜 | 不必拍扁子树 | 先 string(.) 再 contains |
| 编译一次 | 解析表达式有成本 | 循环里每次 compile |
| 注册命名空间一次 | 避免每次建映射 | 每条查询现场字典 |
| 相对上下文 | 缩小搜索根 | 每张卡片都从 html 起步 |
| 避免 following 轴 | 吸尘器 | 本可用 sibling |
| 结果类型选对 | 少做无用转换 | 只要存在却取 NODESET 再 count |
原文集还提到引擎差异:有的实现对某轴有索引。你控制不了引擎时,仍能控制表达式形状。不要为微优化把路径写成无人能懂的轴全名;先保证短而具体。
⚠️ 常见坑:用
//*[contains(@class,'item')]在超大 DOM 上跑。*加 contains 是双重全扫。能定位到列表容器就先走到容器。
💡 关键直觉:性能来自「少看节点」,不是来自更花哨的函数。count 很快,//很慢。
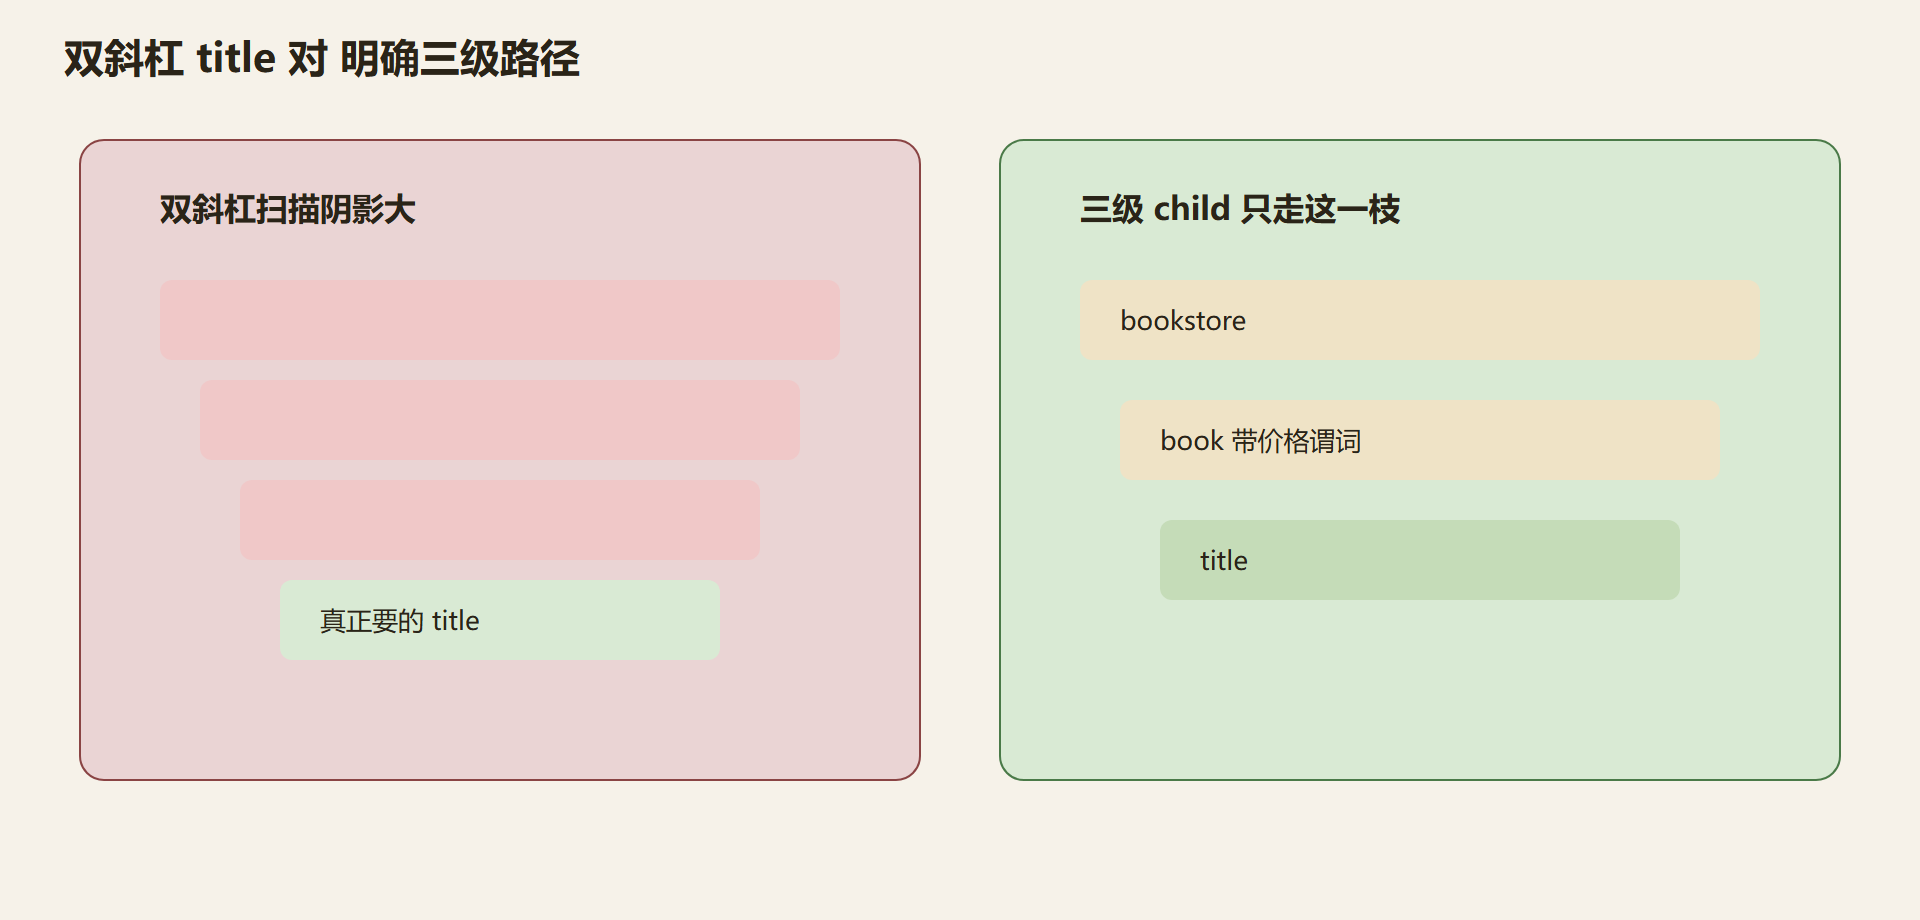
图:双斜杠扫过的阴影
三、最佳实践(从 4.5 并入)
可移植:正文只写 1.0 能跑的路径,2.0 函数单独标注。提交给未知引擎的表达式禁止 let、matches、current-date。
空结果三步:上下文 → 轴与命名空间 → 谓词。先去掉谓词看 count,count 为 0 再查护照和轴,count 很大再加回过滤。
不要拼用户输入进路径:那是注入。参数用变量绑定或仅允许数字。
表达式当数据:集中放常量,不散落魔法字符串。改一处书名路径,所有调用点跟上。
测试对着固定样本:书店三本四本两套夹具足够覆盖位置谓词、多 author、价格 number。不要用线上随时变的 HTML 当单测金标。
文档与代码一致:注释里写「选 web 类书名」,路径就不要偷偷加 price 条件。
原文集还提过硬件。在改表达式之前去做垂直扩展,是把账单留给下一任。先把 // 收掉。
问题:谓词里再写 // 更慢吗?
是。每个候选都会再扫一棵子树。写成 book[title='x'] 只看孩子 title,比 book[.//title='x'] 便宜。只有 title 可能深藏时才用后者。
问题:count(//*) 当健康检查?
会逼引擎走遍所有元素,文档大时它自己就是故障。健康检查 count 根的直接孩子即可。
四、评审清单与注入
把 4.5 最佳实践收成评审问题,比单独一节「应该怎样」好执行。表达式里有没有双斜杠?有的话深度是否真未知?谓词能不能前移到更靠前的步?属性过滤是不是被放在文本 contains 后面?循环里有没有每次编译?命名空间映射有没有每次现场新建?用户输入有没有拼进字符串?单测是不是对着固定书店夹具而不是线上 HTML?注释描述的切片和路径实际条件是否一致?
注入值得单独强调。路径是语言,拼进未消毒的字符串等于让外人改查询。轻则多跑一截 descendant,重则读到不该读的配置节点。数字阈值用格式化数字,字符串参数用变量绑定。1.0 没有绑定就在宿主里先选大集合再过滤,不要把用户字面塞进方括号。
谓词里再写双斜杠,每个候选都会再扫一棵子树。book[title='x'] 只看孩子,比 book[.//title='x'] 便宜。只有 title 可能深藏时才用后者。count 双斜杠星号当健康检查会逼引擎走遍所有元素,文档大时它自己就是故障。健康检查 count 根的直接孩子即可。
following 轴是吸尘器,日常用 sibling。//*[contains(@class,'item')] 是双重全扫。先走到列表容器。硬件和换引擎放在改表达式之后。原文集把文档复杂度、表达式复杂度、引擎、硬件并列,动手顺序应是表达式形状第一,引擎第二,硬件最后。
可移植默认 1.0。2.0 函数单独标注。提交给未知引擎禁止 let、matches、current-date。空结果三步:上下文、护照与轴、谓词。先摘谓词看 count。测试夹具用三本和四本两套,覆盖位置、多作者、价格转换。不要用随时变的线上页当金标。
五、把慢表达式收成三级链的现场
慢写法 //book[number(price)>35]//title 在书店上结果碰巧对,因为树小、title 只出现在书里。把样本改成 book 内再嵌目录 title,双斜杠会多捞目录名。收成 /bookstore/book[number(price)>35]/title 之后,目录枝根本不走。这就是「少看节点」。评审看见双斜杠先问深度是否未知,未知才允许留,并接受账单。
谓词前移:先按属性砍成 web,再在两本书上比价格,比先 descendant 出全部 title 再回溯便宜。属性过滤比拍扁子树做 contains 便宜。循环里每次 compile 是语言侧浪费。用户输入拼进方括号是注入。count 双斜杠星号当健康检查会自己变成故障。following 是吸尘器。谓词里再写双斜杠,每个候选再扫一棵子树。
练习:在故意嵌套了目录 title 的夹具上跑慢写法和收紧写法,count title 两个数字。慢写法更大。再把 compile 挪出循环,用日志证明解析次数下降。空结果时先摘谓词看 count,count 为零查护照和轴,不为零再加回条件。把这套当例行,而不是出了事故才翻最佳实践。
六、快来自少看节点不是来自更花哨的函数
能写从根到书再到书名的三级链,就不要先铺开全体再捞。书里再嵌目录书名时,铺开会多捞,三级链不走那一枝。筛选条件往前放,后面步吃到的集合更小。属性判断比拍扁子树做包含便宜。循环里反复编译是语言侧浪费。用户输入拼进路径是注入。用铺开全体再计数当健康检查,检查本身会成为故障。吸尘器轴日常不用。筛选里再铺开,每个候选再扫一棵子树。可移植默认一点零,高版本函数单独标注。空了先摘筛选看大小。单测对着固定书架夹具,不要用随时变的线上页当金标。硬件和换引擎放在改表达式之后。评审就问这些问题,比单独背口号有用。
在故意嵌套了目录书名的夹具上跑铺开全体的写法和收成三级链的写法,数书名两个数字。铺开的更大,三级链只走书这一枝。这就是少看节点。评审看见双斜杠先问深度是否未知。筛选条件往前放,属性判断比拍扁子树做包含便宜。循环里反复编译是语言侧浪费。用户输入拼进路径是注入。用铺开全体再计数当健康检查,检查本身会成为故障。吸尘器轴日常不用。筛选里再铺开,每个候选再扫一棵子树。可移植默认低版本。空了先摘筛选看大小。单测对着固定书架夹具。硬件和换引擎放在改表达式之后。把这些问题写成评审表,比单独背口号有用。
慢写法在小树上结果碰巧对,会让人误以为铺开全体没有代价。把目录书名嵌进书里之后,铺开会多捞,从总馆到书再到书名的三级链不走目录枝。把这两条对着同一份夹具计数,数字差就是少看了哪些节点。评审看见双斜杠先问深度是否真未知,未知才允许留并接受账单。筛选前移的意思是先按盖章砍成小队,再在小队上比价格,而不是先铺开所有书名再回溯。盖章判断不必拍扁子树。循环里每次编译是语言侧浪费,热点路径把表达式常量化。用户输入拼进方括号是注入,数字阈值格式化数字,字符串参数能绑定就绑定,不能绑定就在宿主里先选大集合再过滤。用铺开全体再计数当健康检查,检查本身会成为故障,健康检查只数根的直接孩子。吸尘器方向日常不用兄弟即可。筛选里再铺开,每个候选再扫一棵子树。可移植默认低版本,高版本函数单独标注。空了先摘筛选看大小。单测对着固定书架,不要用随时变的线上页当金标。注释说选网络类书名,路径就不要偷偷加价格条件。硬件和换引擎放在改表达式之后。
嵌套目录夹具上两条写法计数不同,差就是多看的节点。深度未知才留双斜杠。筛选前移。盖章比拍扁便宜。编译放循环外。禁止注入。健康检查不要铺开全体。吸尘器不用。筛选里不要再铺开。默认低版本。空了先摘筛选。固定夹具做单测。注释和路径条件一致。硬件最后。评审就问这些问题。用户输入当参数绑定或后过滤。表达式集中放常量。引擎差异你控制不了时仍能控制表达式形状。
少看节点优先于换机器。把铺开全体收成三级链,再谈引擎和硬件。注入和空结果三步与快慢同样是纪律,不是附录。
属性过滤放在文本包含前面,因为揭章不必拍扁子树。先包含再回溯盖章,是把贵的计算放在大集合上,队伍还没砍小。
健康检查若自己把整棵树走一遍,监控会先于业务把机器拖垮。只数根下直接孩子,足够判断文档在不在,不必证明引擎能遍历所有后代。
微优化把路径写成无人能懂的轴全名,不如先保证短而具体。可读性和少看节点可以同时成立。
一节小结
- 瓶颈首先是遍历量:收
// - 谓词前移:少让后代步吃大集合
- 编译放循环外:Java compile 尤其贵
- 空结果三步:上下文、护照与轴、谓词
- 1.0 可移植为默认:2.0 显式标注
- 禁止把用户输入拼进路径
下一章把 XPath 放回它的亲戚中间:XQuery 负责查询表达式,XSLT 负责把树变成另一棵树,版本从 1.0 走到 3.1。