5.1 XPath 与 XQuery
5.1 XPath 与 XQuery
本节摘要:XPath 负责在树里定位;XQuery 在定位之上做 FLWOR——for、let、where、order by、return——并能构造新的 XML。你在前四章写的路径可以直接嵌进 XQuery 的 for 子句。需要「查出再拼一份新文档」时用 XQuery;只需要节点列表时,XPath 加宿主循环更简单。
本节导读
阅读完本节,你应当能够:
- 把
/bookstore/book[number(price)>35]/title嵌进一条 for-return - 说明 XQuery 能构造元素而 XPath 1.0 不能
- 判断何时不必上 XQuery
- 认出 XQuery 里的路径仍然遵守轴、谓词、命名空间
一、先用 XPath 取出贵书名,再用 XQuery 包一层
XPath 已经能做:
/bookstore/book[number(price)>35]/title
XQuery 写成:
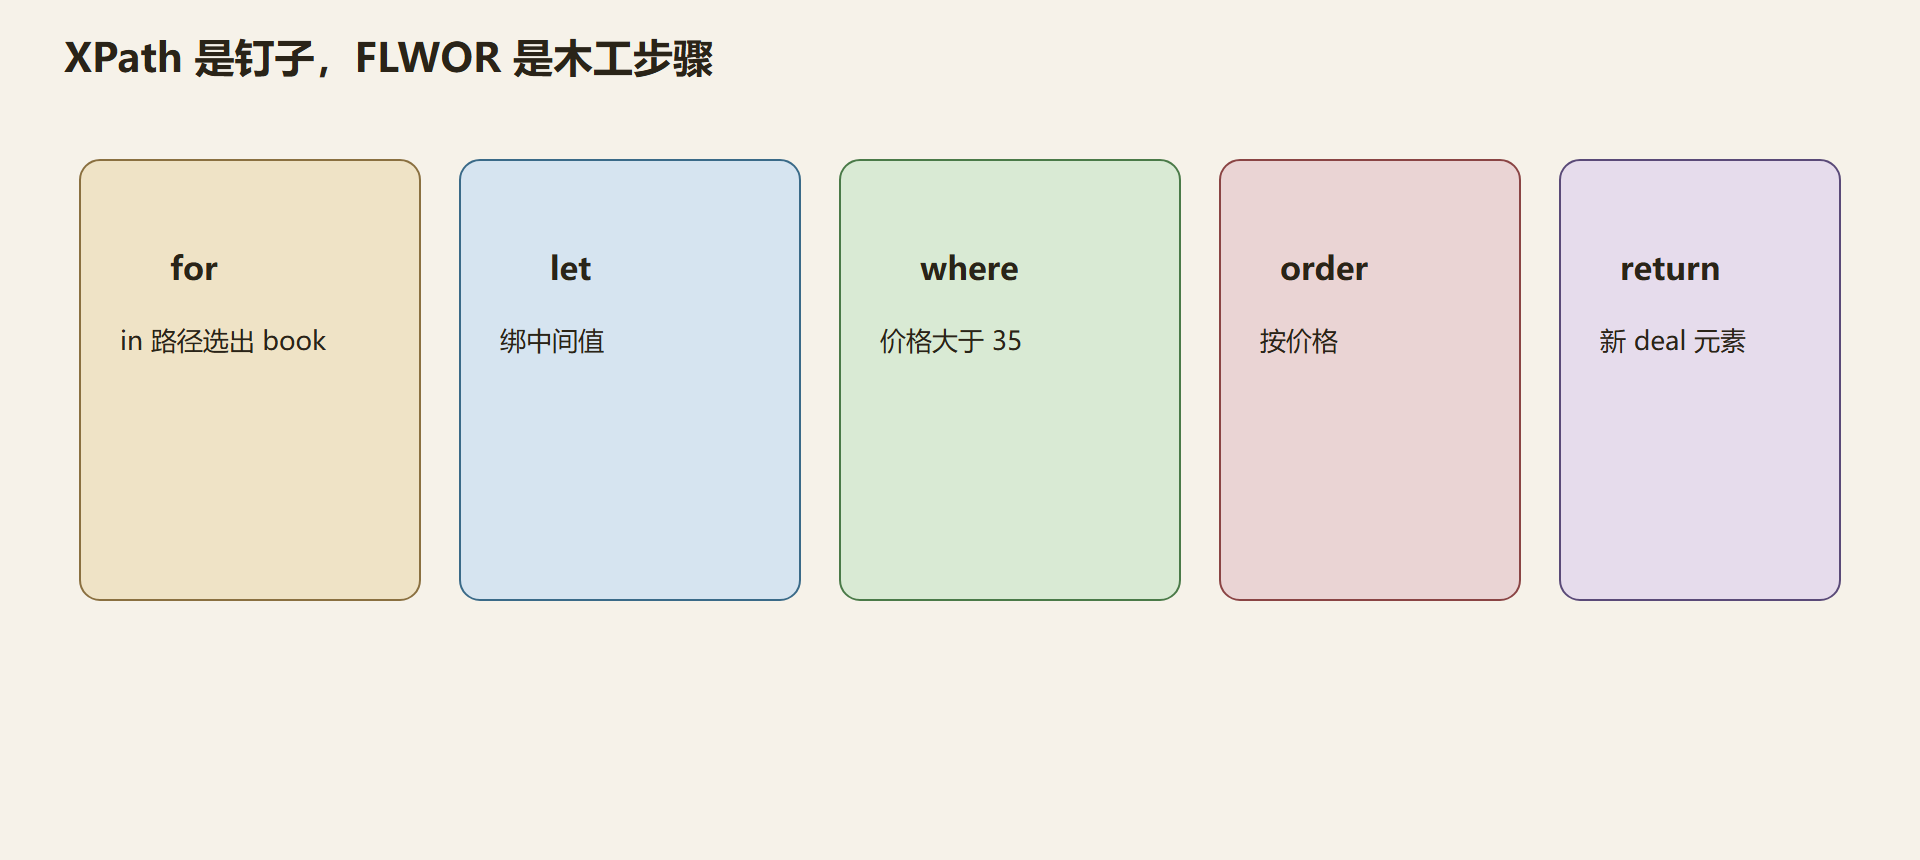
for $b in /bookstore/book where number($b/price) > 35 return $b/title
命中集合相同。XQuery 的赚头在 return 可以换形状:
for $b in /bookstore/book where number($b/price) > 35 return <deal>{ $b/title/text() }</deal>
得到一串新的 deal 元素。XPath 1.0 做不到「新建标签」。宿主语言当然也能拼字符串,但在 XML 数据库或专门 XQuery 引擎里,FLWOR 是本机活。
原文集把 XPath 概括为路径、谓词、函数、轴——正是前四章。XQuery 把这些当表达式语言用,再加查询与构造。
二、分工
| 需求 | XPath | XQuery |
|---|---|---|
| 选节点 | 本职 | 嵌路径 |
| 谓词过滤 | 本职 | where 更可读 |
| 构造新元素 | 不能 1.0 | return 直接写标签 |
| 多文档 join | 很吃力 | for 两个 in |
| 排序 | 宿主 | order by |
| 更新文档 | 无 | 有 Update Facility,另一套 |
where 与谓词常能互译。for $b in /bookstore/book[number(price)>35] 与 where 子句二选一即可,别写两遍条件。我在短过滤上仍爱谓词,where 留给跨变量的条件。
⚠️ 常见坑:在 XQuery 里写
//book然后抱怨慢。XQuery 不会自动给你索引魔法,路径形状该收还是要收。数据库产品若对某路径建了索引,那是产品特性,不是语言承诺。
💡 关键直觉:XQuery 不是「更强的 XPath 语法糖」。它是查询+构造。还在「取出 title 列表」阶段,别换语言。
图:路径嵌进 FLWOR
三、命名空间与版本
XQuery 序言里可声明默认元素命名空间,于是路径又能写裸名。这是相对 1.0 宿主求值最大的体验差。模块化、函数库也在序言。路径知识仍然完全适用:轴、谓词、number()。
XQuery 1.0 对应 XPath 2.0 数据模型。不要假设 XQuery 引擎接受的路径能原样贴进 lxml。反过来,lxml 跑通的 1.0 路径几乎总能嵌进 XQuery。
构造时记得元素内容里再嵌路径要花括号。写错会变成字面文本 { $b/title } 而不是书名。这是 XQuery 语法,不是 XPath 的锅。
问题:XQuery 能改原文档吗?
标准查询是只读的。更新要 Update Facility 或把新树写到别处。别把 return 新元素理解成原地改 bookstore。
问题:和 SQL 比?
都是声明式。SQL 面对表,XQuery 面对树。join 在树里靠值相等,没有外键语法糖。能把数据放进表就用 SQL,树形状本身是信息时用 XQuery。
四、何时不上 XQuery,以及构造时的花括号
还在「取出 title 列表交给 Python」的阶段,上 XQuery 是换锤子。宿主循环已经很短,FLWOR 的 return 新标签只有在下游真吃 XML 时才值回票价。XML 数据库、存在查询模块、需要 join 两棵树或 order by 在引擎内完成,这些才是切换信号。用 XQuery 重写已经跑通的 lxml 三行代码,属于风格展示,不是工程需要。
where 与谓词重复是常见赘肉。for $b in /bookstore/book[number(price)>35] where number($b/price)>35 把同一刀砍两遍。短过滤留谓词,跨变量条件用 where。order by 在 1.0 路径里没有,不要假装写在谓词里能排序。排序是 XQuery 或宿主的活。
构造时元素内容里再嵌路径要花括号。写漏会变成字面文本而不是书名。这是 XQuery 语法,排错不要回头改轴。命名空间方面,XQuery 序言可声明默认元素命名空间,裸名复活。这是相对 1.0 宿主求值最大的体验差。模块和函数库也在序言。路径知识完全适用:轴、谓词、number。
XQuery 1.0 对应 XPath 2.0 数据模型。lxml 跑通的 1.0 路径几乎总能嵌进 XQuery;反向把 let 和构造抄进 lxml 不行。更新原文档不是标准查询的职责,要 Update Facility 或把新树写到别处。return 新元素不是原地改 bookstore。
和 SQL 的分工:表状数据用 SQL,树形状本身是信息时用 XQuery。join 在树里靠值相等,没有外键语法糖。不要把 XQuery 当「XML 版 SQL」硬套执行计划,路径形状该收还是要收,数据库产品若对某路径建了索引,那是产品特性不是语言承诺。
五、把贵书查询写成 FLWOR 时每一行在干什么
假设四本书都在,价格分别是 30、29.99、49.99、39.95。for 子句 for $b in /bookstore/book 会绑定四次,每次 $b 是一本。where 用 number($b/price) > 35 留下第三本和第四本。return $b/title 得到两个 title 元素。若改成 return 一个 deal 元素包住书名文本,下游收到的是新造的节点,不是原树里的 title。这是 XQuery 相对 XPath 多出来的能力,也是多出来的责任:你要决定新树长什么样。
若把 where 条件再写进 for 的谓词里,同一刀砍两遍,结果不变,阅读的人会怀疑是不是两套阈值。删掉其中一处。order by number($b/price) 之后第三本 Kick Start 会排到第四本 Learning XML 后面,因为 49.99 更大——不对,降序才把贵的放前面。1.0 路径没有排序,看见结果顺序和价格顺序一致,那是碰巧文档序如此,不要当特性依赖。
join 两棵树的雏形:另一份折扣表按书名对齐。XQuery 可以两个 for。XPath 1.0 做这件事很吃力,通常拉到宿主用字典。这就是「何时上 XQuery」的具体尺子:出现第二份文档要按值对齐,再考虑换锤子。仅仅多一层过滤,谓词足够。
把这条 FLWOR 抄进 lxml 会怎样?for、where、return、花括号构造全部不是 1.0 路径语法,求值器会报语法错误或未知标记。正确做法是把 for 里的路径抠出来单独在 lxml 跑,构造放 Python 拼元素。语言边界要清晰。XQuery 序言里声明默认元素命名空间之后,for 里又能写裸名 book,这福利不要拿去要求 1.0 宿主「也应该能裸名」——1.0 没有查询侧默认空间这个开关。
练习:用 where 写出「web 类且贵」的书名列表,再用谓词写同一条件,对照 count。再故意写漏 return 里的花括号,看输出是字面还是书名。这两下能把 XQuery 和 XPath 的边界钉住。
六、只要列表就别换锤子
定位语言取出书名列表,宿主循环已经很短。查询语言多出来的是构造新标签、按值对齐两棵树、在引擎内排序分组。下游不吃新文档就不必换。过滤条件不要在路径筛选和条件子句里写两遍。排序不是一点零路径的职责,看见顺序和价格一致是碰巧文档序如此。查询语言对应的是二点零数据模型,低版本跑通的路径几乎都能嵌进去,反向把构造和就地绑定抄回低版本会语法错。更新原文档不是普通查询的职责。和表查询的分工是:表状用表语言,树形状本身是信息时用树查询。索引是产品特性不是语言承诺,路径该收还是要收。练习用两种写法表达同一贵书条件,count 一致再谈构造。
还在取出书名列表交给程序循环的阶段,换查询语言是换锤子。查询语言多出来的是构造新标签、按值对齐两棵树、在引擎内排序。下游不吃新文档就不必换。过滤不要在路径筛选和条件子句里写两遍。排序不是低版本路径的职责,看见顺序和价格一致是碰巧文档序如此。低版本跑通的路径几乎都能嵌进查询语言,反向把构造和就地绑定抄回低版本会语法错。更新原文档不是普通查询的职责。表状数据用表语言,树形状本身是信息时用树查询。索引是产品特性不是语言承诺。练习用两种写法表达同一贵书条件,计数一致再谈构造。漏花括号会输出字面而不是书名,那是查询语法不是方向写错。
原文集把路径概括为走法、筛选、函数、方向,查询语言把这些当表达式语言用再加查询与构造。需要查出再拼一份新文档时用查询语言;只需要节点列表时,路径加宿主循环更简单。条件子句与筛选常能互译,短过滤留筛选,跨变量条件用条件子句。查询侧可声明默认元素空间,裸名复活,这是相对低版本宿主求值最大的体验差。查询语言低版本对应路径中版本数据模型。构造时元素内容里再嵌路径要花括号,写错会变成字面。标准查询是只读的,更新要另一套设施或把新树写到别处。
用条件子句写出网络类且贵的书名列表,再用筛选写同一条件,对照计数应当一致。再故意写漏构造里的花括号,看输出是字面还是书名。这两下能把查询语言和路径的边界钉住。还在取出列表交给程序循环的阶段,换查询语言是换锤子。查询语言多出来的是构造新标签、按值对齐两棵树、在引擎内排序分组。下游不吃新文档就不必换。过滤不要写两遍。排序不是低版本路径的职责,看见顺序和价格一致是碰巧文档序如此。低版本跑通的路径几乎都能嵌进查询,反向把构造和就地绑定抄回低版本会语法错。更新原文档不是普通查询的职责。表状数据用表语言,树形状本身是信息时用树查询。索引是产品特性不是语言承诺,路径该收还是要收。查询侧声明默认元素空间之后裸名能复活,不要拿这福利去要求低版本宿主也应该裸名。漏花括号是查询语法问题,排错不要回头改方向。
两种写法同一贵书条件计数一致再谈构造。漏花括号输出字面。只要列表就别换锤子。构造、对齐两棵树、引擎内排序才是切换信号。过滤不要写两遍。排序不是低版本路径职责。低版本路径可上嵌,反向不行。查询只读。表状用表语言,树形状是信息时用树查询。索引不是语言承诺。查询侧默认空间让裸名复活,不要要求低版本宿主同样做。条件子句与筛选互译,短过滤留筛选。
查询语言不是更强的路径语法糖,它是查询加构造。还在取列表阶段别换锤子。花括号漏了输出字面,那不是方向写错。
两个for对齐两份文档按书名联起来,才是换查询语言的硬尺子。仅仅多一层过滤,筛选足够,不必为了看起来高级把三行宿主循环改写成查询模块。
对齐第二份折扣表按书名联接,才值得打开查询语言。多写一个价格条件,筛选就能做完,换锤子是给联接和构造准备的。
查询模块序言里的空间声明和函数库,是路径知识之外多出来的工程层,路径本身仍按前四章写。
动手验收用「只要列表还是要新文档形状」当尺子:下游只要书名列表,继续路径加宿主循环;要对齐第二份折扣表并构造新元素,再打开查询语言。花括号漏了会把标签当字面输出,那不是方向写错,是构造语法没包住。
本节速览
- XPath 定位,XQuery 查询加构造
- 前四章路径可直接嵌进 for
- 只要列表就别换 XQuery
- where 与谓词别重复
- XQuery 默认元素命名空间能让裸名复活
- lxml 的 1.0 路径可上嵌,反向不行
下一节看另一门亲戚:XSLT 用路径当 select,输出常常是 HTML 或另一份 XML,而不是 FLWOR。