第3章 鉴定台:寻峰、比对与建模
第3章 · 鉴定台:寻峰、比对与建模
章节摘要:整备干净的档案本章上鉴定台,走完"翻译、比对、定量、验证"四步——先把连续曲线翻译成特征表,再回答"这是谁"与"有多少",最后用交叉验证给结论上保险。化学计量学的核心方法(寻峰、相似度、PCA、PCR、PLS)在这一章全部登场,每种都配从头实现的代码。
一条主线
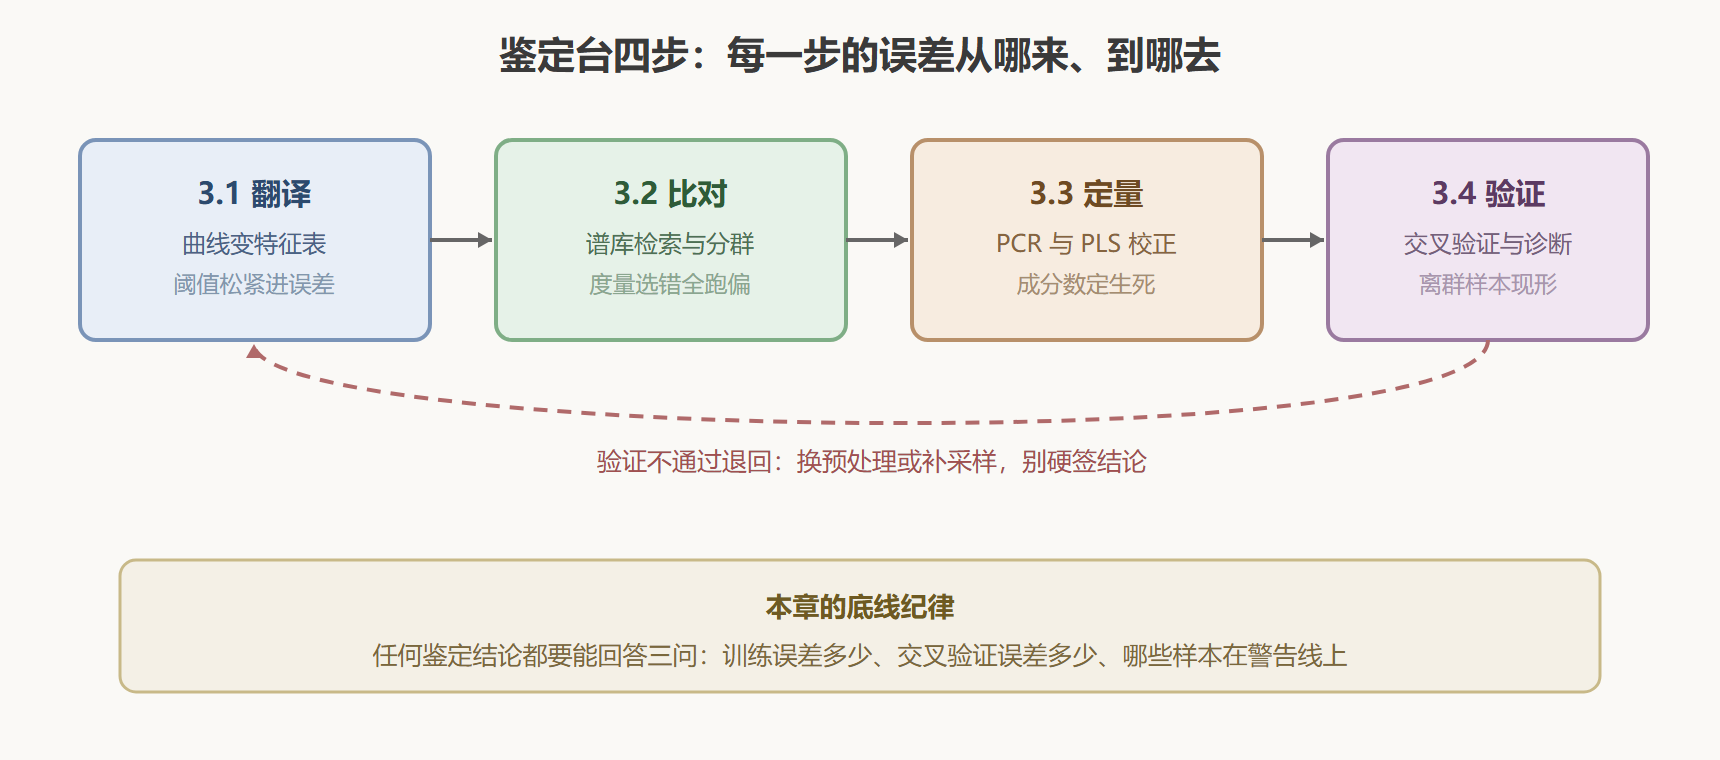
主线是一批未知样品的鉴定委托。四十份近红外谱图已经过第 2 章整备:噪声压平、基线拆掉、标尺统一。鉴定台的第一件事不是急着比对,而是翻译——把连续的曲线变成机器可算、人可核对的"峰位、峰高、峰宽"特征表(3.1 节);第二步比对,对谱库算相似度回答"这是谁",谱库里没有的就用 PCA 在得分图上看样本自然分群(3.2 节);第三步定量,从单波长校准曲线一路走到 PCR 与 PLS,回答"有多少"(3.3 节);第四步验证,交叉验证选成分数、杠杆值与残差揪离群样本,确认结论换个批次还成立(3.4 节)。
流程图里最容易被轻视的是从 E 退回 G 的那条边。鉴定所的真实作业里,相当一部分委托死在验证关:模型在训练集上漂亮、换个批次就垮,多半要回第 2 章换预处理,或回第 1 章补采样——鉴定是流程,不是单点算法。
本章三处易翻车也先记下:其一,寻峰阈值照抄文献——显著度阈值依赖各自的信噪比,别人的数字搬到你的谱上不是漏峰就是炸峰,必须从自己档案的噪声水平推;其二,相似度阈值拍脑袋——0.98 还是 0.95 不靠手感,从正品样本的分数分布推出来(第 5 章案例二会完整示范一次);其三,成分数贪多——PLS 成分数往上加,RMSEC 只降不升,把裁判换成 RMSECV 才能止住过拟合。这三处的共同病根都是"把别人的数字当成自己的结论",本章四个软件节从头实现的代码,就是让你亲手把每个数字的来历走一遍。
沿途站点
第一站(3.1 自动寻峰与特征提取):寻峰算法只有两个核心参数——显著度与最小间距,但它们的设定直接决定特征表的真假;半峰宽的测量、欠采样对峰位精度的影响都在这一站讲透。
第二站(3.2 指纹比对与定性鉴定):三种相似度度量(相关、余弦、欧氏距离)各自的免疫情形与失明情形;PCA 把四百维的光谱压进二维得分图,类与类的边界一眼可见;谱库检索的阈值怎么定、误判怎么防。
第三站(3.3 定量校正模型):单变量校准是物理直觉,多元校正才是化学计量学的主场——光谱高度共线、变量远多于样本,普通回归失灵;PCR 用方差换稳定,PLS 用协方差换精度,两者在实验里同台对照。
第四站(3.4 模型评估与交叉验证):RMSEC 会说谎、RMSECV 诚实、RMSEP 一锤定音;杠杆值抓"位置极端"的样本、残差抓"成分异常"的样本;还有一个真实教训——忘掉浓度向量中心化,模型整体偏移一个均值而你毫无察觉。
图1 鉴定台四步与误差流向
拐点与结论
本章最重要的认知转折发生在 3.3 与 3.4 之间:定量模型不是拟合出来的,是验证出来的。一个 PLS 模型在校正集上把 RMSEC 压到 0.005 并不难得,难的是换一批样本它还在 0.006 附近——化学计量学的功夫一半在建模、一半在证明模型不是巧合。第二个转折在 3.2:谱库检索回答不了"库外样品"的问题,得分图与分类模型才是开放世界的武器;反过来,库内样品用检索最省力。先判断样品在不在你的知识边界内,再选工具——这是鉴定台的第一判断。
读完你应该
- 用显著度与半峰宽两个参数从含噪谱里提取峰表,并说出阈值偏松与偏紧各漏掉或误报什么;
- 说明相关系数为何对乘性与加性扰动免疫,什么场景必须换欧氏距离;
- 手写 PCA 的奇异值分解实现,解释得分、载荷、方差贡献率各自回答什么问题;
- 用 NIPALS 从零实现两成分 PLS,解释它与 PCR 在潜变量选取上的差别;
- 用五折交叉验证选定成分数,并用杠杆值与残差把"位置极端"与"成分异常"两类离群样本区分开;
- 复现"忘掉浓度中心化"的 bug 并解释它为何难以从预测值上察觉。
下一章的接力
鉴定台的四步流程能应付大多数委托,但有两类硬骨头会卡住:峰叠在一起分不开(分辨率不够)、变量太多机理不明(常规模型失效)。下一章的高阶技术——曲线拟合解卷积与机器学习——专门啃这两类,而它们的效果好坏,仍然取决于本章练出的验证纪律。