3.1 自动寻峰与特征提取
3.1 自动寻峰与特征提取
本节摘要:寻峰把连续曲线翻译成"峰位、峰高、半峰宽"的特征表,是鉴定台一切后续工序的入口。显著度(prominence)是唯一真正需要理解的参数:它衡量一个峰从谷底冒出多少,直接决定漏检与误报的分界。本节用六峰模拟档案做阈值扫描与峰表测量。
档案整备完毕进了鉴定台,第一件事不是比对——是翻译。人眼读谱看形状,算法读谱只认数字:峰位(身份)、峰高(含量)、半峰宽(环境与仪器信息)三列数字就是特征表,谱库检索、定量建模、质量控制全都从这张表出发。本节承接第 2 章的导数光谱(那里你已经看到二阶导负谷能定位肩峰),把它升级成全自动、可复现的寻峰流程。
一、显著度:寻峰算法的良心参数
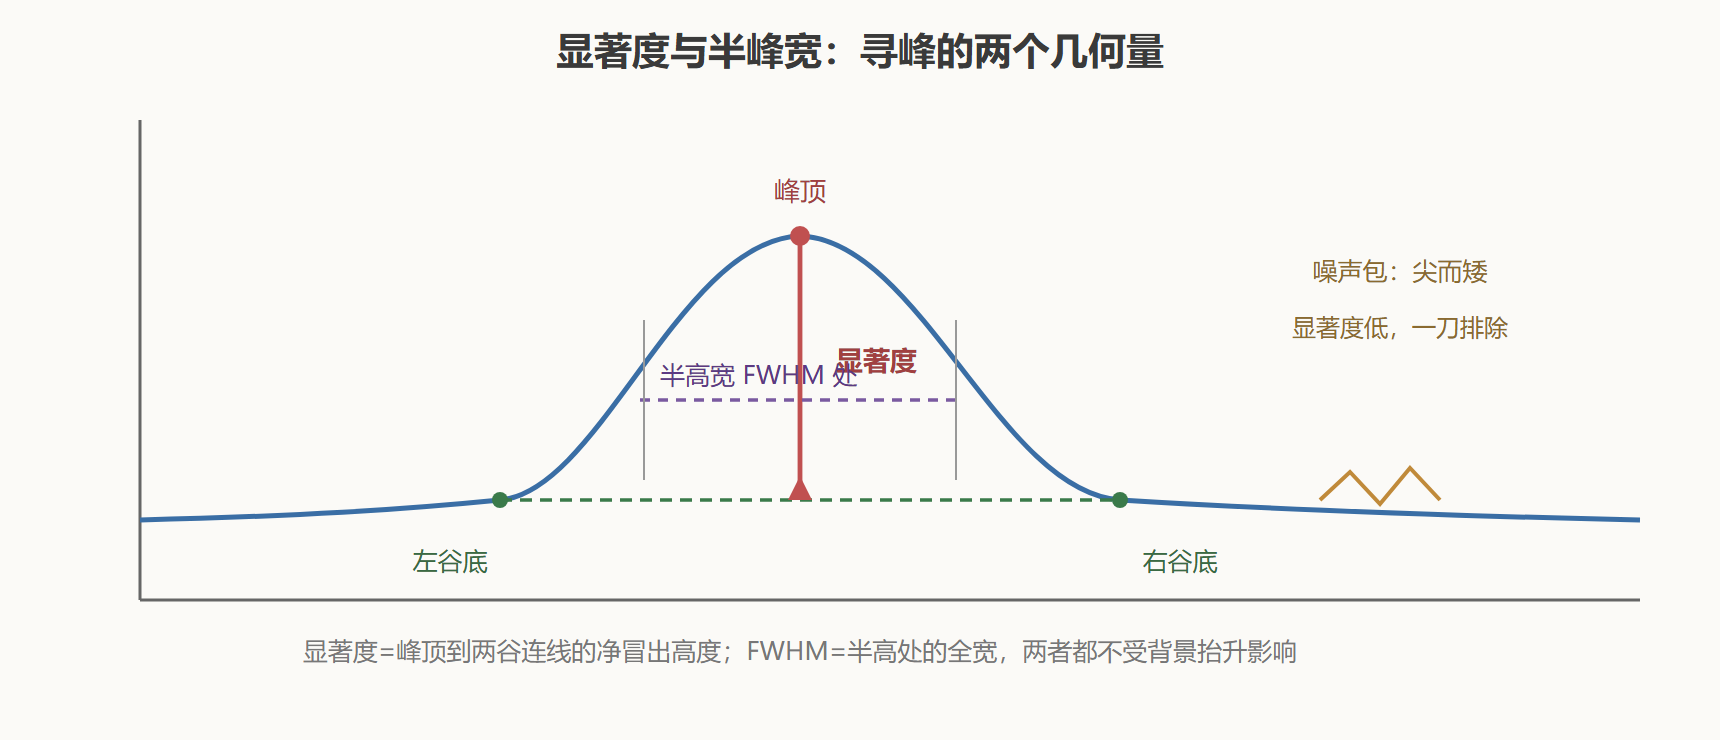
寻峰算法找局部极大值并不难,难的是区分"真峰"与"噪声包"。直观的峰高阈值不好用——叠在高背景上的矮峰是真峰,噪声堆出来的尖包可能更高。真正稳的判据是显著度:把一个峰两侧各挖到最近的更低谷底,峰顶到"两谷连线中较高者"的高度差。背景整体抬升不影响它,肩膀上的小峰只要从谷里冒出头来就算数。
用一份红外式模拟档案(六个峰,高度从 0.85 到 0.08,叠加噪声与基线偏移)做阈值扫描:
# 寻峰阈值扫描:prominence 从松到紧 import numpy as np from scipy.signal import find_peaks, savgol_filter rng = np.random.default_rng(3) x = np.linspace(500, 4000, 1400) # 波数轴 nu = [850.0, 1250.0, 1450.0, 1650.0, 2900.0, 3300.0] # 真峰位 amp = [0.30, 0.85, 0.12, 0.55, 0.20, 0.08] sig = [35.0, 25.0, 18.0, 30.0, 40.0, 60.0] clean = sum(a*np.exp(-0.5*((x-n)/s)**2) for a, n, s in zip(amp, nu, sig)) y = clean + rng.normal(0, 0.012, x.size) + 0.06 # 噪声 + 基线偏移 ys = savgol_filter(y, 31, 3) # 寻峰前先平滑 for prom in [0.05, 0.15, 0.3]: pk, _ = find_peaks(ys, prominence=prom) print(f"prominence={prom}: {len(pk)} peaks at {np.round(x[pk]).astype(int)}")
输出:
prominence=0.05: 6 peaks at [ 850 1251 1448 1651 2902 3299] prominence=0.15: 4 peaks at [ 850 1251 1651 2902] prominence=0.3: 3 peaks at [ 850 1251 1651]
三行输出就是一部漏检史。阈 0.05 时六个真峰全中(对照真值 850、1250、1450、1650、2900、3300,峰位误差不超过 2 个波数);0.15 时 0.12 的 1450 峰与 0.08 的 3300 峰被砍——它们的显著度低于阈值,属于"算法认为不够格";0.3 时连 0.20 的 2900 峰也丢了。阈值每收紧一档,牺牲的都是弱峰,而弱峰常常正是痕量组分的唯一证据。设阈值的正道不是试出来的,是算出来的:噪声显著度的典型值约等于噪声标准差乘以峰宽的平方根因子,取它的两到三倍做阈,既挡噪声又不误杀。
图1 显著度与半峰宽的几何含义
二、峰表测量:峰位、峰高、半峰宽
阈值定了,接下来把每个峰的三项数字量出来。半峰宽用相对高度 0.5 处的宽度(峰宽函数直接支持),它还能反推高斯宽度参数:
# 峰表:位置、高度、显著度、半峰宽 from scipy.signal import peak_widths pk, props = find_peaks(ys, prominence=0.15) w = peak_widths(ys, pk, rel_height=0.5) # 半高宽(点数) dx = x[1] - x[0] truth = {round(n): s for n, s in zip(nu, sig)} # 真值对照表 for i, p in enumerate(pk): t_sig = truth[min(truth, key=lambda k: abs(k - x[p]))] print(f"pos={x[p]:7.1f} height={ys[p]:.3f} prom={props['prominences'][i]:.3f} " f"FWHM={w[0][i]*dx:6.1f} truth_sigma={t_sig}")
输出:
pos= 850.3 height=0.357 prom=0.303 FWHM= 84.7 truth_sigma=35.0 pos= 1250.5 height=0.872 prom=0.818 FWHM= 63.2 truth_sigma=25.0 pos= 1650.8 height=0.603 prom=0.545 FWHM= 72.2 truth_sigma=30.0 pos= 2901.7 height=0.262 prom=0.209 FWHM= 99.2 truth_sigma=40.0
拿半峰宽与真值对账:高斯的半峰宽应为 2.3548 乘宽度参数,真值 35 对应 82.4,测得 84.7;真值 25 对应 58.9,测得 63.2。测量值普遍偏大 3% 到 7%,两个来源:平滑窗口(31 点的 SG 把峰抹宽了一点)与半高处噪声。这给了两条工程提醒——要精确峰宽就减小平滑窗口(代价是噪声误报增多),以及峰宽做对比时必须全程同一套参数,混用两套处理管线的峰宽没有可比性。峰位那列同样值得看:四个峰位误差都在 2 个波数内,因为峰顶处曲线平缓,位置精度受采样间隔与噪声双重限制——第 1 章说过的"每像元 0.147 纳米"在这里变成了实实在在的峰位不确定度。
三、特征表之外:特征还能怎么提
峰表不是唯一的特征语言,三类补充各有主场。积分面积:对指定波数区间积分,比峰高抗噪(噪声在积分里正负抵消),定量建模常用它替代峰高。指定点强度:不寻峰,直接取几个关键波数的强度做特征,快而糙,在线过程控制的主流做法。降维得分:把整条谱交给 PCA 或 PLS(3.2、3.3 节),得分本身就是特征——它不挑峰、不设阈值,代价是可解释性下降。寻峰特征与降维特征不是竞争关系:谱库比对、报告出具用峰表(人能读懂);机器学习管线用得分(机器吃得下)。
⚠️ 常见坑:寻峰前忘了平滑或忘了扣基线。噪声直接寻峰,阈值 0.05 会捞出十几个噪声包;基线偏移则改变显著度的参照线——本章所有寻峰都默认档案已经过第 2 章整备。
本节要点回顾
- 显著度是寻峰的良心参数:从谷底净冒出高度,不受背景抬升影响;阈值每收紧一档牺牲的都是弱峰;
- 阈值用噪声水平推算,取噪声显著度典型值的两到三倍,不靠反复试;
- 半峰宽测量偏大 3% 到 7%,来自平滑与噪声,对比峰宽必须全程同参数;
- 峰位精度受采样间隔限制,第 1 章的色散倒数在此兑现;
- 特征语言按下游选:峰表给人读,得分给机器吃。
特征表在手,鉴定进入比对环节。下一节把未知谱丢进谱库,看三种相似度度量谁免疫扰动、谁会被乘性波动骗过,PCA 又怎么把四百维压成一张人人能看的二维图。