第4章 高阶鉴定技术
第4章 · 高阶鉴定技术
章节摘要:鉴定台的标准流程卡住的两类硬骨头——重叠峰分不开、机理不明变量太多——由本章两件重武器接手:曲线拟合与解卷积把熔在一起的峰数学拆开,机器学习让判据从数据里自己长出来。重武器是放大器:数据干净它放大准确,数据脏它放大错误,第 3 章的验证纪律在本章一句都不能松。
一条主线
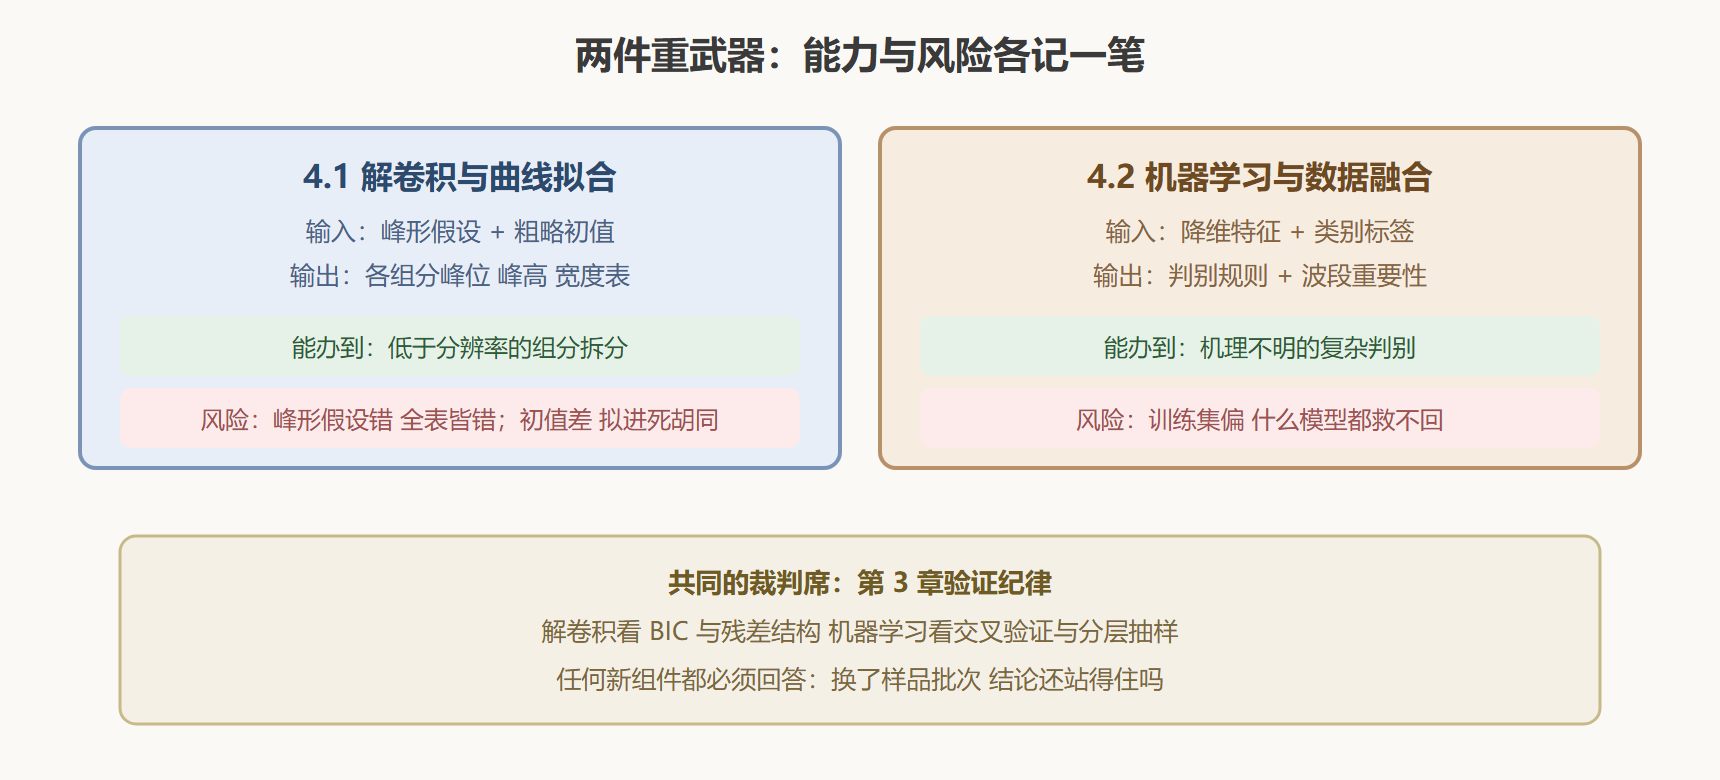
主线是一份"疑难指纹"的会诊记录。样品是某聚合物的小角区域谱:两座峰的间距小于半峰宽,2.6 节的导数只能隐约看见肩部轮廓,3.1 节的寻峰报出的是一个熔合包——物理分辨率不够,化学问题又要单独组分的信息,怎么办?第一条路是把峰形假设写进数学模型(高斯还是洛伦兹),用非线性最小二乘把两个峰的参数"解"出来(4.1 节解卷积);第二条路出现在另一份委托里——三百个样品要分三类,机理说不清、变量几百个,经典回归无从下手,让支持向量机与随机森林从数据里自己学判据(4.2 节)。两条路风格迥异却共享一条底线:结果必须回到第 3 章的验证框架里接受盘问。
上重武器之前先过两道预检。第一道:标准流程真的试过了吗——解卷积能拆的重叠峰,换更高分辨率往往拆得更干净;机器学习能学的判据,特征工程做扎实后经典方法常能追平。第二道:样本量与谱图质量够不够喂饱模型——解卷积至少要求峰包本身信噪比尚可,机器学习每类样本不足几十条时,交叉验证结果的方差会大到结论没有意义。两道都过了再动重武器,能省掉大量"高级方法跑了个寂寞"的返工。
另外记一笔:4.2 节的数据融合不仅合并仪器,也合并光谱与理化参考值——中级融合在定量任务上的收益通常比定性判别更稳定,预算有限时优先投资定量融合。而无论 4.1 还是 4.2,产出的每个参数都要能被化学常识复核,这个纪律在两站会反复出现。
沿途站点
第一站(4.1 重叠峰解卷积与曲线拟合):峰形函数怎么选(高斯、洛伦兹、沃伊特的分工)、初值怎么给、拟合结果怎么判可信;模型选择用 BIC 说话——多一个峰残差变小不等于峰真的存在。这一站把 2.6 节"导数放大肩峰"的手艺升级为"定量拆分"。
第二站(4.2 机器学习鉴定与数据融合):特征工程仍是主角(二阶导加 SNV 再降维),分类器反而是配角;随机森林附赠波段重要性排名,弱特征峰被自动顶到榜首;多台仪器数据的融合不是特征拼接那么简单,弱信息源混进来可能不涨反跌。二维相关光谱与光谱模拟作为高阶视角一并铺开。
图1 高阶技术在流程中的位置与风险标记
拐点与结论
本章的拐点是一个心态转换:前几章的方法都有清晰的物理或统计推导,解卷积与机器学习却都在用假设换信息——假设峰形是高斯,换回两个组分的参数表;假设"类别可分",换回一条判别边界。假设错了,输出照样光鲜,这是重武器最危险的地方。所以本章的结论只有一条纪律:解卷积的每个峰、机器学习的每个波段,都要能被化学常识复核——峰宽是否符合仪器分辨率量级、重要波段是否对应已知官能团。数据说话之前,先让化学说话。
读完你应该
- 写出高斯、洛伦兹、沃伊特三种峰形的适用场景(热展宽、寿命展宽、两者兼有);
- 用带边界的非线性最小二乘拟合两个重叠峰,并判读参数的置信区间;
- 用 BIC 在"1 峰、2 峰、3 峰"三个模型间做选择,解释为什么残差变小不等于峰变多;
- 搭一条"二阶导加 SNV 加降维加分类器"的机器学习管线,并用分层五折交叉验证比较模型;
- 解读随机森林的波段重要性排名,并复核它是否落在已知特征峰上;
- 说出低级融合与中级融合的差别,以及弱信息源融合不涨反跌的原因。
下一章的接力
武器库齐了。下一章是三场实战演习:食用油掺假、药品真伪、高光谱病虫害——每个案例都从委托背景走到鉴定结论,把前三章的工序完整串一遍。演习通过,鉴定所的流程才算真正属于你。