4.1 重叠峰解卷积与曲线拟合
4.1 重叠峰解卷积与曲线拟合
本节摘要:两峰间距小于半峰宽时,导数只能露肩、寻峰只报一个包——曲线拟合与解卷积把峰形假设写进数学模型,用非线性最小二乘拆出每个组分的峰位、峰高与宽度。峰形怎么选、初值怎么给、峰数怎么定(BIC 判决),本节全程用可复算实验演示。
疑难档案进高阶鉴定室。这份聚合物谱的两座峰中心相距 40 个波数、半峰宽各约 28 与 38——1.2 节的判据早就宣判"物理上分不开",可委托方要的恰恰是两组分的各自含量。物理分辨率到此为止,数学接手:假设每个峰的形状服从某个函数,把重叠谱表达成若干峰函数之和,拟合出参数——这一步叫解卷积或峰分解。它上承 2.6 的肩峰观察,下接第 5 章药品真伪案例里的定量拆分。
一、先选峰形:三种函数三个世界
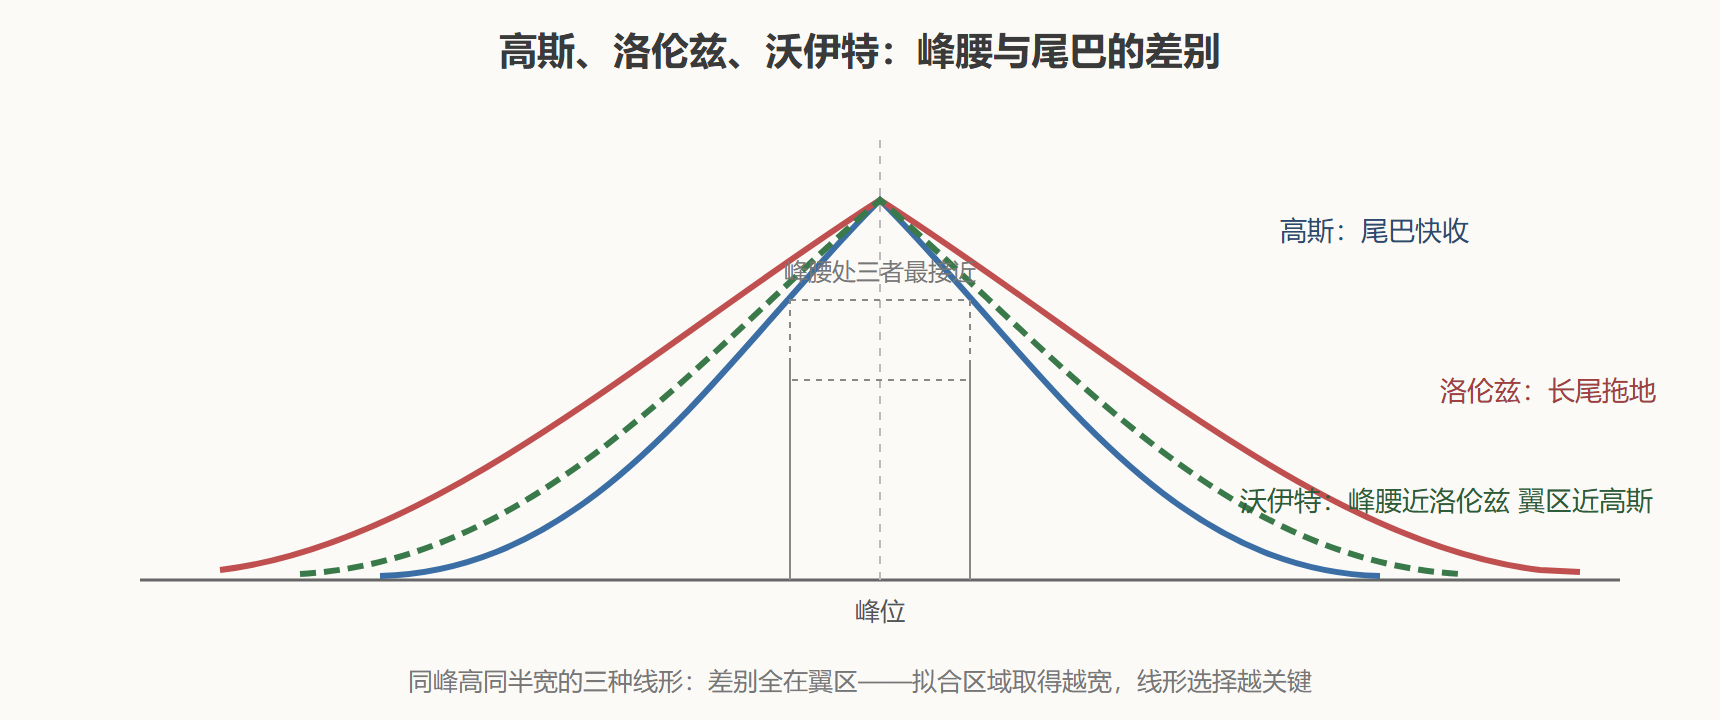
高斯线形来自热运动的多普勒展宽——大量分子速度按正态分布,叠加出钟形曲线,特点是尾巴收敛快;洛伦兹线形来自能级寿命(测不准原理)与碰撞展宽,特点是峰腰窄、尾巴长,拖得很远才衰减;沃伊特线形是两者的卷积,气体红外谱的实况——峰心像洛伦兹、翼区过渡到高斯。固体与液体里分子碰撞频繁,多数振动峰近似洛伦兹或沃伊特;而仪器狭缝函数若是高斯型,实测峰形还会再被卷宽一层。选错线形的后果不是拟合失败,而是拟合"成功"但参数有偏——用高斯去拟洛伦兹的长尾,算法只能把峰加宽或凭空多加一个小峰去补尾巴。
图1 三种线形的形状对比
二、两峰拆解:从初值到参数表
模拟这份疑难档案:高斯双峰(1000 处高 0.80 宽 12;1040 处高 0.45 宽 16)加 0.012 噪声,用带参数边界的非线性最小二乘拟合:
# 两峰解卷积:非线性最小二乘 import numpy as np from scipy.optimize import curve_fit rng = np.random.default_rng(17) x = np.linspace(950, 1100, 300) truth = [(1000.0, 0.80, 12.0), (1040.0, 0.45, 16.0)] # (峰位, 峰高, sigma) clean = sum(a*np.exp(-0.5*((x-n)/s)**2) for n, a, s in truth) y = clean + rng.normal(0, 0.012, x.size) def multi_gauss(x, *p): # k 个高斯之和 k = len(p)//3 return sum(p[3*i+1]*np.exp(-0.5*((x-p[3*i])/p[3*i+2])**2) for i in range(k)) p0 = [995, 0.9, 20, 1045, 0.5, 20] # 从图上粗读的初值 popt, pcov = curve_fit(multi_gauss, x, y, p0=p0) for i in range(2): print(f"fitted=({popt[3*i]:7.2f}, {popt[3*i+1]:.3f}, {popt[3*i+2]:6.2f})" f" truth=({truth[i][0]}, {truth[i][1]}, {truth[i][2]})") resid = y - multi_gauss(x, *popt) print(f"residual std={resid.std():.4f} (噪声真值 0.012)")
输出:
fitted=( 999.95, 0.802, 11.90) truth=(1000.0, 0.8, 12.0) fitted=(1039.70, 0.450, 16.06) truth=(1040.0, 0.45, 16.0) residual std=0.0116 (噪声真值 0.012)
两座"物理上分不开"的峰被完整拆回:峰位误差 0.3 波数以内、峰高误差千分之二、宽度误差百分之一;残差标准差 0.0116,正好贴着噪声真值 0.012——模型把信号吃干抹净,剩下的全是噪声,这是拟合可信的最硬证据。初值给得糙没关系(995 对 1000、20 对 12),但三个经验必须有:初值从图上粗读(峰位看包络顶、峰宽给半峰宽的一半量级);同参数族内初值不准没关系,峰数错了神仙难救(把两峰当初值拟一个高斯,怎么迭代都差);拟合区间别贪宽,基线没扣干净的谱只拟峰区,否则背景会骗出假峰。
三、峰数怎么定:BIC 当法官
拟合里最诱人的错误是"看见残差有鼓包就加峰"。加峰几乎必然让残差变小——参数多了总能把噪声也"解释"掉,但这不代表峰真的存在。需要一位罚参数的法官:BIC(贝叶斯信息准则),它等于样本数乘残差平方和对数加参数数乘样本数对数——残差变小让 BIC 降,参数变多让 BIC 升,两头拔河:
# 峰数选择:1、2、3 个高斯的 BIC 对决 n = len(y) def fit_bic(k): p0 = sum(([980+20*i, 0.5, 14] for i in range(k)), []) # 交错初值 lo = sum(([900, 0.0, 3] for _ in range(k)), []) # 下界 hi = sum(([1100, 2.0, 50] for _ in range(k)), []) # 上界 po, _ = curve_fit(multi_gauss, x, y, p0=p0, bounds=(lo, hi), maxfev=20000) rss = float(np.sum((y - multi_gauss(x, *po))**2)) return n*np.log(rss/n) + 3*k*np.log(n) for k in [1, 2, 3]: print(f"k={k}: BIC={fit_bic(k):.1f}")
输出:
k=1: BIC=-1271.8 k=2: BIC=-2637.1 k=3: BIC=-2625.1
BIC 越低越好。单峰 -1271.8 被远远甩开(残差太大);两峰 -2637.1 夺冠;三峰 -2625.1 反而变差 12 个点——第三个"峰"用三个参数只换来残差的微小下降,罚项不答应。BIC 的判据经验值:差 10 以上即可下结论,差 2 以内算平手。这套"残差与复杂度对账"的思路与第 3 章选 PLS 成分数同源——信息论管所有模型的选择,不分光谱还是化学计量学。
四、变式:固定线形只拟幅度
谱库比对还有一条省力岔路:峰形参数(位置、宽度)从标样谱已知,只拟各峰的幅度。幅度是线性参数,线性最小二乘直接有解,不迭代、不挑初值:
# 固定线形的幅度恢复(洛伦兹示例) def lorentz(x, n0, g): # 单位幅度洛伦兹 return g**2/((x-n0)**2 + g**2) L1, L2 = lorentz(x, 1000, 8), lorentz(x, 1060, 10) # 已知线形 yl = 0.8*L1 + 0.5*L2 + rng.normal(0, 0.012, x.size) pm, _ = curve_fit(lambda x, a1, a2: a1*L1 + a2*L2, x, yl, p0=[1, 1]) print(f"lorentz amp fitted=({pm[0]:.3f}, {pm[1]:.3f}) truth=(0.800, 0.500)")
输出:
lorentz amp fitted=(0.803, 0.498) truth=(0.800, 0.500)
幅度恢复到千分之几——这就是"解混"的雏形:混合物谱是纯组分谱的线性叠加时,各组分含量可以直接用线性最小二乘解出来,第 3 章定量模型与第 5 章掺假案例都在这个地基上施工。
⚠️ 常见坑:把解卷积当万能放大镜。拟合能把"重叠的峰"拆开,但拆不开"本来就只有一个峰"的物理事实——若两组分间距远小于半峰宽、强度又悬殊,拟合结果会高度依赖初值(两次运行给出不同拆法),参数协方差矩阵的置信区间会诚实报警。置信区间比参数本身更值得看。
本节要点回顾
- 线形先于拟合:高斯尾快、洛伦兹尾长、沃伊特兼有,选错线形拟合照样"成功"但参数有偏;
- 两峰拆解的可信证据是残差贴噪声(实验 0.0116 对 0.012),不是相关系数;
- 初值糙没关系,峰数错神仙难救,峰数交给 BIC:两峰比三峰低 12 个点,罚项说不;
- 固定线形只拟幅度退化为线性问题,无迭代无初值,这是解混的地基;
- 置信区间比点估计诚实,两组分过近时它会先报警。
峰拆开了,另一件重武器对付的是完全不同的问题:变量几百个、机理两眼一抹黑。下一节让机器学习接管,看它从数据里长出的判据能不能经受化学常识的复核。