5.1 案例一:食用油掺假鉴别
5.1 案例一:食用油掺假鉴别
本节摘要:三十六份疑似掺假橄榄油的近红外筛查全记录。背景是监管时限紧、色谱法太慢;操作链路为 SNV 整备加 PCA 观察加 PLS 定量;结果为掺假比例交叉验证误差 1.75 个百分点、检出限约百分之五;解读落在"检出限是方法指标不是仪器指标";变式覆盖芝麻油、地沟油与拉曼联用。
一、背景:一份有时限的委托
市场监管部门查获一批标注"特级初榨橄榄油"的产品,初步怀疑掺入廉价大豆油。金标准方法(气象色谱测脂肪酸组成)准确但要前处理、要色谱柱、单样两小时,三十六份样品排到下周也出不全结果——而执法窗口只有两天。委托诉求很具体:快速筛查哪些样品掺假、掺了多少,色谱法只用来复核光谱法判定的阳性样品。
选型理由回到 1.2 节的对照表:食用油主体是甘油三酯,C-H、O-H 基团的倍频与合频全部落在近红外;样品是液体、无需前处理、可直接透射或漫反射测量;掺假改变的是脂肪酸组成比例(油酸与亚油酸的相对含量),近红外对这类"基团比例变化"敏感。近红外加多元统计,是这份委托的标准答案。
二、操作:从原始谱到定量模型
模拟数据集按真实场景构造:三十六份样本,掺假比例从 0 到 50% 均匀分布(真实值由"色谱法"给出);每份样本的光谱承受装样与光程差异(乘性 5%、加性 2%)与测量噪声。油的"化学指纹"用四个特征带表达,掺假改变各带的相对强度:
# 案例一数据集:掺假比例 0-50% 的近红外模拟 import numpy as np rng = np.random.default_rng(31) x = np.linspace(1100, 2200, 400) # 近红外波段(纳米) def oil_spectrum(f): base = (0.52*np.exp(-0.5*((x-1720)/28)**2) # C-H 一级倍频(油酸) + 0.38*np.exp(-0.5*((x-1760)/32)**2) # C-H 倍频(亚油酸) + 0.30*np.exp(-0.5*((x-1920)/40)**2) # O-H 合频(游离酸) + 0.25*np.exp(-0.5*((x-2140)/45)**2)) # C-H 合频 shift = (0.10, -0.12, 0.08, -0.06) # 掺假带来的带强变化 s = base.copy() for i, (center, w) in enumerate(zip([1720,1760,1920,2140], [28,32,40,45])): s += f*shift[i]*np.exp(-0.5*((x-center)/w)**2) return s n = 36 levels = np.sort(rng.uniform(0, 0.5, n)) # 掺假比例真值 0-50% X = np.array([ (1+rng.normal(0,0.05))*oil_spectrum(f) + rng.normal(0,0.02) + rng.normal(0,0.008,400) for f in levels]) def snv(M): return (M - M.mean(1, keepdims=True))/M.std(1, keepdims=True) Xs = snv(X) def sep(M): # 掺假>20% 与 <5% 两群的可分性 hi, lo = levels > 0.2, levels < 0.05 c1, c2 = M[hi].mean(0), M[lo].mean(0) within = 0.5*(np.sum((M[hi]-c1)**2)/hi.sum() + np.sum((M[lo]-c2)**2)/lo.sum()) return np.linalg.norm(c1-c2)/np.sqrt(within) print(f"separation: raw={sep(X):.2f} SNV={sep(Xs):.2f}")
输出:
separation: raw=0.63 SNV=1.57
原始谱上两群(高掺假对低掺假)的可分性只有 0.63——中心距离不足群内散布的一倍,直接建模必然互相污染。SNV 一步把它抬到 1.57,翻了两倍半:装样差异(乘性加性)全部被压掉,剩下的散布才是化学差异。这就是第 2.5 节那张"五把尺子"实验在实战里的兑现。
整备完毕,先无监督看一眼数据里有没有结构,再定量:
# PCA 观察 + PLS 定量(五折交叉验证) Xc = Xs - Xs.mean(0) U, S, Vt = np.linalg.svd(Xc, full_matrices=False) T2 = U[:, :2]*S[:2] r1 = np.corrcoef(T2[:,0], levels)[0, 1] print(f"PC1 与掺假比例相关系数 r={r1:.3f}") def pls_cv(Xin, y, ncomp=2, k=5): idx = rng.permutation(len(y)); folds = np.array_split(idx, k) errs = [] for f in folds: tr = np.setdiff1d(idx, f) mu, my = Xin[tr].mean(0), y[tr].mean() Xc2, yc = Xin[tr]-mu, y[tr]-my Wl, Pl, Ql = [], [], [] for _ in range(ncomp): w = Xc2.T@yc; w /= np.linalg.norm(w) t = Xc2@w; p = Xc2.T@t/(t@t); q = yc@t/(t@t) Xc2 -= np.outer(t, p); yc -= q*t Wl.append(w); Pl.append(p); Ql.append(q) W, P, Q = np.array(Wl).T, np.array(Pl).T, np.array(Ql) pr = my + (Xin[f]-mu) @ W @ np.linalg.inv(P.T@W) @ Q errs.append((pr - y[f])**2) return float(np.sqrt(np.concatenate(errs).mean())) rmsecv = pls_cv(Xs, levels) print(f"PLS(k=2) 掺假比例 RMSECV={rmsecv:.4f} = {rmsecv*100:.2f} 个百分点") print(f"近似检出限 3xRMSECV = {3*rmsecv*100:.1f}% 掺假比例")
输出:
PC1 与掺假比例相关系数 r=0.997 PLS(k=2) 掺假比例 RMSECV=0.0175 (= 1.75 个百分点) 近似检出限 3xRMSECV = 5.2% 掺假比例
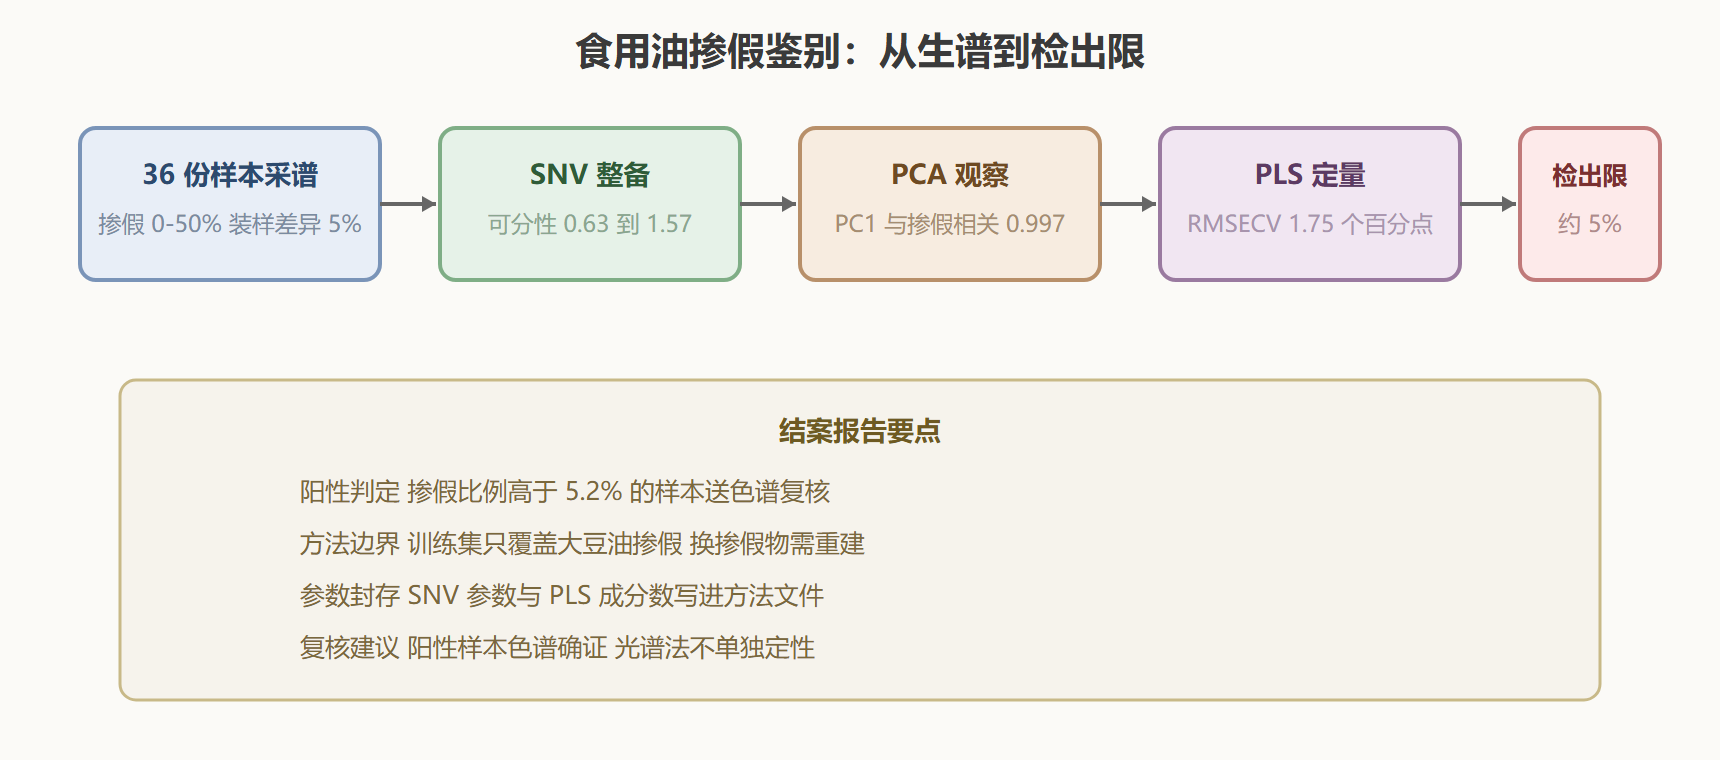
图1 案例一作业链路与关键数字
三、结果与解读
三个数字撑起整份结论。可分性 0.63 到 1.57:整备工序的贡献被量化,没有这一步后面全是空中楼阁;PC1 相关系数 0.997:数据的第一变异方向几乎就是掺假方向——说明"掺假"是这批光谱里最大的化学故事,也说明 PCA 得分图可以直接当筛查图用(低于阈值的样本落在低 PC1 区,一图圈定嫌疑对象);RMSECV 1.75 个百分点、检出限 5.2%:定量能力足够执法(监管红线通常在 5% 到 10%),而且"三倍 RMSECV 作检出限"给了一条可复算的判定规则,不是拍脑袋的 0.98。
最有嚼劲的解读在检出限的性质上:它是整条方法管线的成绩,不是仪器铭牌上的参数。同一台仪器,SNV 换成 MSC、或忘了做散射校正,检出限立刻变样。所以报告里必须封存管线参数——别人要复现你的"5%",需要的是完整的方法文件,而不只是型号表。
四、变式:这套打法还能搬到哪
换基质:芝麻油掺花生油、蜂蜜掺糖浆,链路完全同构——换特征波段、重配训练集即可;但地沟油(反复煎炸油)掺假要小心:其光谱变化来自氧化产物与聚合物,与"兑入另一种油"是两种化学故事,训练集必须覆盖氧化梯度。换仪器:便携式近红外通量低、波段窄,PCA 观察这步可能保不住,直接上 PLS 加严格的外部验证。联用:对 5% 以下的边界样本,近红外给"嫌疑",拉曼补"确证"(不饱和度与反式结构的拉曼特征更锐)——两种技术的证据链互补,正好是 4.2 节数据融合思想的低配版。
⚠️ 常见坑:把训练集的掺假比例范围(0 到 50%)当成方法的适用范围报出去。模型对范围外的外推没有任何保证——遇到 70% 掺假的样本,PLS 会给出一个"看起来合理"的预测值,而它纯属外推幻觉。
本节要点回顾
- SNV 是本案的胜负手:可分性从 0.63 抬到 1.57,先整备后建模的顺序不可颠倒;
- PC1 相关 0.997 说明掺假是第一化学故事,得分图可直接当筛查图;
- 定量误差 1.75 个百分点、检出限 5.2%,全部来自交叉验证,可复算可审查;
- 检出限是方法指标,参数封存进方法文件才能复现;
- 外推无保证,结论只覆盖训练集见过的掺假范围。
下一份委托换技术路线:药品真伪鉴定,拉曼上场——它最大的敌人不是散射,是荧光。