1.3 属性:元素的配置机制
1.3 属性:元素的配置机制
本节摘要:属性是写在开始标签里的名值对,是元素的配置项与坐标系。本节讲属性语法(普通属性、布尔属性)、全局属性与专属属性的分界线,重点剖析 class、id、style、data-* 四组高频属性的正确用法与边界。
学习目标
阅读完本节,你应当能够:
- 写出合法的属性语法并说明引号规则;
- 区分全局属性与元素专属属性;
- 说明 class 与 id 在语义、选择器行为上的差异及使用原则;
- 理解 data-* 自定义属性的设计意图与读取方式;
- 判断什么时候该用 style 内联、什么时候绝不碰它。
一个类比先立框架
如果把元素比作一类零件(比如"按钮"这类零件),属性就是零件上的参数槽:每个按钮都有"禁用状态""名称""关联表单"这几个槽位,属性值决定这个具体按钮长什么样、怎么工作。零件的类型决定有哪些槽位——槽位清单是标准随元素一起定义的,这就是"专属属性";另一些槽位是全厂通用的,比如"编号""分组""是否隐藏",装在任何零件上都有意义,这就是"全局属性"。这个工业类比不完美,但足以固定一个认知:属性不是随意贴的便签,它是标准预先定义好的接口。
语法上,属性出现在开始标签的元素名之后,形式为"名=值",多个属性用空白分隔:
<input type="email" name="user-mail" required maxlength="80">
四个属性里,type、name、maxlength 是 input 的专属属性,required 是布尔属性。布尔属性的存在本身就是声明:写了就是真,不写就是假,不需要 required="true" 这种画蛇添足。如果非要写值,规范允许写空串或与属性名相同的词,但工程惯例是裸写。常见的布尔属性还有 disabled、checked、readonly、hidden、autofocus、multiple。
全局属性清单速览
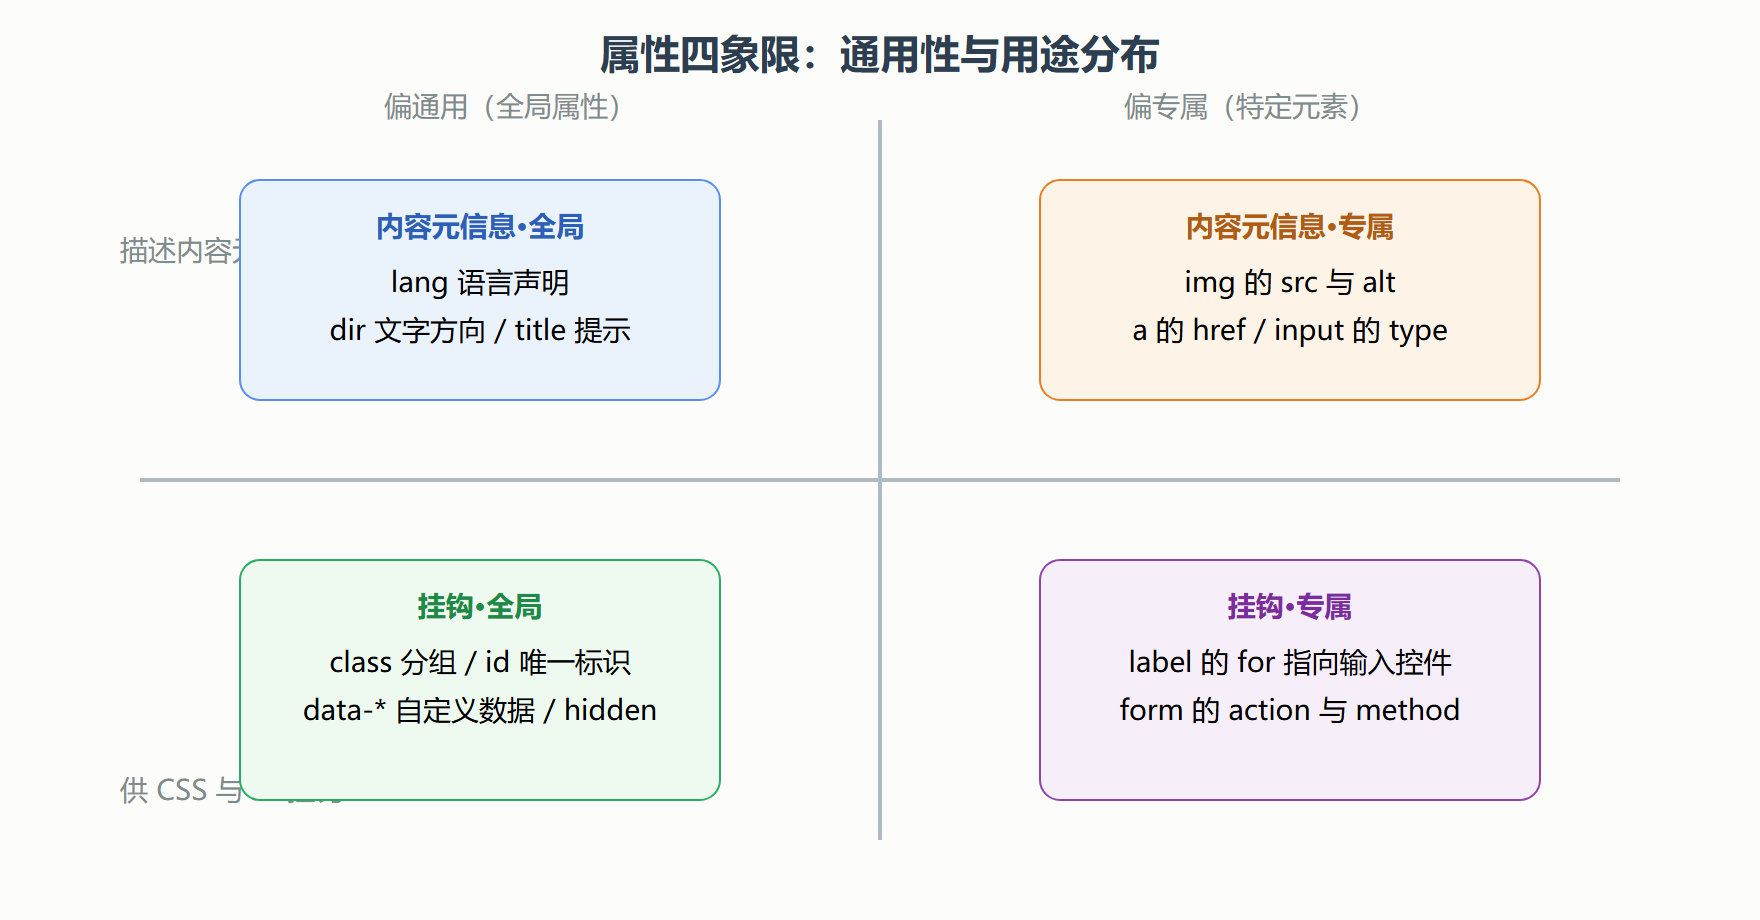
全局属性可以出现在任何元素上,常用的有这些:id、class、style、title(悬停提示)、hidden(从渲染中移除,但不同于 display:none 的语义化表达)、tabindex(聚焦顺序,第 4 章可访问性详述)、lang(声明内容语言)、dir(文字方向)、contenteditable(可编辑)、draggable(可拖拽)、data-* 前缀族、role 与 aria-* 前缀族(无障碍语义补充)。
用一张矩阵图把"属性四象限"摆出来——横轴是通用与专属,纵轴是配置内容还是建立挂钩:
class 与 id:分寸在哪里
这两个是最常用的全局属性,也最容易用坏。规范层面的区别一句话说完:id 在文档内必须唯一,class 不必。由此派生出行为差异:URL 片段只能跳到 id(比如页面内目录跳转);CSS 里 id 选择器的优先级高于 class;JavaScript 的 getElementById 是 O(1) 查找,按 class 查找则返回集合。
工程上的分寸感更重要。我的原则是:class 用于样式与组件分组,id 用于跳转锚点、表单关联和 label 指向,尽量不用 id 写样式。原因有三:id 选择器优先级过高,之后想覆盖样式只能靠更多 id 或强制手段,样式体系会越写越僵;id 唯一性在组件复用场景是负担,同一个组件渲染两次,第二个的 id 就违规了;团队协作时 id 撞名比 class 撞名难排查得多。
<!-- class 做样式挂钩,id 只做锚点 --> <style> .card { border: 1px solid #ccc; padding: 12px; } .card--featured { border-color: #e67e22; } </style> <h2 id="pricing">价格方案</h2> <div class="card">基础版</div> <div class="card card--featured">专业版</div>
class 的多个值用空格分隔,一个元素可以同时属于多个分组,这是 BEM 等命名方法论的基础(第 3 章还会回来)。id 的值要求整个文档不重复,且至少一个字符、不含空白。
data-*:把数据挂在元素上
HTML5 之前,开发者把自定义数据塞进各种歪门属性(比如 class 里编码状态信息),既不合法也不可靠。HTML5 正式开放了 data-* 前缀:任何以 data- 开头的属性都合法,值的含义完全由页面自己的脚本定义。设计意图是给 JavaScript 提供一个标准的"随元素携带数据"的通道。
<ul> <li data-user-id="1024" data-role="admin">张工</li> <li data-user-id="2048" data-role="viewer">李设计</li> </ul> <script> const li = document.querySelector('li'); console.log(li.dataset.userId); // 1024 console.log(li.dataset.role); // admin </script>
读取时走 dataset 接口,属性名去掉 data- 前缀并转成驼峰。注意 data-* 里的连字符转驼峰的规则:data-user-id 对应 dataset.userId。它的定位是"与该元素绑定的少量展示层数据",不是通用数据库——大量结构化数据应该由脚本自行请求和管理,硬塞进属性会让 HTML 臃肿且难维护。
style 内联与 title 提示
style 属性把 CSS 声明直接写在元素上,优先级极高(仅次于强制优先)。它有合理场景:一次性覆写、脚本动态计算后的像素值、邮件模板这类无法引用样式表的环境。除此之外,我建议把它当禁区:内联样式无法被样式表统一管理,无法响应媒体查询,复用为零。第 3 章会给出更完整的取舍框架,这里先立规矩——凡是"第二个元素也需要同样效果"的样式,就不该留在 style 属性里。
title 属性提供悬停提示,浏览器原生渲染成小气泡。它看似方便,但可访问性支持参差不齐(触屏设备根本没有悬停),关键信息不要只放在 title 里。lang 属性值得多说一句:它在根元素上声明整页语言(如 zh-CN),也可以在任何子元素上声明局部语言,屏幕阅读器据此切换发音引擎,搜索引擎据此判断受众,这是成本最低的可访问性实践之一。
动手实验:五个属性观察
属性的行为靠观察建立直觉最快。下面这份文档把本节的关键点都装进去了,存成文件打开,对照注释逐条验证:
<!DOCTYPE html> <html lang="zh-CN"> <head> <meta charset="UTF-8"> <title>属性观察实验</title> </head> <body> <!-- 布尔属性:裸写即生效,试试删掉 disabled 再刷新 --> <button disabled>我被禁用了,点不动</button> <!-- title:鼠标悬停一秒看提示气泡;手机上没有悬停 --> <p title="这是一段补充说明">把鼠标停在我身上。</p> <!-- lang 局部声明:读屏软件会切换发音引擎 --> <p>中文段落里夹一句 <span lang="en">English sentence</span>。</p> <!-- hidden:不渲染,但还在 DOM 里 --> <p hidden>你在页面上看不到我,但查看源码能找到。</p> <!-- data-*:配合脚本读取 --> <p id="probe" data-state="ready" data-retry-count="3">看我身上的数据</p> <script> const el = document.getElementById('probe'); console.log(el.dataset.state, el.dataset.retryCount); </script> </body> </html>
五个观察对应五个概念:布尔属性的"存在即真";title 的悬停依赖;lang 的局部生效;hidden 与样式隐藏的差异;dataset 的连字符转驼峰。每个观察都改一改再刷新,印象会比读十遍文字深。
常见属性误用清单
工程评审里高频出现的属性问题,整理成一张负面清单:
| 误用 | 后果 | 正确做法 |
|---|---|---|
| 用 id 写样式 | 优先级过高难覆盖,复用为零 | class 做样式挂钩 |
| style 里写可复用样式 | 无法统一管理、无法媒体查询 | 进样式表 |
| 自造属性存数据 | 不合法,工具可能丢弃 | data-* 前缀 |
| required="false" | 布尔属性仍为真 | 删除属性表达假 |
| title 放关键信息 | 触屏与读屏支持差 | 写进正文或标签 |
| id 复制进模板循环 | 文档内重复,锚点错乱 | 循环内容只用 class |
第二行值得展开:required="false" 是新人最经典的坑——布尔属性的"值"不参与判断,属性存在本身就代表真。想表达"条件性必填",正确做法是由脚本动态增删这个属性,而不是改它的值。
无障碍属性一瞥
role 与 aria-* 系列全局属性值得单独点名。它们不是 HTML 核心语法,而是来自 W3C 的 ARIA 规范,用来给元素补充语义——比如把一个 div 声明成对话框(role 值为 dialog)、给图标按钮补上可访问名称。本册第 4 章可访问性一节会系统讲它,这里先立一条最重要的原则:原生元素能表达的语义,不要用 ARIA 重造。button 天生就是按钮,键盘焦点、点击触发、禁用状态全部内置;一个加了 role 值为 button 的 div,则要自己补焦点管理、键盘监听、状态切换,补漏一项就是可访问性缺陷。ARIA 的定位是"语义补丁",不是"语义替身"。
属性值的引号与大小写
语法细节上还有两处规范态度值得明确。引号规则:属性值可以用双引号、单引号或不加引号,但不加引号的值不能含空格、引号、等号等特殊字符。工程惯例一律加双引号,省下的字节与引入的歧义完全不成比例——尤其当代码经过模板引擎拼接时,无引号属性是注入类缺陷的高发区。大小写规则:元素名与属性名在 HTML 里不区分大小写(写成 INPUT 或 input 都合法),但属性值大多区分; XHTML 时代要求全小写,HTML5 沿用了小写惯例。今天主流的代码风格工具会把大写标签统一改写为小写,新代码保持小写即可,见到老项目里的大写标签知道它并不"违法"就行。
布尔属性还有一个易被忽略的细节:它的"假"只能靠缺席表达,于是"动态取消一个布尔属性"的正确操作是移除整个属性节点,而不是把值改成空串。脚本里对应的方法是 removeAttribute——写成 setAttribute 加空串,元素依然处于"真"的状态。这个细节在表单禁用逻辑里出过无数事故,值得记进肌肉记忆。
什么时候自定义属性会变成隐患
data-* 用得爽的时候容易越界。我见过把整段 JSON 塞进 data-config、把用户权限位编码进 data-flags 的代码,属性值膨胀到几百字符,可读性崩塌,而且属性值里的引号还需要实体转义。边界感很重要:data-* 适合携带"与该元素直接相关、体量小、用于展示逻辑"的数据——用户 id、状态标记、下标编号。凡是超过这三条的,让脚本自己管理数据,HTML 只留一个挂钩。
本节要点回顾
(属性的类别边界用得多就熟,四象限那张图适合当速查表,忘了归属时按通用与用途两轴定位。)
(再给一个练习建议:拿自己最近写过的页面,数一数 style 与自造属性的出现次数,两个数字就是规范缺口的大小。)
- 属性是标准预定义的接口:专属属性随元素定义,全局属性通用;语法为名值对,布尔属性裸写名即可。
- id 唯一、class 可重复:id 服务锚点与关联,class 服务样式分组;避免用 id 写样式。
- data- 是官方开放的数据通道*:随元素携带少量自定义数据,经 dataset 读取,名字转驼峰。
- style 内联是高危工具:一次性场景可用,可复用样式一律进样式表。
- title 提示不可依赖:触屏无悬停,关键信息要有正文表达。
- ARIA 是语义补丁不是替身:原生元素能表达的语义,不要用 role 与 aria-* 重造。
两道动手练习
练习一:把上文实验文档里按钮的 disabled 移到一段文本的段落元素上,观察哪些元素接受这个属性、哪些视若无睹;再给同一按钮换着写 disabled="false",验证它仍然为真。做完这个实验,"布尔属性存在即真"就不再是书面上的一句话。
练习二:给列表里每个条目挂上 data-index 编号,用一段短脚本在点击时把编号打印到控制台,再把其中一个条目的编号改成带连字符的复合键(比如 data-item-id),体会 dataset 转驼峰的规则。这个练习直接对应第 5 章"脚本如何读取元素携带的数据"的场景。
元素的"配置面"讲完了,下一节下沉到内容的原子层——字符,以及那些不参与渲染的元信息:实体与注释。