1.4 字符编码、实体与注释
1.4 字符编码、实体与注释
本节摘要:字符编码决定了字节如何变成文字,是乱码问题的总根源。本节讲清字符集与编码的关系、Unicode 与 UTF-8 的分工、meta charset 的工作时机、字符实体的转义场景,以及 HTML 注释的正确用法与三条禁忌。
学习目标
阅读完本节,你应当能够:
- 区分"字符集"与"编码"两个概念,解释 Unicode 与 UTF-8 的关系;
- 说明 meta charset 为什么必须放在前 1024 字节内;
- 排查并修复一例典型的乱码问题;
- 列出必须用字符实体转义的五个字符及其场景;
- 遵守注释的工程规范,知道哪些内容绝不能写进注释。
从一次乱码事故说起
设想一个场景:你把一份中文页面从旧服务器迁到新服务器,页面没动一个字,打开却全是"æ‰ä¸–"这类天书。文件还是那个文件,问题出在哪?出在"字节"与"字符"的翻译环节。磁盘上的任何文字都以字节存储,浏览器读到的只是字节流;把字节翻译成字符需要一张对照表,这张表就是编码。文件按 UTF-8 保存,浏览器却按别的编码解读(服务器返回的声明变了),翻译全错,天书出炉。
三个角色要先分清。字符集是一个约定好的符号集合,比如"拉丁字母表加数字加标点"或 Unicode 收录的一百多万个字符;编码是把字符映射成字节的具体方案。Unicode 是字符集,UTF-8、UTF-16 是它的两种编码方案。UTF-8 的聪明之处在于变长:ASCII 字符占一字节,汉字通常占三字节,越常用的越短,且与老系统天然兼容——这是它成为 Web 事实标准的原因。今天 Web 上百分之九十几的页面用 UTF-8,新项目没有理由再选别的。
meta charset:一行声明的时机学
浏览器解析 HTML 是流式的:一边下载一边解析,遇到文本就要立刻决定按什么编码解读。如果编码声明写在文档末尾,前面几千字节的文本可能已经被错误解码了。所以标准规定:编码声明必须出现在文档前 1024 字节内,实践中就放在 head 的第一个子元素位置。
<!DOCTYPE html> <html lang="zh-CN"> <head> <meta charset="UTF-8"> <title>编码声明永远第一个出场</title> </head> <body> <p>你好,世界。</p> </body> </html>
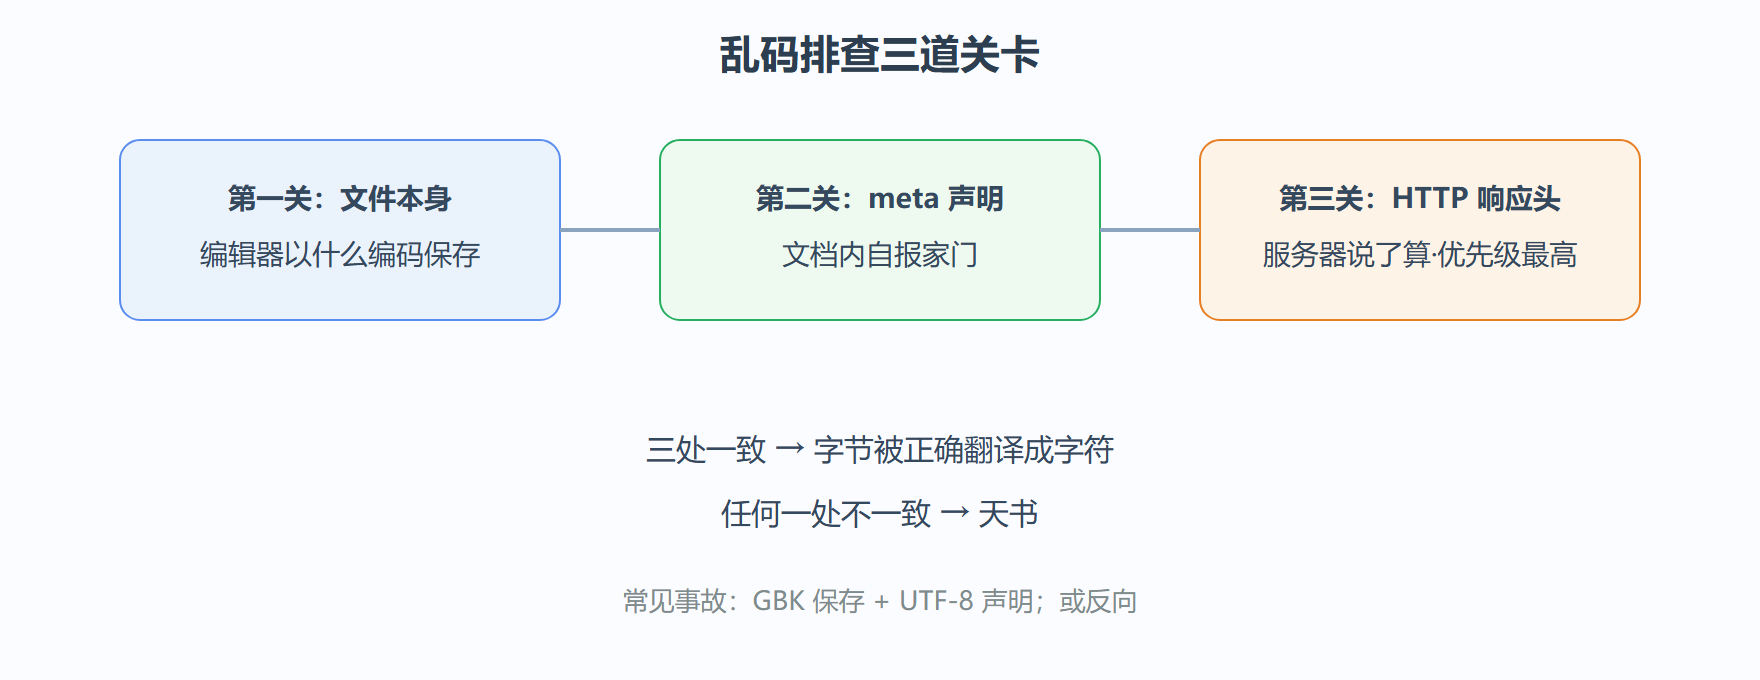
另一个同样常见的坑在保存环节:声明写了 UTF-8,编辑器却按本地编码(如 GBK)保存文件。浏览器忠实按 UTF-8 解读 GBK 的字节,照样乱码。所以乱码排查的固定三步是:确认文件的实际保存编码、确认 meta 声明、确认服务器返回的 HTTP 响应头里的编码声明。三处一致,乱码必除。优先级上,HTTP 头高于 meta 标签——本地打开文件时没有 HTTP 头,meta 是唯一依据,这就是为什么两个位置都要管。
字符实体:语法的逃生通道
HTML 语法把尖括号等字符征用为语法符号,那想在正文里原样显示这些字符怎么办?答案是字符实体(character reference):以和号开头、分号结尾的转义写法。必须掌握的五个:
| 想显示的字符 | 实体写法 | 典型场景 |
|---|---|---|
| 小于号 < | < |
教程里展示代码 |
| 大于号 > | > |
同上 |
| 和号 & | & |
URL 参数正文展示 |
| 双引号 " | " |
属性值内嵌套引号 |
| 不换行空格 | |
连续空格、防断行 |
前四个是硬需求——不转义轻则显示错乱,重则把用户内容变成可执行的标签(第 5 章安全节的 XSS 入口就在这里)。 则要克制:它产生的空格不会被折叠,但也被屏幕阅读器读出来、影响换行策略,拿它做缩进或间距是把排版问题用字符解决,正确工具是 CSS 的间距属性。此外还有 ©(版权符)、—(长破折)这类命名实体可用,但直接输入字符本身(配合 UTF-8)同样合法,现代项目里两种写法并存,团队统一即可。
<p>在 HTML 中写 <code>&lt;</code> 才能显示出 < 号。</p>
注释:写给人看的元信息
注释语法从开始到结束:<!-- 中间是注释内容 -->。解析器把注释整段跳过,不进渲染,但会进入 DOM——在浏览器里查看源代码或元素面板能看到。这条特性衍生出注释的第一条禁忌:不要放任何敏感信息。密钥、内部地址、 TODO 背后的商业逻辑、对用户的吐槽,全都是公开信息。网页不是你的私人笔记本。
第二条禁忌:不要用注释做版本控制。"这段是旧方案,先注释掉备用"——旧方案在 Git 历史里躺着呢,注释掉的死代码只会腐化。第三条禁忌:不要用注释复述代码。<!-- 页脚 --> 标在 footer 标签上方属于噪音;第 2 章讲完语义化后你会看到,好的结构自己会说话,注释只该解释"为什么这么做"这类源码表达不了的信息。
<!-- 结账按钮文案改成了"去支付",因为 A/B 实验显示转化率高 3%,数据见实验平台编号 1204 --> <button class="checkout">去支付</button> <!-- 反例:以下注释是噪音或隐患 --> <!-- <button>立即购买</button> 旧按钮,别删 --> <!-- 密钥是 sk-live-xxxx,测试用 --> <!-- 页脚开始 --> <footer>...</footer>
条件注释是历史遗留:老 IE 时代的 <!--[if IE]> 语法能让特定浏览器读入内容,IE9 之后已废弃,新代码不要出现,见到老代码里的它知道来历即可。
动手复现一次乱码
读代码块体会不到乱码的"痛",值得亲手做一次。任选一个文本编辑器,新建文件输入一段带中文的 HTML,声明写 UTF-8;保存时故意选择一种旧式本地编码(Windows 上常见 GBK 系,macOS 上可找 Latin 系列);再用浏览器打开。你会看到中文部分全部变成乱码,而尖括号标签部分完好——因为那些字节恰好落在两种编码的重叠区。
<!DOCTYPE html> <html lang="zh-CN"> <head> <meta charset="UTF-8"> <title>乱码复现</title> </head> <body> <p>标签正常显示,但这行中文会变天书。</p> </body> </html>
修复时先检查编辑器右下角的编码指示(多数编辑器会显示当前编码),切回 UTF-8 重新保存,刷新即愈。这个五分钟实验的价值在于建立条件反射:以后见到乱码,第一反应是查三道关卡,而不是怀疑字体、浏览器或"代码写错了"。
编码常识的几个高频问答
问:UTF-8 和 Unicode 到底什么关系,能用一句话说清吗?
能。Unicode 是一本字典,给每个字符编了号(汉字"一"的编号是 U+4E00);UTF-8 是一种把编号写成字节的方法。同一个编号还有别的写法(UTF-16、UTF-32),就像同一个金额可以有人民币和美元两种记账方式。Web 世界选了 UTF-8,因为它对 ASCII 的高效兼容和对多字节的自同步设计。
问:BOM 是什么,要不要加?
BOM(字节顺序标记)是文件开头三个特殊字节(写作 U+FEFF),用来声明"本文件是 UTF-8"。听起来有用,实际是麻烦制造者:有些解析器会把 BOM 当成正文第一个字符,导致 DOCTYPE 不在文档首位。Web 场景的惯例是不加 BOM,编辑器里选择"UTF-8(无 BOM)"。
问:一个汉字到底占几个字节?
UTF-8 里常用汉字三字节,生僻字可能四字节。但注意"字节"是存储概念,"字符数"是用户概念——输入框限制"20 个字"应该按字符数(脚本里的长度单位之一)校验而不是按字节,这是表单设计里常被搞混的一对量。
问:URL 里的中文需要转码吗?
需要,但通常工具替你做了。URL 规范要求地址里只能出现有限的安全字符,中文会被百分号编码成"百分之加十六进制"的形式。你在地址栏看到的汉字是浏览器友好显示,真实传输的是编码后的形式。这段知识与第 4 章 SEO 的 URL 规范化、第 5 章表单提交都会再次交汇。
空白处理与源码排版
字符层面还有一组不起眼但常考的知识:空白字符的处理。HTML 源码里的空格、制表符、换行,在渲染时会被折叠成一个空格——这是"空白折叠"规则。它带来三个日常现象:源码里连续敲十个空格,页面上只有一个;行内元素之间源码换行,页面上出现一个约一个空格宽的缝隙(第 3 章布局时这是行内排版的经典缝隙问题);想在页面上呈现"多空格"反而要用实体来写。
例外区域有三处:pre 元素内部原样保留(所以它适合展示代码块);textarea 里的初始内容保留;实体写法的不换行空格不被折叠。理解规则之后,源码排版就自由了:你可以放心地用换行和缩进组织代码而不影响渲染,唯一要留意的是行内元素之间的"意外空格"——解决办法第 3 章给。
还有一个容易被忽略的角落:表单提交时的编码。form 元素有一个几乎没人主动设置的属性 accept-charset,它声明"服务器按什么编码解读我提交的数据"。绝大多数场景下浏览器跟随文档编码,两者一致时无需干预;但在"UTF-8 页面把数据提交给一台只认旧式编码的老网关"这类遗留集成里,显式声明 accept-charset 能避免提交内容在服务端变成乱码。此外,脚本向服务器发送数据时(现代接口普遍要求 UTF-8),请求头的编码声明同样由发送方负责——字符编码的责任链从"文件保存"一路延伸到"数据往返",每一环都可能成为乱码的事故点,排查思路仍然是那三道关卡,只是关卡的位置换了。
⚠️ 常见坑:把源码缩进当成页面缩进。想让段落首行缩进两个字,正确做法是 CSS 的首行缩进属性;在源码里敲空格既无效(会被折叠)又脏。
本节要点回顾
- 字符集与编码是两回事:Unicode 是字符集,UTF-8 是编码方案;变长设计让它成为 Web 标准。
- meta charset 必须在前 1024 字节:流式解析等不到文档末尾,放 head 第一个。
- 乱码三道关卡:文件保存编码、meta 声明、HTTP 响应头,三处一致才干净;HTTP 头优先级最高。
- 五个必会实体:
<>&" ,前四个关乎语法安全, 用要克制。 - 注释进 DOM 即公开:敏感信息、死代码、复述性噪音都别写,注释只解释"为什么"。
- 空白折叠是默认规则:pre、textarea、实体空格是三个例外区,缩进交给 CSS。
收尾练习
练习一:找一个你写过的旧页面,检查它的编码声明位置是否在前几个标签内,再用编辑器确认文件实际保存编码,三道关卡逐一过关。绝大多数"祖传乱码页面"都能在这个流程里结案。
练习二:写一页"实体展示页",用实体写法呈现五个必会字符各一次,再故意漏掉分号写一个(比如只写和号加三个字母),观察浏览器是否仍然解析——你会看到没有分号的命名实体系出同名的仍会被解析,而拼错的会原样显示。这个细节解释了为什么规范建议实体一律带分号:省略分号的容错依赖历史回退规则,行为在不同上下文里并不总是一致。
第 1 章到此收官。语法、属性、字符三层地基打完,下一章开始往上盖楼:一份 HTML 文档应当如何对内容建模——语义化标签与文档结构。