1.3 AI 核心概念初步了解
1.3 AI 核心概念初步了解
本节摘要:聊 AI 绕不开几组词:模型、数据、训练、推理、提示词,以及机器学习、深度学习、自然语言处理、计算机视觉、大模型这五大板块。本节用一个"请新员工"的类比把概念全部串起来,再带你看懂五大板块各自解决什么问题,让你以后读任何 AI 文章、产品介绍都不发怵。
你能学到什么
阅读完本节,你应当能够:
- 用生活化方式解释数据、训练、模型、推理、提示词
- 说清"训练"与"推理"的区别,以及它和成本的关系
- 说出机器学习、深度学习、NLP、CV、大模型各自的分工与包含关系
- 理解大模型为什么"大"、为什么能力全面
- 用这套概念框架看懂 AI 新闻与产品介绍
一、问题与直觉
看 AI 新闻时,"模型""训练""推理""大模型"满天飞,每个字都认识,连起来看不懂。其实这些概念可以套进一个很熟悉的场景:公司请一个新员工。数据是培训资料,训练是培训过程,模型是培训完的员工,推理是员工上班干活,提示词是你给员工下的指令。一个类比,概念全通。
这套类比还有个好处:它顺带解释了 AI 行业的分工。有人做培训(训练模型),有人招培训好的员工来用(调用模型),有人专门研究怎么给员工下指令(提示词工程)。普通人站在最后一环,但看清整条链路,用起来才心里有底。
二、核心原理
2.1 核心概念之间的关系
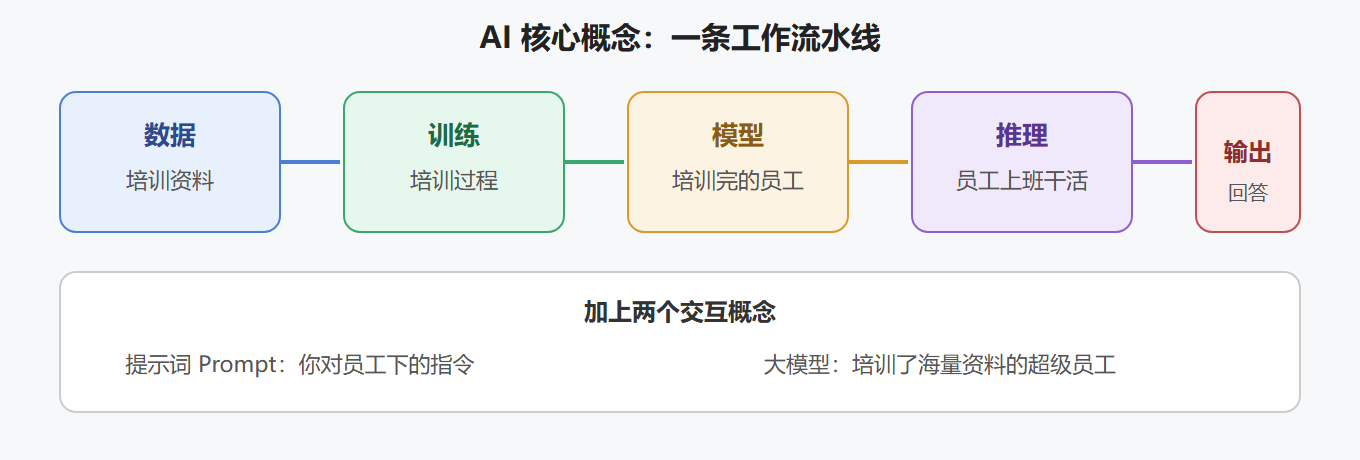
2.2 概念速查表
| 概念 | 生活类比 | 一句话解释 |
|---|---|---|
| 数据 | 培训资料 | 教 AI 的例子与素材 |
| 训练 | 培训过程 | 让 AI 从数据里学规律 |
| 模型 | 培训完的员工 | 学完规律、能回答问题的 AI |
| 推理 | 员工干活 | 用学到的规律回答新问题 |
| 提示词 | 给员工的指令 | 告诉 AI 你要什么、怎么答 |
| 大模型 | 全能超级员工 | 参数量巨大、见多识广的模型 |
2.3 训练与推理的区别
训练是一次性的大工程——动辄用几千块 GPU 连跑数月,读掉互联网量级的文本,耗时耗钱耗算力;推理是日常的轻量使用——你打一句话,它算几秒就回。这就是为什么"造一个模型"贵到只有少数公司做得起,而"用现成模型"便宜到人人可用:你用的是别人花大钱培训好的员工。
⚠️ 常见误区:把"训练"当"使用"。你每天和对话式 AI 聊天,它在"推理",不是在"训练"——你的对话默认不会变成它的教材。普通人只参与推理,不参与训练,理解这点能避免很多关于"AI 在偷学我"的误解(隐私问题的真实机制在第 5 章细讲)。
2.4 五大板块:AI 技术地图
概念之外,还要知道 AI 里的几个"部门"各管什么。它们的关系是层层嵌套:机器学习是 AI 的核心方法,深度学习是机器学习的一个分支,NLP 和 CV 是两个主要应用方向,大模型则是深度学习在语言方向的集大成者。
| 板块 | 管什么 | 典型应用 | 生活类比 |
|---|---|---|---|
| 机器学习 | 让机器从数据学规律的总方法 | 商品推荐、信用评分、销量预测 | 教学法总纲 |
| 深度学习 | 用多层神经网络自动学特征 | 人脸识别、语音识别 | 教学法里的高阶套路 |
| 自然语言处理(NLP) | 让机器理解和生成语言 | 翻译、摘要、智能客服、聊天机器人 | 外语系 |
| 计算机视觉(CV) | 让机器"看懂"图像视频 | 人脸识别、目标检测、自动驾驶感知 | 美术系 |
| 大模型 | 超大规模神经网络,通吃多任务 | 对话、写作、编程、画图 | 进修了全部课程的超级员工 |
展开说说每个板块的"体感":
- 机器学习是总纲。它不再让工程师手写规则,而是把大量例子喂给算法,让算法自己总结规律。电商"猜你喜欢"就是典型:你的浏览和购买记录是例子,算法总结出"买尿布的人常买啤酒"这类规律,再拿规律做推荐。
- 深度学习是机器学习的升级版。传统方法需要人先告诉机器"看哪些特征",深度学习让多层神经网络自己从原始数据里逐层提炼特征——从像素到边缘、从边缘到形状、从形状到"这是一只猫"。2010 年代 AI 的爆发主要靠它。
- 自然语言处理负责语言。你用的机器翻译、语音助手听懂你说的话、客服机器人读懂你的问题、AI 写总结,都属 NLP。大模型正是 NLP 方向近年的巅峰产物。
- 计算机视觉负责图像。手机解锁时的人脸识别、停车场的车牌识别、自动驾驶识别行人和红绿灯,都是 CV 在干活。它的难点和 NLP 不同:图像信息量大、光照角度变化多。
- 大模型为什么"大"?三个维度:参数多——内部可调节的"旋钮"数以千亿计;数据多——训练素材几乎读完了公开互联网的文本;算力大——训练成本高到以千万美元计。结果是这位"超级员工"见过足够多的世面,写代码、翻译、写诗、做摘要样样能上手,不再像以前的 AI 一样"一岗一专"。
💡 关键直觉:大模型的意义在于把 AI 从"专用工具"变成了"通用助手"。以前每个任务要单独训一个模型,现在一个模型通吃多数文字任务——这也是为什么这一轮 AI 热潮波及的是所有人,而不只是技术行业。
三、工程实践要点
3.1 用这套概念读 AI 新闻
看到"某公司发布新模型",翻译成"某公司培训了一个新员工";看到"模型在某测试中得分提升",就是"新员工考试更好了";看到"开源模型",就是"这位员工的培训笔记公开了,别人可以免费雇";看到"参数量再创新高",就是"这位员工脑容量更大"。概念一套,新闻秒懂。
3.2 提示词为什么重要
同样雇一个员工,指令下得好不好,结果天差地别。"写篇文章"和"用三段式写一篇 800 字、面向新手的 AI 入门文章,每段带一个例子"——后者得到的质量完全不同。提示词就是你给 AI 的指令质量,这是普通人最值得练的技能,第 2 章会专门训练。
3.3 遇到新概念的处理方法
AI 领域新词层出不穷:Token、Embedding、微调、智能体……遇到不懂的词,一个通用方法:把它翻译成"员工管理"的语言——Token 是员工阅读时的"字词单位",微调是老员工进修本行业务,Embedding 是员工理解语言的底层方式,智能体(Agent)是会主动拆解任务、调用工具干活的员工。类比法能帮你快速抓住八成含义,剩下两成等真用到再深究。
3.4 三个高频问题
问题一:机器学习、深度学习、人工智能是一个东西吗? 不是,是层层包含:人工智能是最大概念(让机器表现智能的一切努力),机器学习是当前主流方法(从数据学规律),深度学习是机器学习的一个分支(多层神经网络)。日常语境里三者常混用,但你心里要有层次。
问题二:大模型会说错话,是"它没学好"吗? 不全是。它生成回答的方式是"预测下一个最可能的词",不是查数据库。资料里没有的、有争议的,它也可能一本正经地编——这叫"幻觉"。所以 AI 的回答要当"实习生初稿"用,重要信息必须核实。
问题三:我该五个板块都学吗? 不用。概念层面五个都认识(本节已达标),应用层面跟着需求走:日常提效主用大模型对话产品,做图像相关的工作再了解 CV 工具,想入行开发再系统学机器学习。
3.5 概念拼图自测
用下面这组判断题检验概念是否真的通了,答案都在本节正文里:
| 陈述 | 对错 | 考的概念 |
|---|---|---|
| 我和 AI 聊天时,它在被我"训练" | 错 | 训练与推理的区别 |
| 深度学习是机器学习的一个分支 | 对 | 三层包含关系 |
| 大模型参数越多,就一定越可靠 | 错 | 幻觉与可靠性无关参数量 |
| 提示词属于"推理阶段"的技能 | 对 | 提示词是使用侧的指令 |
| 计算机视觉和 NLP 是同一个方向 | 错 | 一个管图像、一个管语言 |
| 预训练在先,微调在后 | 对 | 先通识教育,再岗前培训 |
再讲一个容易被忽略的细节:"模型"这个词的两种用法。日常说"某产品换了新模型",指的是背后整套神经网络;新闻说"模型参数规模",指的是网络里可调旋钮的数量级。听到"模型"先分辨说的是"员工本人"还是"员工的脑容量",理解就不会跑偏。另外,"开源模型"不等于"免费随便用"——开源指训练方法和权重公开,商用仍可能受许可协议限制。这类细微差别不影响入门,但提前知道,能让你在讨论中显得更专业。
最后补一个时间维度的概念:预训练与微调。大模型的培养分两步——先做"预训练",读遍互联网级别的通用语料,练成见多识广的底子;再做"微调",用特定领域的高质量数据进修,比如针对医疗问答、代码补全做定向强化。放到员工类比里:先上四年通识大学,再入职岗前培训。你付钱使用的,是"大学加培训"都完成的成品;如果你所在的公司拿内部资料再教它一遍,那就是"企业内训",属于定制化应用——第 4 章讲的就是这件事。理解这两个词,你就明白为什么同一个底座模型能派生出那么多不同版本的产品。
核心回顾
- 要点一:数据是资料、训练是培训、模型是员工、推理是干活、提示词是指令
- 要点二:训练是一次性大工程,推理是日常轻量使用——所以用模型便宜、造模型昂贵
- 要点三:五大板块分工——机器学习是总纲,深度学习是高阶方法,NLP 管语言,CV 管图像,大模型是通吃多任务的超级员工
- 要点四:大模型之"大"在参数多、数据多、算力大,价值在于把 AI 从专用工具变成通用助手
- 要点五:AI、机器学习、深度学习是层层包含关系,不是同义词
- 要点六:AI 会"幻觉",回答要当初稿用,重要信息必须核实
- 要点七:新概念一律先翻译成"员工管理"语言,抓住八成含义
- 要点八:普通人最值得练的技能是写提示词,而不是训练模型
认知框架建好了,第 2 章开始动手——上手 AI 工具,解决你的真实问题。带一句忠告出发:概念不是用来背的,是用来挂新知识的钩子——后面五章每出现一个新词,回来查一眼速查表,这个框架就会越来越牢。