3.1 机器学习基础概念
3.1 机器学习基础概念
本节摘要:机器学习(Machine Learning)是 AI 的核心——它不是"写规则",而是"从例子中学规则"。本节用生活化方式讲清机器学习的本质、三种学习方式(监督/无监督/强化),以及"数据-训练-模型"的完整流程。
本节导读
阅读完本节,你应当能够:
- 用一句话解释机器学习的本质
- 区分监督学习、无监督学习与强化学习
- 理解"数据-训练-模型"的流程
- 举出三种学习方式的日常例子
- 理解为什么"数据越多模型越强"
一、问题与直觉
传统程序是"人写规则,机器执行":人告诉机器"图片里出现红色圆球就是苹果"。但有些规则人自己也说不清——"这张照片美不美""这段话是好评还是差评"。机器学习换了个思路:人给例子,机器自己找规则。喂它一万张标好"苹果/非苹果"的图,它自己总结出"什么样算苹果"。
这个转向是理解一切 AI 的分水岭。规则可写的问题(计算工资、校验身份证号),传统软件至今仍是首选,又快又准;规则难写的问题(认出猫、听懂方言、判断 Spam),才轮到机器学习出场。判断"该不该用 AI",第一问就是:这个问题的规则,人能明确写出来吗?
二、核心原理
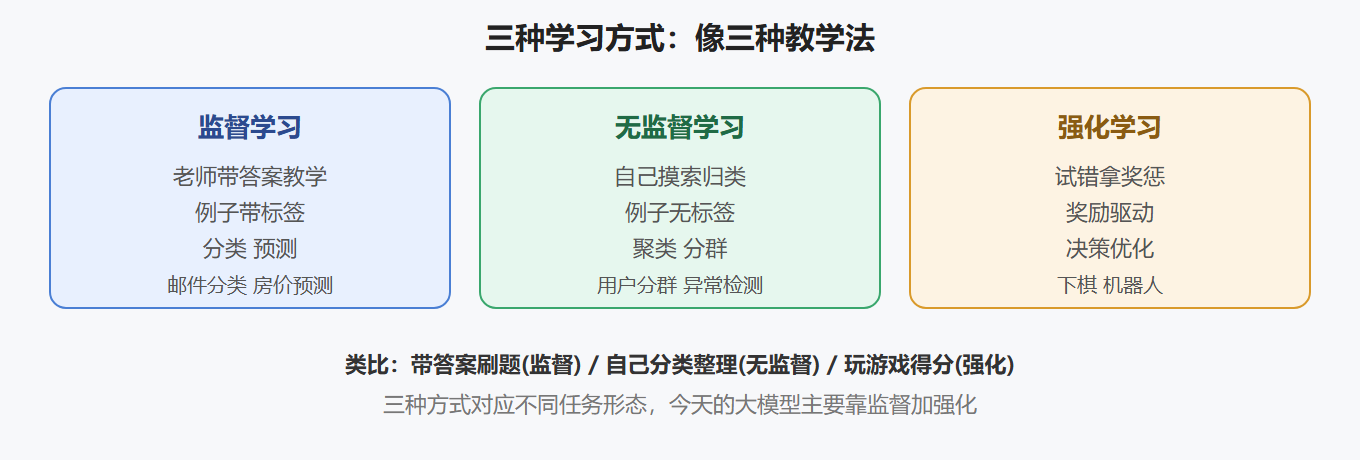
2.1 三种学习方式
2.2 机器学习的完整流程
数据 → 训练 → 评估 → 部署 → 反馈 → 再训练,这是一个持续循环。这也是"AI 越用越准"的原因——每次使用都在积累新数据。
三、工程实践要点
3.1 三种方式速查表
| 学习方式 | 教学类比 | 输入 | 典型任务 |
|---|---|---|---|
| 监督学习 | 带答案刷题 | 例子+标签 | 分类、预测 |
| 无监督学习 | 自己整理分类 | 只有例子 | 分群、找异常 |
| 强化学习 | 玩游戏得分 | 环境+奖惩 | 决策、控制 |
3.2 为什么"数据越多越强"
机器学习的本质是从数据里找统计规律。数据越多样、越大量,找出的规律越可靠——就像见的人多了,判断人更准。这也是大厂抢数据的根本原因:数据是 AI 的"燃料"。
💡 关键直觉:机器学习不是"数据越多一定越好",而是"数据质量决定模型上限"。一万条错误标注的数据,不如一千条准确标注的数据。
3.3 普通人的理解要点
- 机器学习 = 从例子找规律,不是写规则
- 监督学习是主流(分类、预测都用它)
- 数据质量决定模型质量
- 你每天用的推荐、翻译、识图,背后都是机器学习
⚠️ 常见误区:以为机器学习"像人一样思考"。它其实是巨大的统计模式匹配器——它不"理解"苹果,只是"识别出像苹果的特征组合"。理解这点,就不会对 AI 抱不切实际的期望。
四、三种学习方式逐个拆开
4.1 监督学习:带答案刷题
想象教小孩认水果:你指着苹果说"这是苹果,红色、圆形",指着香蕉说"黄色、弯弯的"。你给的名称就是标签。孩子看多了,就能自己认出新水果。监督学习同理:给计算机大量已标记数据(输入加正确答案),让它学会"特征与标签的关系",再拿这个关系去预测没见过的数据。
核心概念串起来:特征是描述数据的属性(水果的颜色形状、房屋的面积地段),标签是要预测的答案(水果名称、房价),模型学的是特征到标签的映射,训练是用标记数据打磨模型的过程,预测是拿模型回答新问题。
| 应用 | 输入特征 | 预测的标签 |
|---|---|---|
| 图像分类 | 图片像素 | 猫/狗/鸟 |
| 垃圾邮件检测 | 邮件文本特征 | 垃圾/正常 |
| 情感分析 | 评论文字 | 好评/差评 |
| 房价预测 | 面积、位置、卧室数 | 价格(连续值) |
| 疾病辅助诊断 | 症状与检查指标 | 患病概率 |
常见算法也认个脸:线性回归预测连续值(房价),逻辑回归做二分类(是否垃圾邮件),支持向量机擅长划分类别边界,决策树像一连串"如果是……则……"的提问,随机森林把很多棵决策树投票合并,神经网络能学最复杂的关系——深度学习的根基。
4.2 无监督学习:自己找规律
换个场景:给孩子一大堆水果但不告诉名称,只让他自己观察。他可能自己发现"这堆是圆的、那堆是长的"。无监督学习就是这样:数据没有标签,让机器自己发现数据里的模式与结构。
典型任务有四类:聚类(把相似数据自动分组,如客户分群、文档归类)、降维(把高维数据压缩到低维便于可视化,如主成分分析)、异常检测(找出显著不同的点,如欺诈识别、设备故障预警)、关联规则挖掘(发现"买 A 的人常买 B",经典案例是购物篮分析)。常用算法包括 K 均值聚类、层次聚类、主成分分析等。
监督学习像有标准答案的老师,无监督学习像自主破案的侦探——没有答案,但能从线索里挖出隐藏结构。
4.3 强化学习:奖惩出高手
训小狗握手:做对给饼干,做错没有。多次之后狗学会了。强化学习的框架是:一个智能体在环境里行动,每个动作改变环境状态,环境反馈奖励或惩罚;智能体的目标是学出一个策略,让长期累积奖励最大。
循环:智能体 --动作--> 环境 环境 --状态+奖励--> 智能体 智能体 --更新策略--> 更聪明的下一步
代表作是下围棋的 AlphaGo 和打电竞的 AlphaStar;实际应用还有机器人控制、自动驾驶决策、推荐策略优化、电力调度等资源管理问题。它难在两点:奖励函数怎么设计才不"跑偏",以及探索新招与沿用旧招之间的平衡。
💡 关键直觉:三种方式一句话分清——监督学习有答案、无监督学习没答案、强化学习靠奖惩。遇到任何 AI 应用,先问"它的学习信号是什么",归类立刻完成。
五、怎么选方法:三个判断问题
- 有没有标记数据? 有标签选监督学习;没标签想找结构选无监督学习;问题涉及连续决策与反馈选强化学习。
- 要输出什么? 输出类别用分类算法,输出数值用回归算法,输出分组用聚类,输出动作序列用强化学习。
- 数据量与质量如何? 深度学习方法吃数据,小数据场景传统算法(决策树、支持向量机)往往更稳;标签不准、数据不纯,任何算法都救不回来。
三个高频问题:
问题一:机器学习和人工智能什么关系? 机器学习是实现人工智能的主流方法,相当于"引擎与车"的关系。今天你听到的 AI 进展,九成背后是机器学习。
问题二:为什么推荐系统总"猜得挺准"? 它把你的行为(点击、停留、购买)当特征,把"你最终买了什么"当标签做监督学习,再用聚类给你分群。用的就是本节讲的方法,没有魔法。
问题三:普通人需要会写这些算法吗? 不需要,但要会"归类"——知道手头的问题属于哪类、需要什么数据。这是和 AI 从业者、和 AI 工具打交道时的通用语言,第 4 章定制化应用会直接用到。
问题四:机器学习的数据从哪来? 三条常见来源:自己积累的业务数据(销售记录、用户行为)、公开数据集(政府统计、学术数据、竞赛平台)、以及购买或合作获取的数据。对个人学习者,用公开数据集练手最方便——知名数据科学竞赛平台上就有大量真实数据集免费开放;对企业,第一方数据往往是最有价值的资产,因为只有它带着你自己业务的真实规律。
问题五:数据要多少才够? 没有固定答案,但有个经验直觉:传统算法几百到几千条样本常能出效果;深度学习通常要万级以上;大模型则是互联网级别。所以"数据不足"时,优先考虑传统方法而非硬上深度学习。
六、走一遍完整例子:预测奶茶店日销量
把本节概念串成一个具体例子。假设你是奶茶店主,想预测每天该备多少料。
第一步:定问题。 输出是数值(杯数),属于回归问题——监督学习的一种。标签是"历史每日销量"。
第二步:收集数据、想特征。 影响销量的可能因素:星期几、天气、气温、是否节假日、附近有没有活动、上月同期销量。把这些整理成表格,每一行是一天,每一列是一个特征。注意特征选择靠的是领域知识——你开店的经验在这里比算法值钱,这就是第 1 章说的"特征工程靠业务理解"。
第三步:训练。 拿过去一年的数据喂给回归算法,模型自己调整内部参数,找到"这些因素与销量之间的关系"——比如它可能发现气温每升一度销量加二十杯,雨天减三成。
第四步:评估。 留出最近一个月的数据不参与训练,专门用来考试。预测值和真实值一比,误差可接受才进入下一步;误差大就回头换特征、换算法。
第五步:使用与反馈。 每天早上输入当天条件,模型给出备料建议;晚上把真实销量记下来,成为明天的新训练数据。用得越久,数据越厚,模型越贴你的店。
这个例子覆盖了机器学习的全部关键词:特征、标签、训练、评估、预测、反馈循环。你不需要真的去写代码——多数零代码平台已经把算法封装好,你要做的是把每一步的判断做对:问题属于哪类、特征选哪些、数据从哪来、结果可不可信。
⚠️ 常见坑:一上来就纠结"用哪个算法"。实践中算法选择的差异,往往小于数据质量的差异。把特征想清楚、把数据收干净,比换十个算法都有效。
要点串联
- 要点一:机器学习是"从例子学规律",不是"人写规则"
- 要点二:三种方式——监督(带答案)、无监督(自己分)、强化(奖惩)
- 要点三:流程是"数据-训练-评估-部署-反馈"的循环
- 要点四:数据质量决定模型上限,不是越多越好
- 要点五:机器学习是统计模式匹配,不是"像人一样思考"
- 要点六:推荐、翻译、识图背后都是机器学习
- 要点七:监督学习三关键——特征、标签、模型;特征选择靠领域知识
- 要点八:完整流程走一遍(定问题、收数据、训练、评估、反馈),零代码平台已封装算法,你负责判断
机器学习是基础,下一层看深度学习——神经网络怎么"学得更深"。